
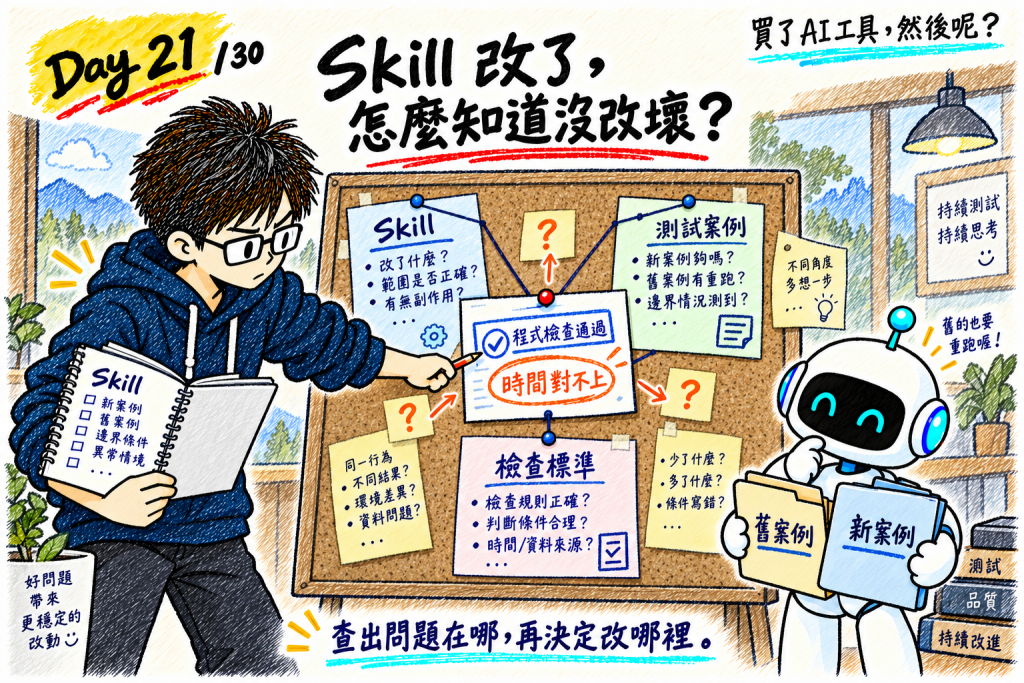
昨天,我把查核工具組搬到新的目錄,補齊路徑與啟動授權,Claude 終於能從讀取 Skill 跑到程式檢查。
但這套方法已經改了好幾版。我修過自測、補過欄位說明,也改過 plugin 的腳本路徑。每次修好,我都重跑當下卡住的那一題。那一題過了,我就往下走。
剛才那題修好了,原本會的還在嗎?
這是第三幕「方法離開作者」的第五篇(各篇對照見文末)。Day 19 把固定核對交給程式;Day 20 找出環境裡由我默默補上的依賴。
Skill 也需要驗收與維護,不能寫好 Markdown 就算完成。 今天就拿前面的通知查核方法,做一次 Eval:固定案例與預期結果,看看改版到底改善了什麼。
Anthropic 的官方 skill-creator 不只幫忙產生 SKILL.md,也安排測試、比較結果與修訂。新建 Skill 時,用同一個任務比較有、沒有 Skill;修改既有 Skill 時,保留舊版作為對照,再看結果、時間與用量,依回饋繼續調整。
對我來說,這和驗收程式很像:先約好什麼算對,遇到新問題時補案例,修完再把舊案例跑一遍。但 Claude 同一題可能每次回答不同,不能只看到一次綠燈就宣布完成。官方 skill-creator
這裡要分清楚三件事:
| 要驗什麼 | 問的是什麼 | 這次怎麼做 |
|---|---|---|
| 能不能執行 | 工具、路徑、權限是否齊全? | Day 20 已演練,本篇不重教安裝 |
| Skill 有沒有幫助 | 加入或修改方法後,成果改善了什麼? | 比較不帶 Skill、舊版與新版 |
| 有沒有改壞 | 新問題處理好了,原本正確的情境是否仍成立? | 保留舊案例一起重跑 |
前面的訂單取消案例,已留下發送端 Log 與接收端收據。我要查的是同一則通知能否確認送達,不是「這張訂單曾經有過任何一張收據」。
所以我補了一個新案例:訂單 ID 相同,收據的通知 ID 卻不同。如果 Claude 只看到有收據就寫已送達,便把另一則通知的證據拿來用了。
正解先寫進測試程式,看到回答後不改答案:
| 案例 | 發送端預期 | 接收端預期 | 為什麼保留 |
|---|---|---|---|
| 有收據,但通知 ID 不同 | confirmed | unknown | 新案例:不能拿另一則通知的收據當證明 |
| 資料完整 | confirmed | confirmed | 回歸:原本能確認的事件,仍要確認得了 |
| 缺收據 | confirmed | unknown | 回歸:缺證據時不能硬猜已送達 |
confirmed 是已有支持這項判斷的證據;unknown 是目前無法確認,不等於一定沒有送達。
我比較三種條件:不帶 Skill、Day 17 的 v1,以及 Day 20 repo 方式使用的 v2.0.2。每個條件都用同一段提示與案例,每題各跑三次,輪換條件順序,共 27 次。提示已指定結果格式,這次沒有測自然語句會不會自動觸發 Skill。
評分分開做,不採信 Claude 最後說「我查完了」:
out/result.json,把發送端、接收端狀態對照事前正解。gate.py,核對欄位、通知 ID 與來源引用格式。前一項在看答案,後一項在看結果能否接進既有程式流程,不能混成一個分數。
| 條件 | 判斷正確 | 誘餌案例誤判已送達 | 契約通過 | 平均回合/秒數/費用 |
|---|---|---|---|---|
| 不帶 Skill | 9/9 | 0/3 | 0/9 | 5.1/25.9/US$0.10 |
| v1 | 9/9 | 0/3 | 0/9 | 7.0/27.7/US$0.11 |
| v2.0.2 | 9/9 | 0/3 | 9/9 | 10.4/33.9/US$0.11 |
27 次合計 US$2.96。我的第一個預期被推翻了:不帶 Skill,也沒有被誘餌收據騙到。
這份考卷沒有量出判斷差異,不能拿它證明新版更準。但契約那一欄確實不同。比較兩者的引用寫法:不帶 Skill 是檔案位置加說明,新版只交 collect.py 產生的編號 log:3。
不帶 Skill 的引用節錄:
"data/logs.jsonl:3 (event=notify_sent, notification_id 7e746d20..., order r2-healthy-01)"

v2.0.2:
"log:3"
檢查程式會核對輸出格式、必要欄位與來源資訊,但不代表它能判斷所有證據是否合理。
前者有可核對的資訊,檢查程式卻不認這種寫法,會回傳 UNKNOWN_SOURCE_REF。0/9 不代表九次都判錯,只代表交出的引用不符合這支檢查程式的格式。
資料完整那組,不帶 Skill 與 v1 的六次結果,還被檢查程式攔下一個 CONFIRMED_WITH_MISSING_SOURCE。注意 receiver_status 是 confirmed,missing_sources 卻列了三項:
{
  "receiver_status": "confirmed",
  "missing_sources": [
    "Log server/正式環境日誌(本次未連線)",
    "/metrics 計數(notify_sent_total、dead_letter)快照",
    "本輪未執行 .NET 測試(design/design-review.md 第7點)"
  ]
}
歷史檢查程式的規則很直接:接收端填 confirmed,缺件欄就必須是空的。因此這六次都被退回。
但這些缺件真的是確認「本機這則通知」必須有的證據嗎?沒連正式 Log server、沒執行 .NET,可以是這次查核的範圍限制,不一定推翻已對上的本機收據。
程式有攔下來,不代表它攔得一定對。 這裡暴露的是欄位定義:missing_sources 應放支持本次判斷所缺的必要來源,其他未驗事項則另列限制。若兩種東西混在一起,下游可能替不影響本次結論的項目開出補查單。
這是下一版契約要釐清的地方。
官方的 Eval 方法也提醒,測試要檢查評分方式是否可靠。測項全部通過,可能是題目缺乏區辨力;被判失敗,也可能是評分器沒有涵蓋合理答案。Anthropic:Demystifying evals for AI agents
我再補六個情境,連同原本三題,每題跑兩次,比較不帶 Skill 與 v2.1.2,各 18 次。v2.1.2 是 Day 20 最後交付的版本,不是為這份考卷修出來的。
| 新增情境 | 要確認的事 | 不帶 Skill 正確 | v2.1.2 正確 |
|---|---|---|---|
| 收據存在,但接收端回 500 | 有回應不等於成功接收 | 2/2 | 2/2 |
| 發送端只有死信,接收端有成功收據 | 兩端狀態要分別判斷 | 2/2 | 2/2 |
| 收據時間早於取消事件 | 依本題設定,時間矛盾時不能直接確認 | 0/2 | 0/2 |
| 同一則通知有重複收據 | 已收到,不等於只收到一次 | 2/2 | 2/2 |
| 沒有發送紀錄,只有接收收據 | 不能用接收端證據補猜發送端狀態 | 1/2 | 2/2 |
| 收據內容與 Log 相反 | ID 對上,也要核對內容 | 0/2 | 1/2 |
| 含原三題,合計九題 | 13/18 | 15/18 |
新版少錯兩次,但每題只跑兩次,而且兩組是不同批次,不足以宣稱穩定提升。更值得追的是錯在哪裡:八次錯誤都是把應保留 unknown 的一端填成 confirmed。其中「沒有發送紀錄」錯的是發送端,其餘是接收端,不能全部算成送達誤判。
尤其是收據時間早於取消事件那題,兩邊都錯了兩次。看 v2.1.2 交出的理由,它核對了這些:
接收端(confirmed):data/receipts.json 第 0 筆(receipt:0)的狀態是 200。
它的 payload 通知 ID 和訂單 ID 相符,kind 是 order_cancelled,attempt 是 0。
ID、訂單、類型、狀態都核了,唯獨沒看時間。收據的 at 換算是 08:40:10,取消事件是 09:40:10,剛好差一小時,很可能是時區不一致。這比第一份考卷全對更有用:我終於知道下一版要修哪個問題,也知道正解本身要先交代時鐘假設。
還有一個更直接的警訊:v2.1.2 三次判斷錯誤,契約檢查卻全部通過。 時間矛盾兩次、內容相反一次,結果都被標為 READY_FOR_REVIEW。來源 ID 與欄位對得上,不代表檢查程式已核對時間或內容。
反過來,在只有接收證據、沒有發送成功紀錄的兩種情境中,新版判斷正確,卻各有兩次得到 INPUT_ERROR。既有入口依賴發送紀錄取得通知 ID,這份考卷讓它的適用範圍也露了出來。
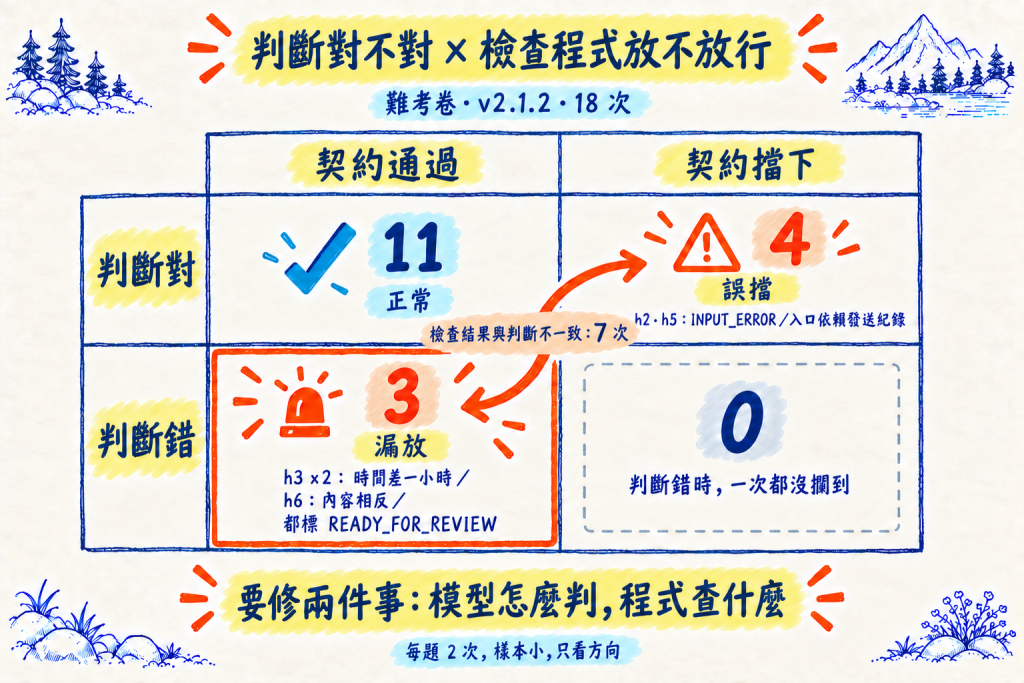
這張圖整理難考卷 v2.1.2 的 18 次結果。誤擋=判斷正確卻得到 INPUT_ERROR;漏放=判斷錯誤卻標為 READY_FOR_REVIEW(只是可送人審,並不代表已獲批准)。
這次 Eval 要修的不只是一段 Prompt,而是兩件不同的事:模型對證據矛盾怎麼判斷,以及程式到底能查哪些條件。
下一步不是再加一句「請仔細檢查」。先保存失敗案例,判斷該修 Skill、腳本還是契約,修完新題舊題一起重跑,再核對代價。目前只走到定位失敗,修訂後的回歸還沒做,下表是下一輪的接受條件草案:
| 下一版要驗什麼 | 接受條件草案 | 目前依據 |
|---|---|---|
| 原三題是否退步 | 固定案例的預期狀態仍成立 | 原考卷三種條件全對;補跑新版原三題也全對 |
| 時間、內容矛盾是否被忽略 | 失敗案例依事前判準處理,不再直接確認 | 難考卷已保存三次新版誤判 |
| 程式檢查是否漏放或誤攔 | 已知錯誤能攔;合理答案不因不必要限制被退回 | 誤判可過契約,合理答案也可能遇到輸入錯誤 |
| 是否值得增加成本 | 品質目標達成,再核對平均費用;暫以每次 US$0.15 為教學預算 | 原考卷新版約 US$0.11,補跑新版平均約 US$0.118 |
這次我學到的,不是新版拿了多少分,而是怎麼決定要不要繼續用它:
Skill 不能寫完就算完成;改版要有驗收,而驗收也不能只看一個通過率。
兩天跑了 63 次,留下的誤判、缺件與契約缺陷已經不是一個人看得完。明天 Day 22,我會把它們排成一張工作視圖,回答團隊每天早上的第一個問題:今天先處理哪一件?
| 篇 | 問題 | 留下什麼 |
|---|---|---|
| Day 17 | 這次查對了,下次還要重新教嗎? | 把查法寫成 Skill |
| Day 18 | 每次都要重新解釋專案? | 專案背景整理成可查的 Wiki |
| Day 19 | 怎麼讓 Claude 專心判斷? | 固定核對交給檢查程式 |
| Day 20 | 我能跑,別人拿到也能跑嗎? | 找出隱藏依賴,交接成工具組 |
| Day 21 | Skill 改了,怎麼知道沒改壞? | 兩份考卷、失敗定位與接受條件 |
參考資料:
run-eval.py 的事前正解、提示與權限;SUMMARY.md 與 FINDINGS.md 保存 27 次原始結果,總費用約 US$2.96。本文修正結果的解讀,不覆寫歷史紀錄。hard/:expected.json、v2.1.2 的 summary 與不帶 Skill 的 summary,各 18 次,含每次軌跡;新版 US$2.12、不帶 Skill US$1.898。兩組加上原考卷共 63 次。hard/run_noskill.py 仍依賴作者本機的 skill-lab/eval.py,目前不是下載這個資料夾就能完整重跑的獨立套件。

 iThome鐵人賽
 看影片追技術