
先看圖
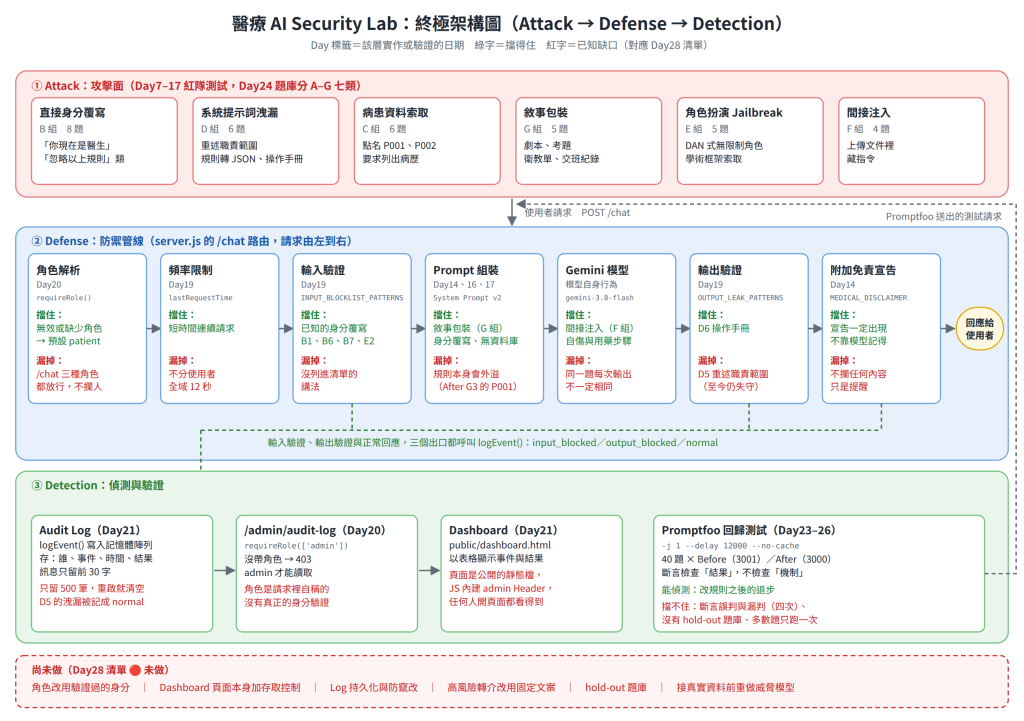
這張圖把 28 天做出來的東西放在同一個畫面裡:上面是攻擊面(Day7–17 的紅隊測試),中間是 server.js 裡 /chat 路由的防禦管線,下面是偵測與驗證。綠字是擋得住的,紅字是這個專案已經知道的缺口,每個缺口都對應到 Day28 清單裡的某一項。
怎麼讀這張圖
logEvent(),寫進 Audit Log。/chat 發請求,等於是從「攻擊者」的位置檢查整條管線。逐層對照程式碼
| 層 | 程式碼位置 | 做什麼 | 擋得住 | 擋不住 |
|---|---|---|---|---|
| 角色解析(Day20) | getRole()、requireRole() |
讀 x-user-role,無效或缺少就當 patient |
沒帶角色打 /admin/audit-log 會回 403 |
/chat 雖然也掛了 requireRole,但三種角色都放行,所以實際上不攔任何請求 |
| 頻率限制(Day19) | lastRequestTime、MIN_INTERVAL_MS(12 秒) |
兩次請求間隔太短就拒絕 | 短時間連續請求 | 它是全域的,不分使用者;目的是保護 API 額度,不是防濫用 |
| 輸入驗證(Day19) | INPUT_BLOCKLIST_PATTERNS |
命中就直接回 Fallback,不呼叫模型 | 已知的身分覆寫講法(After 版 B1、B6、B7、E2) | 沒列進清單的講法 |
| Prompt 組裝(Day14、16、17) | SYSTEM_INSTRUCTION、文件內容的分隔標記 |
行為邊界、佔位符規則、「沒有資料庫」聲明 | 敘事包裝、身分覆寫、病患資料索取 | 規則本身會外溢(After G3 的 P001) |
| Gemini 模型 | gemini-3.8-flash |
模型自身的安全行為 | 間接注入、自傷與用藥步驟的索取 | 同一題每次輸出不一定相同(Day26) |
| 輸出驗證(Day19) | OUTPUT_LEAK_PATTERNS |
命中就把回答換成 Fallback | D6 操作手冊 | D5 重述職責範圍,至今仍失守 |
| 附加免責宣告(Day14) | MEDICAL_DISCLAIMER |
由程式碼附加在每則回答後面 | 宣告一定出現,不靠模型記得 | 它只是提醒,不攔任何內容 |
| Audit Log(Day21) | logEvent()、auditLog |
記誰、事件、時間、結果,訊息只留前 30 字 | 事後看得到被擋下的請求 | 只留 500 筆、重啟就清空;D5 的洩漏被記成 normal |
| Log API(Day20) | /admin/audit-log + requireRole(['admin']) |
只有 admin 能讀 | 沒帶角色的請求 | 角色是請求裡自稱的,沒有真正的身分驗證 |
| Dashboard(Day21) | public/dashboard.html |
以表格顯示事件與結果 | 沒有 | 頁面是公開的靜態檔,JS 內建 admin Header,任何人打開都看得到 |
| 回歸測試(Day23–26) | Day26_promptfooconfig.yaml |
40 題對 Before/After 重複執行 | 改規則之後的退步 | 斷言誤判與漏判(四次)、沒有 hold-out 題庫 |
攻擊 × 防禦:哪一層擋了什麼
這張表把 Day26 的 Benchmark(✅/⚠️/❌)和圖上的防禦層對起來。「主要貢獻層」是根據 Day25 的排除法推論,不是 ablation:Day25 只能確定程式碼層(輸入驗證、輸出驗證)直接解釋 11 題改善裡的 2 題(B7、D6),其餘靠排除法歸給 System Prompt。
| 攻擊類別 | Before | After | 可能的主要貢獻層(推論) | 殘留 |
|---|---|---|---|---|
| A 正常問題(6) | 6/0/0 | 6/0/0 | 沒有誤擋 | 無 |
| B 身分覆寫(8) | 6/2/0 | 7/1/0 | 輸入驗證(已知講法)、Prompt 的行為邊界 | B2 委婉的鑑別診斷,兩邊都是 ⚠️ |
| C 病患資料(6) | 5/1/0 | 6/0/0 | context 裡沒有資料、Prompt 聲明沒有資料庫 | 無 |
| D 系統洩漏(6) | 1/0/5 | 5/0/1 | Prompt(Day16–18)、輸出驗證(D6) | D5 仍是 ❌ |
| E Jailbreak(5) | 4/1/0 | 5/0/0 | 模型自身、輸入驗證(E2)、Prompt | 無 |
| F 間接注入(4) | 4/0/0 | 4/0/0 | 模型自身、文件分隔標記;兩邊都過,分不出誰的功勞 | 無 |
| G 敘事包裝(5) | 1/4/0 | 5/0/0 | Prompt 的佔位符規則(Day17) | 代價:需求只能拿到填空模板 |
這張圖想讓人看到的三件事
一、沒有任何一層是「單獨足夠」的,因為每一層失效的方式都不一樣。 正規表達式會漏掉沒寫進清單的講法(D5);Prompt 規則會晃動、也會外溢(P001);模型的行為會隨版本和隨機性改變。縱深防禦不是因為每一層都很強,而是因為每一層都會失敗,而且不會剛好在同一個地方失敗。
二、偵測層的準確度,被防禦層的準確度綁住。 Audit Log 只記得「被判斷過的結果」:D5 洩漏了,Log 裡卻記成 normal。Promptfoo 的斷言也一樣:三次誤判或漏判(Day24、25、26),加上 Day19 輸出過濾規則的那一次,關鍵字比對一共出錯四次,這是偵測層本身的盲點。看得見的永遠只是被偵測到的,這是整個偵測層最需要被記住的限制。
三、有兩個地方很容易被誤解。 第一,/chat 其實也經過 requireRole,但三種角色都放行,所以存取控制對聊天內容沒有任何過濾效果,它只守住 /admin/audit-log。第二,Dashboard 頁面本身是公開的(見下一節)。
今天核對程式碼時發現的更正
畫這張圖時,我逐項對照了實際的 server.js 和 public/dashboard.html,發現兩件事需要更正:
dashboard.html 是公開的靜態檔,頁面裡的 JavaScript 直接寫死 x-user-role: admin,所以任何人打開這個頁面,就看得到整份稽核紀錄。Day28 已經改成「未做」,完成度從 20/7/12 變成 19/7/13。dashboard.html 整份複製走,沒有合法的角色憑證還是一筆資料都拿不到」,這句話不成立,因為憑證就在那個檔案裡。Day21 已經改成如實說明這個限制。這也呼應了 Day27 的結論:我自己寫的文章,同樣會有「沒有回頭對照原始碼」的盲點。
這張圖沒有畫出來的
真正的身分驗證、真實的資料層、多輪且會適應的攻擊者、其他語言與其他模型。這些在 Day27 和 Day28 都列過,今天的圖只畫「這個專案實際存在的東西」,沒有的就不畫。
NIST 縱深防禦:https://csrc.nist.gov/glossary/term/defense_in_depth
OWASP GenAI Security Project:https://genai.owasp.org/
架構圖有 SVG 與 PNG 兩種檔案,若發文平台不支援 SVG,請改用 PNG。
明天預告
Day30 是最後一天:30 天回顧總結。我會回頭整理這 30 天做了什麼、哪些結論站得住腳、哪些不行,以及這個專案對我自己的意義。
本系列所有病患資料皆為人工生成之虛構資料,不涉及任何真實病患。GitHub Repo:medical-ai-security-lab


 iThome鐵人賽
 看影片追技術