

Day 26 介紹了 SRE 在地端的硬體評估,本篇轉向雲端服務,談 SRE 如何為 BI 服務建立監控。
我們以 Superset (Apache Superset,開源的 BI 平台) 承載公司內外部的資料儀表板,而它在導入初期幾乎沒有監控。好用的工具會被持續使用,逐漸擴散到整個公司;但隨著業務擴張,同一套架構能否承受 10 倍甚至 100 倍的資料量?
這兩年 Berry AI 的業務從 100 家店成長到 1,000 家、2,000 家。
除了全公司營運流程的優化,工程端更需要預先掌握兩件事:系統能承受多少業務量,以及我們能接受多少成本。
因此我們開始建立壓力測試 (load test),在業務量到達之前,先量出系統的承載上限。
壓力測試要先解決幾個工程問題,例如建立一套與正式環境 (production) 相同的基礎設施、產生符合真實資料分布的測試資料。但最根本的問題是:什麼樣的系統才算可用?當非功能性需求 (non-functional requirements) 也寫進規格書,SRE 才有依據判斷系統是否可用,這是系統從混沌走向有序的關鍵。
對 Dashboard 而言,最直接的可用性指標是載入時間:使用者開啟一個 Dashboard 之後,要等多久才看到所有圖表。接下來的問題是這個時間該從哪裡量。
系統架構如下:
Client -> Superset (Cache in Redis) -> DB
Client 有兩種:寄送信件的服務,以及真實使用者。本篇先討論真實使用者。
從使用者端量測載入時間最直觀,也最貼近真實體驗。量測端需要滿足三個條件:
針對這三個條件,我們的做法如下:
Superset 是開源專案,它以 Playwright (Microsoft 開源的瀏覽器自動化框架) 撰寫的端對端測試中,DashboardPage 的 waitForChartsToLoad 已經定義了「圖表載入完成」:頁面上所有 [aria-label="Loading"] 的載入指示都隱藏之後,才視為完成。直接採用上游的定義,量測標準就與 Superset 自身的測試一致。代價是這個判斷依賴前端的 DOM 屬性,Superset 前端改版時必須同步檢查。
除了模擬真實瀏覽器,另一個更穩定的做法是從 server 端量測。Superset 支援事件日誌 (event logging),可以把 Dashboard 中查詢的事件連同耗時 (duration_ms) 輸出成 log。我們只需要收集測試期間的 log 並轉換成 metrics,就能清楚看出請求在 Backend -> DB 這一段花了多少時間。
架構如下:
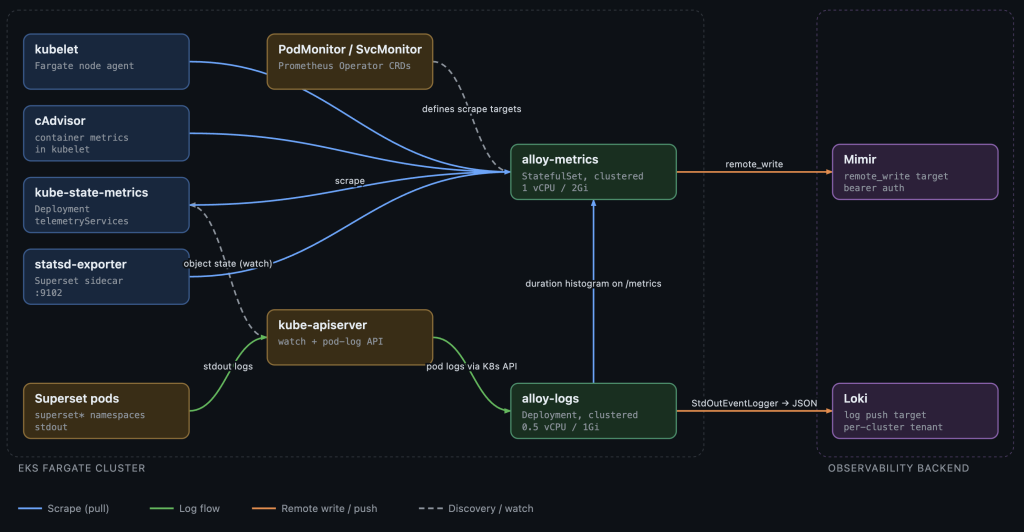
Superset 部署在 Amazon EKS (Elastic Kubernetes Service) 上,Pod 以 Fargate (AWS 的 serverless 容器運算服務,不需自行管理節點) 執行。Collector 使用 Grafana Alloy (Grafana 的開源 telemetry collector),分成 alloy-metrics 與 alloy-logs 兩組:
/metrics 上,再由 alloy-metrics 抓取 (scrape) 後 remote write 到 Mimir (Grafana 的開源時序資料庫)| Client-side | Server-side | |
|---|---|---|
| 量到什麼 | 使用者體感 (含前端與網路) | 系統內部的處理時間 |
| 資料來源 | 合成流量,主動產生 | 真實流量,被動接收 |
| 覆蓋範圍 | 接近整段資料流 | 僅有後端與資料庫 |
| 成本 | 高 (需執行瀏覽器 worker) | 低 (沿用既有的 log 管線) |
| 維護 | 不穩定 (受 UI 與 session 變動影響) | 穩定 (不依賴 UI) |
| 服務完全中斷時 | 量得到,可兼作可用性探測 | log 一併中斷,量不到 |
Dashboard 載入時間可以從兩端量測。Client-side 在 AWS 上以 ECS 產生 Client,沿用 Superset 上游測試對「載入完成」的定義,量到的是使用者的實際體感;Server-side 收集 Superset 的事件日誌,經 Alloy 轉成 metrics 寫入 Mimir,量到的是後端與資料庫的處理時間。兩者在覆蓋範圍、成本與維護負擔上各有取捨,工程端的責任是把這些取捨攤開,讓決策在資訊充分的前提下做出。
所以最後用哪一個?由 PM 決定。
本篇只涵蓋真實使用者這一類 Client,寄送信件的服務是另一條量測路徑。下一篇 Day 28 從系統本身轉向開發環境,介紹 Berry AI 的 Python 工具鏈:uv、ruff、ty 與 prek。
loki.source.kubernetes
本系列由 Berry AI 工程團隊出品。更多工程實戰紀錄都在 Berry AI 技術部落格。


 iThome鐵人賽
 看影片追技術