
Ep15 建立了 Spark Standalone cluster,也確認 Master、Worker、Driver 與 Executor 的位置。這一集沿用同一個 cluster,追蹤一次 spark-submit 之後發生的事:Executor 如何取得資源?Driver 在 action 發生後如何把 tasks 送給它?
我會先用 local[2] 的執行方式作為對照,再走一次 client-mode application 在 cluster 中的實際流程,最後用 Spark UI 的 Job、Stage 與 Event Timeline 驗證 6 個 tasks 如何在 2-core Executor 上執行。
local[2] 的兩個 task threads,進入 cluster 後對應到什麼。spark-submit 從 Driver、Master、Worker 到 Executor 的流程。local[2] 對照:同樣是兩個 task slots,位置不同了前幾集在 local[2] 執行 Spark 時,Driver 與 local scheduler 都在筆電上的 Spark application process 裡。action 產生 Job、Stage 與 tasks 後,local scheduler 可讓兩個 task threads 同時執行;Master、Worker 與 Executor process 都沒有出現。
local[2]

筆電上的 Spark application process
├── Driver
├── DAGScheduler / Task Scheduler
└── 2 個本機 task threads
進入 cluster 後,Driver 保留規劃 Job、Stage 與 task 的責任。差異在於 task 不再由 Driver process 裡的本機 threads 執行,而是由遠端 Executor 的 cores 提供 task slots。這次實驗的 Executor 有 2 cores,因此同一時間也有兩個 task slots:它們由 Worker 上的 Executor process 提供。
client-mode cluster

提交端 container                 Worker container
┌──────────────────┐            ┌────────────────────────┐
│ Driver            │            │ Worker                 │
│ DAGScheduler      │            │ └── Executor(2 cores)│
│ Task Scheduler    │── tasks ──→│     ├── task slot 1    │
└──────────────────┘            │     └── task slot 2    │
                                └────────────────────────┘
local[2] 與一個 2-core Executor 都能同時執行兩個 tasks;前者使用同一個 application process 裡的 threads,後者使用 Worker 上 Executor process 的資源。
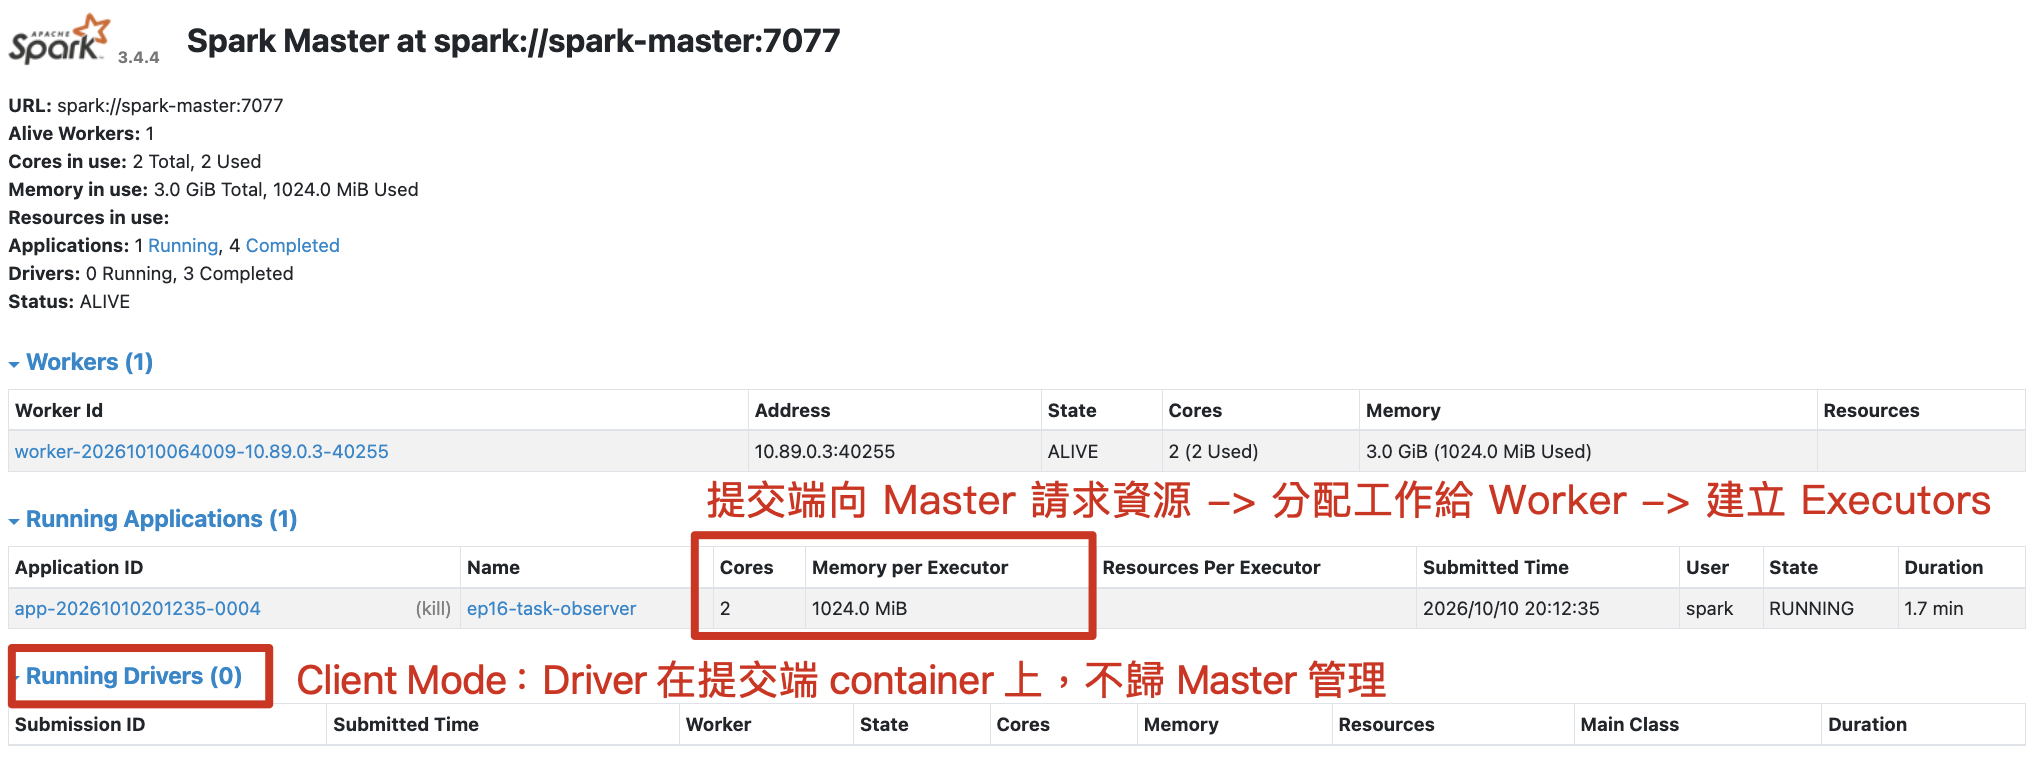
spark-submit 在 cluster 裡經過哪些角色?這次的 application 以 client mode 提交。提交端 container 同時承載 spark-submit 與 Driver;Master 和 Worker 則延續 Ep15 已啟動的 container。整條流程可拆成兩個階段:先取得 Executor,再執行 action 的 tasks。
一、application 啟動與資源配置

1. spark-submit 在提交端啟動 Driver。
2. Driver 向 Master 註冊 application,並請求 Executor 資源。
3. Master 從已註冊的 Worker 選擇可用資源。
4. Master 要求 Worker 啟動 Executor。
5. Executor 啟動後向 Driver 註冊,Driver 已取得可執行 task 的資源。

二、action 後的 task 排程

6. Driver 對 count() 建立 Job、Stage 與 tasks。
7. Driver 的 Task Scheduler 透過 RPC 將可執行的 tasks 送給 Executor。
8. Executor 以自己的 cores 執行 tasks,並將狀態與結果回報 Driver。
9. task slot 空出後,Driver 繼續送出下一批等待中的 tasks。
Master 在步驟 2 到 4 處理 application 的資源配置。步驟 6 以後,Driver 與 Executor 直接協作 task 的執行。Worker 承載 Executor process,也負責依 Master 指示啟動它。
Master 決定 application 可以使用哪一份 cluster 資源;Driver 決定下一個 task slot 要執行哪個 task。
這次的資料由 parallelize() 建立,實驗只觀察 control flow 與運算資源。資料檔讀取、shuffle files、cache blocks 落在哪裡,留待下一篇接著追。
實驗將資源和 partition 數固定成下表的組合:
| 項目 | 固定值 | 這次要看什麼 |
|---|---|---|
| Worker | 2 cores、3 GiB | cluster 可提供的總資源。 |
| Executor | 2 cores、1024 MiB | 同時可執行兩個 tasks。 |
| input partitions | 6 | 這個 Stage 產生 6 個 tasks。 |
| 每個 task | 暫停 15 秒 | 將執行中的 tasks 留在 UI 上。 |
application 的核心程式如下。parallelize(range(60), 6) 建立 6 個 input partitions;mapPartitions() 在每個 task 內暫停;count() 觸發 action。
import time

from pyspark import TaskContext


def observe_partition(iterator):
    partition_id = TaskContext.get().partitionId()
    print(f"Task for partition={partition_id} started", flush=True)
    time.sleep(15)
    yield from iterator


result = (
    sc.parallelize(range(60), 6)
    .mapPartitions(observe_partition)
    .count()
)
這個 Stage 沒有 shuffle,所以 6 個 input partitions 直接對應 6 個 tasks。shuffle 產生的多個 Stages、不同的 partitions 與 task 批次,前幾集已經看過;這次刻意固定它們,將注意力放在 task 抵達 Executor 後的執行順序。
application 提交後,Master UI 的 Running Applications 顯示 ep16-task-observer,使用 2 cores 與 1024 MiB。Running Drivers 是 0,因為 client-mode Driver 留在提交端,Standalone Master 不管理它的生命週期。
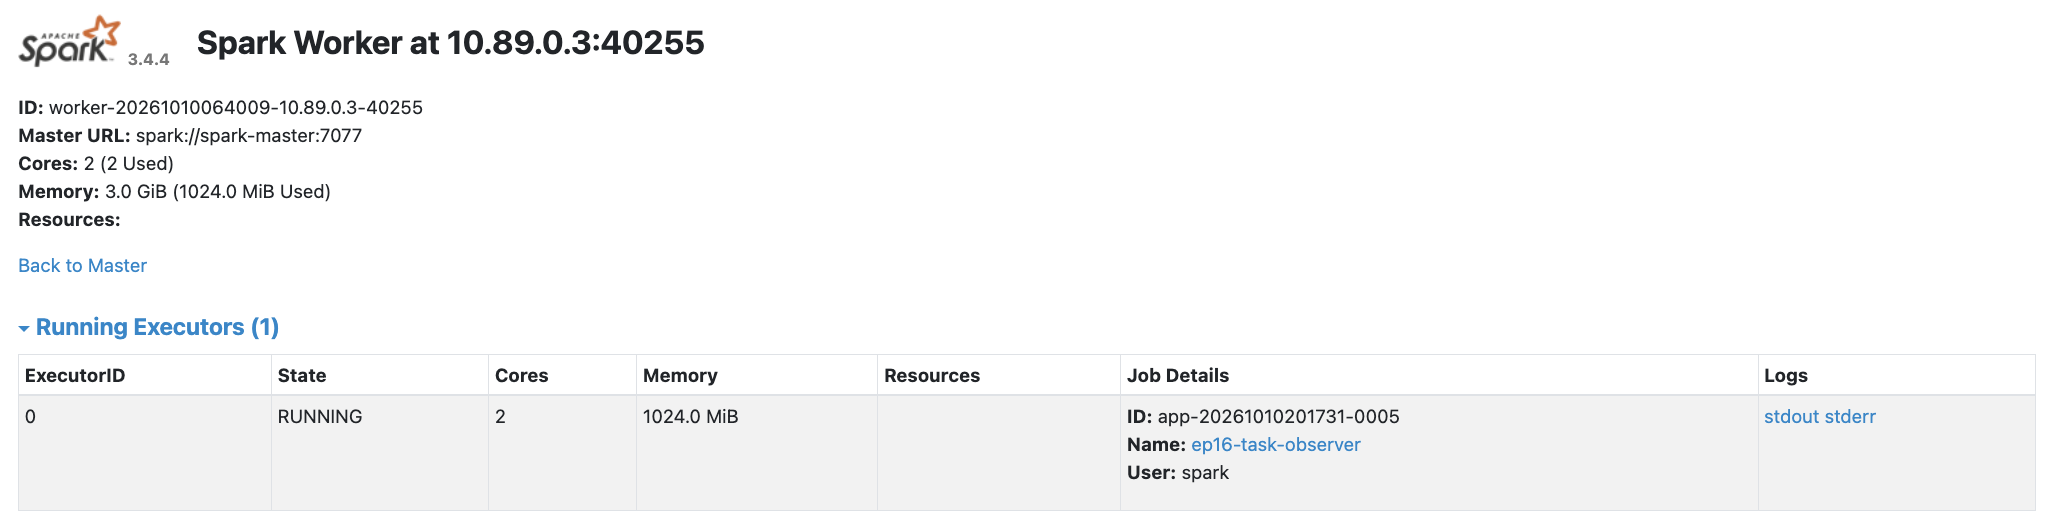
Worker UI 也出現一個 Running Executor。它屬於 ep16-task-observer,有 2 cores、1024 MiB;這就是 Driver 接下來能派送 task 的地方。
count() 建立一個 Job、Stage 與六個 tasksDriver UI 的 Jobs 分頁顯示 count() 觸發一個 Job。該 Job 有 1 個 Stage,所有 Stage 合計完成 6 個 tasks,對應前面固定的 6 個 input partitions。
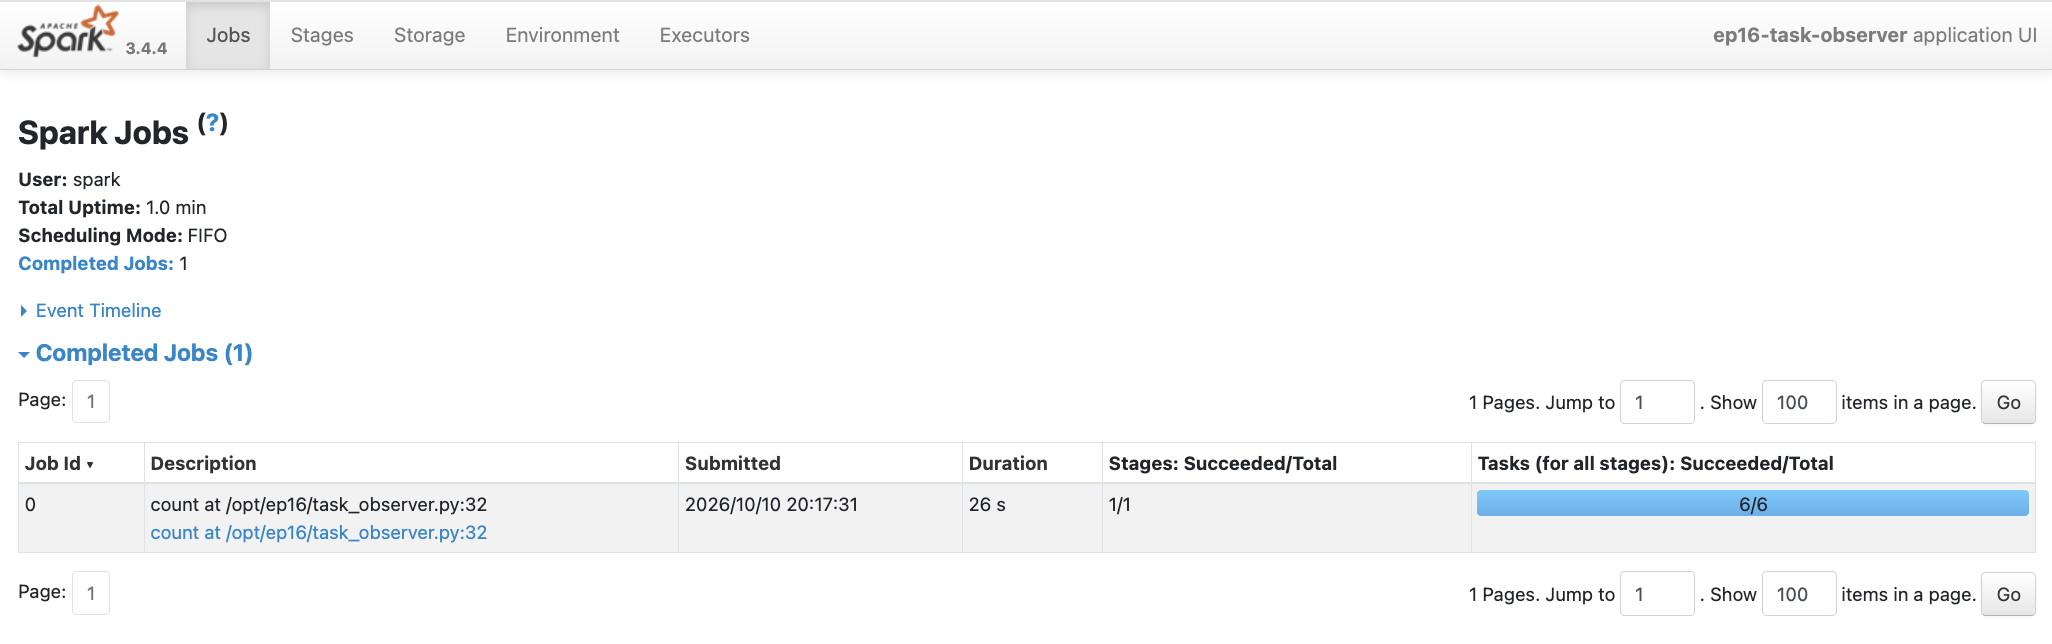
第一輪觀察讓每個 task 暫停約 8 秒,Job 在約 26 秒完成。為了在 Stage 頁截下並行中的 task,我只把暫停時間調為 15 秒後重跑;Worker、Executor cores、Executor memory 與 partition 數都維持相同。
第二輪的 Stage 0 Event Timeline 顯示六條 task 長條,全部位於同一個 Executor。時間軸有三組同時出現的兩條長條:第一組結束後,第二組開始;第二組結束後,第三組開始。這正是 2 個 task slots 的排程結果。
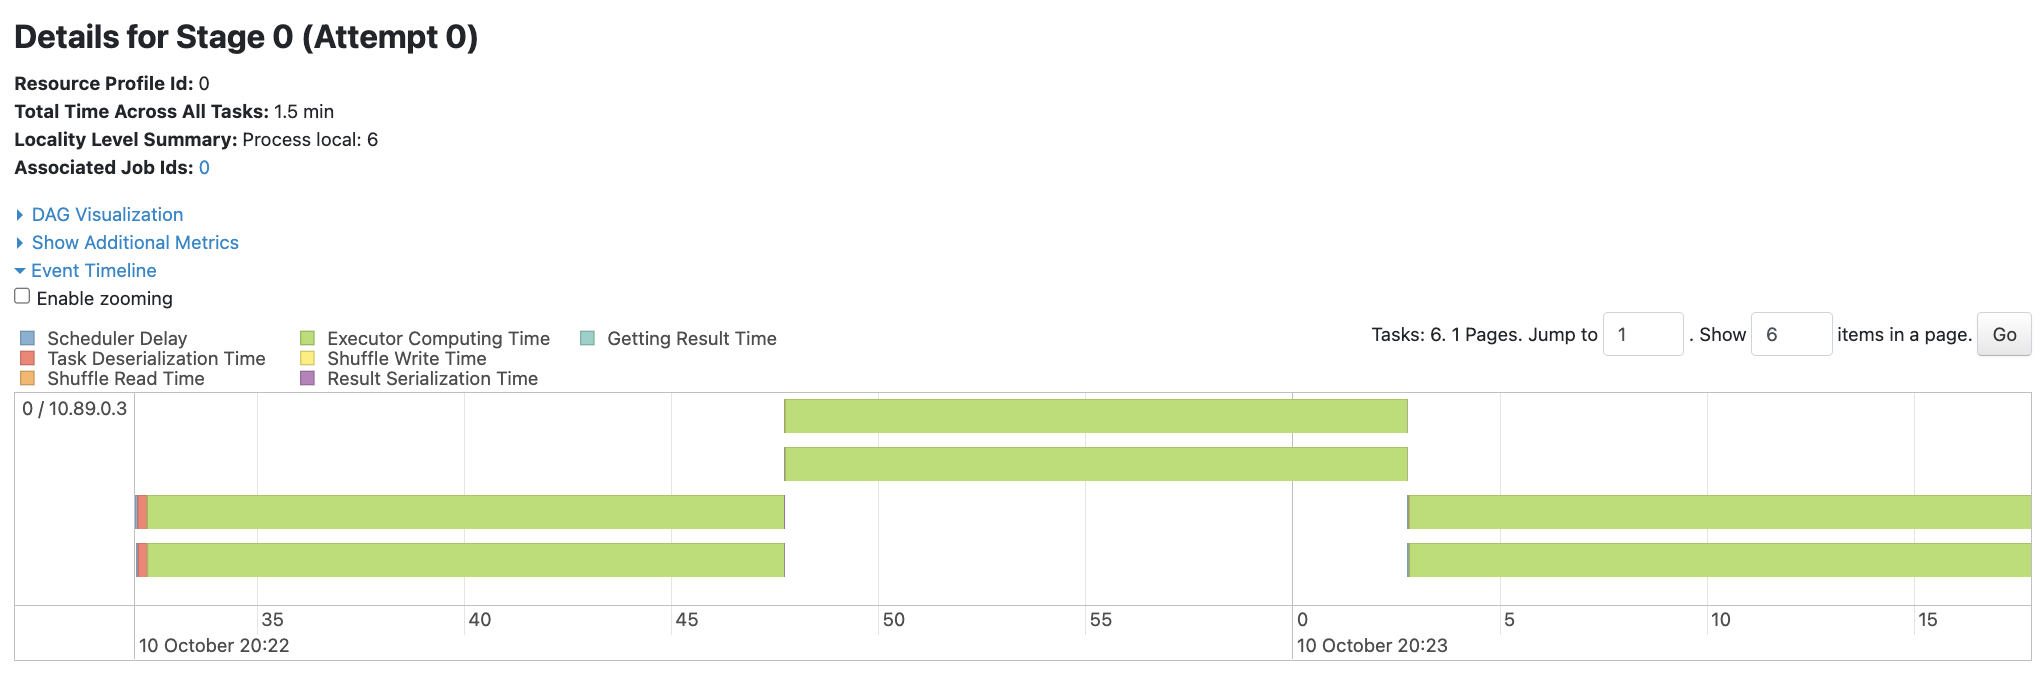
每個 task 約花 15 秒,因此 Total Time Across All Tasks 約為 1.5 分鐘:這個欄位加總六個 task 的時間。Stage 的實際經過時間約為三批的 45 秒,加上 task 啟動與結束的固定成本。
Driver 從 Executor 收到前一批 task 完成的狀態後,才有兩個空出的 task slots 能接收下一批。這個等待發生在 application 已有 Executor 之後,和 Master 是否還能找到 Worker 資源是不同層次的問題。
Stage 有很多 tasks 時,先不要直接推論它們會同時執行。先在 Driver UI 看 Stage 的 task 數和 Timeline,再在 Executors/Worker UI 看 application 實際有幾個 Executor、每個 Executor 配置幾個 cores。這兩組資訊放在一起,才能解釋 tasks 是等待 task slots、等待 Executor 啟動,或受到其他因素限制。
真實 job 還會受到資料 locality、不同 Executor 的資源、dynamic allocation、task 耗時與 scheduler delay 影響。這次的 6 tasks 對 2 slots 是刻意簡化的基準,讓 Driver、Master、Worker 與 Executor 的分工先變得可見。
local[2] 中的兩個本機 task threads,進入這次 cluster 後對應到 2-core Executor 提供的兩個 task slots。Driver 仍負責將 action 拆成 Job、Stage 與 tasks;Master 先讓 application 取得 Executor;Driver 接著直接將等待中的 tasks 依序送進 Executor 的空 slot。
下一篇會接著追 task 執行時留下的資料:輸入資料、shuffle files 與 cache blocks 分別會落在什麼位置?
🚀 GitHub:
Ep16|同一個 Spark job 進 cluster 後,task 如何被送到 Executor?
🚀 spark-learning-lab 系列文章與實作:
https://github.com/jeffery5bai/spark-learning-lab
Apache Spark 3.4.4 — Submitting Applications:
https://archive.apache.org/dist/spark/docs/3.4.4/submitting-applications.html
Apache Spark 3.4.4 — Monitoring and Instrumentation:
https://archive.apache.org/dist/spark/docs/3.4.4/monitoring.html

 jeffery5bai

 iThome鐵人賽
 看影片追技術