
9 月底,Claude 一週內連出兩個新模型:9/22 是 Opus 5.5,9/28 是 Sonnet 5.5。
官方的發表頁都很完整。Opus 5.5 那頁列了十幾項測驗分數,像 Terminal-Bench、CursorBench,並說它在大部分工作上「表現跟 Fable 5.1 同一個等級」;Sonnet 5.5 則是 Opus 5.5 更快、更便宜的搭檔,適合範圍明確的日常工作、修 bug、做出精緻的文件。
但老實說,那些分數我看不太出來,跟我實際用起來有什麼關係。
我用 Claude 不只寫程式,也常拿它處理生活上的事。最近剛好在排明年 5 個人一起去東京的 9 天行程,表格是我自己用 Numbers 做的:每天的行程、交通、三餐、預算,還貼了 48 張景點和美食的照片。排行程的時候,我真的會想叫 AI 幫我做這些事:
所以這次不看官方的標準考題,直接拿這四件我平常、休閒時真的會做的事,讓新的 Opus 5.5、Sonnet 5.5 來做。 順便拉上幾個對照組:上一代的 Sonnet 5、最便宜的 Haiku 4.5,還有目前最強、也最貴的 Fable 5.1。
選模型的基本觀念,像是怎麼切換、官方怎麼分工、價格差多少,我在「Claude Code 實戰手冊」G7〈控制 Claude 怎麼想:選模型與思考深度〉寫過(https://ithelp.ithome.com.tw/articles/10406403),這篇不重講。這篇只看一件事:它們在我的日常任務上,實際做得怎麼樣。
先說清楚:這是我自己好奇做的測試,沒有業配,也不是正式的跑分。 我盡量把條件固定(第 1 節),但每個模型每題只跑 1~2 次,結果只代表我這份行程。
四個任務總共跑了 30 次(包含失敗和中途停掉的),換算成 API 價格大約美金 $45(我用的是 Max 方案,實際扣的是訂閱額度)。先講結論:
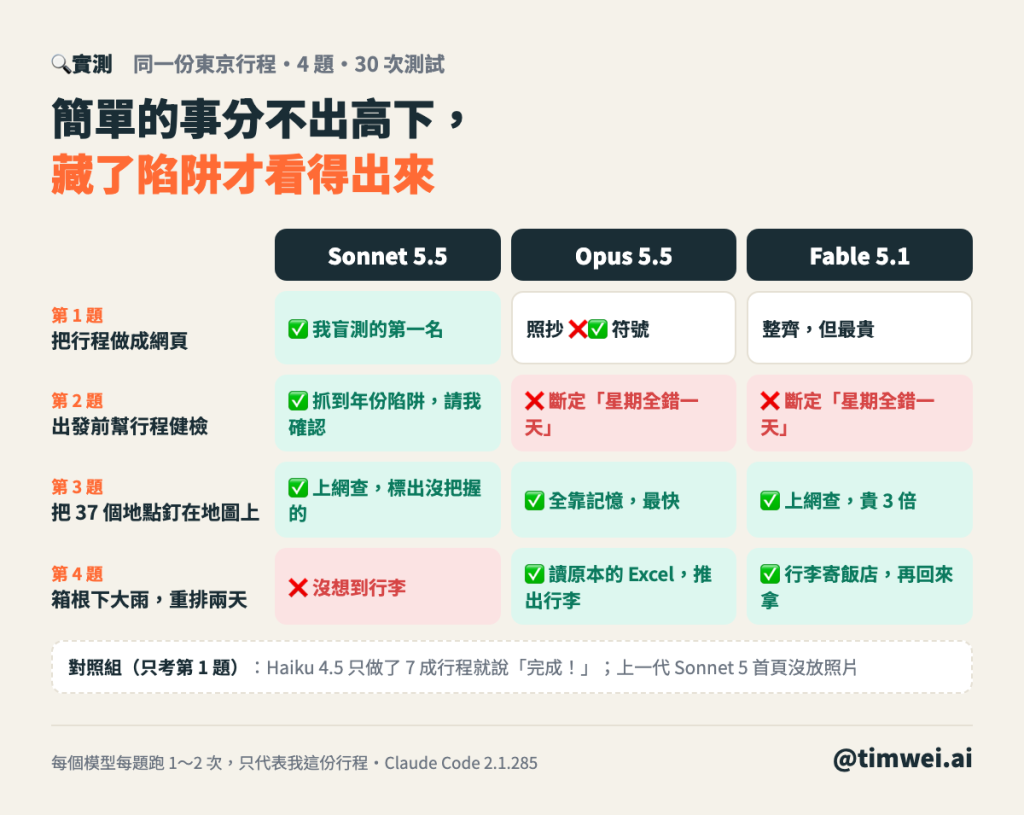
下面一個任務一個任務講。
我的行程表是用 Numbers 做的:9 天、5 個大人,有 13 張工作表,包括每天的行程和費用、三餐總覽、住宿、預訂清單,還有景點照片。資料很雜:日幣台幣混用、有「待定」「待確認」、有訂票連結,很像一般人真的會丟給 AI 的檔案。
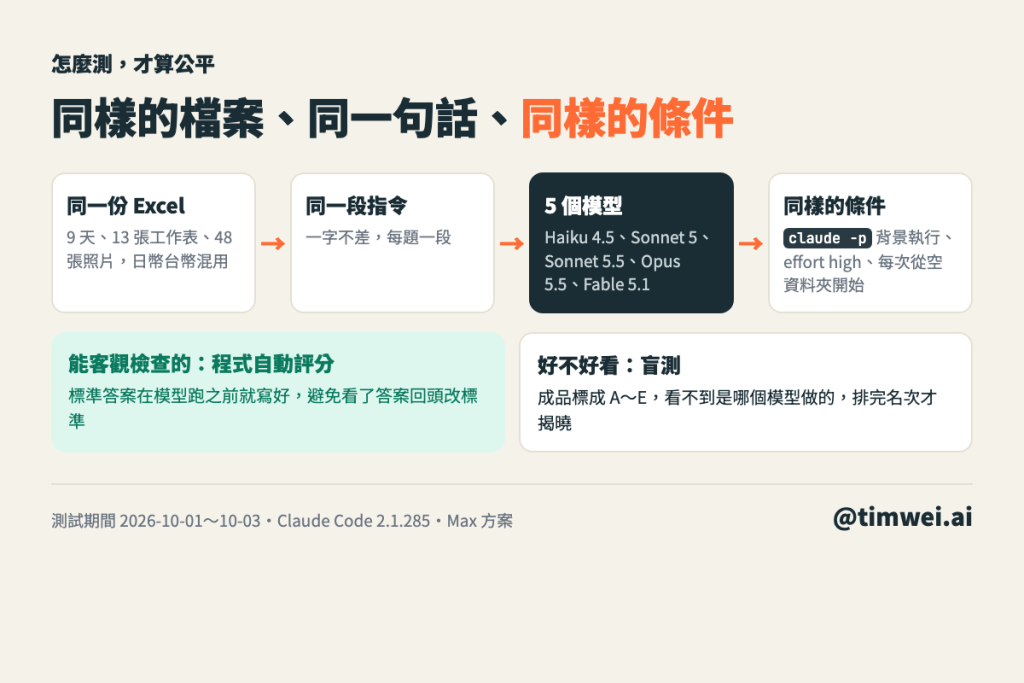
每個模型的條件都一樣:
| 項目 | 設定 |
|---|---|
| 版本 | Claude Code 2.1.285 |
| 執行方式 | 背景執行(claude -p),每次都從一個只放這份 Excel 的空資料夾開始 |
| 思考深度 | 全部寫死 --effort high(Haiku 4.5 不支援 effort,用它的預設) |
| 權限 | auto mode(Haiku 4.5 不支援 auto mode,改成允許執行指令) |
| 指令 | 同一段 prompt,一字不差 |
| 記錄 | 花了多久、呼叫幾次工具、換算的 API 價格 |
「換算的 API 價格」是 Claude Code 跑完會附上的數字,代表同樣的用量如果走 API 要付多少錢。訂閱制實際扣的是額度,不是這筆錢,所以我只拿它來比較誰比較耗。
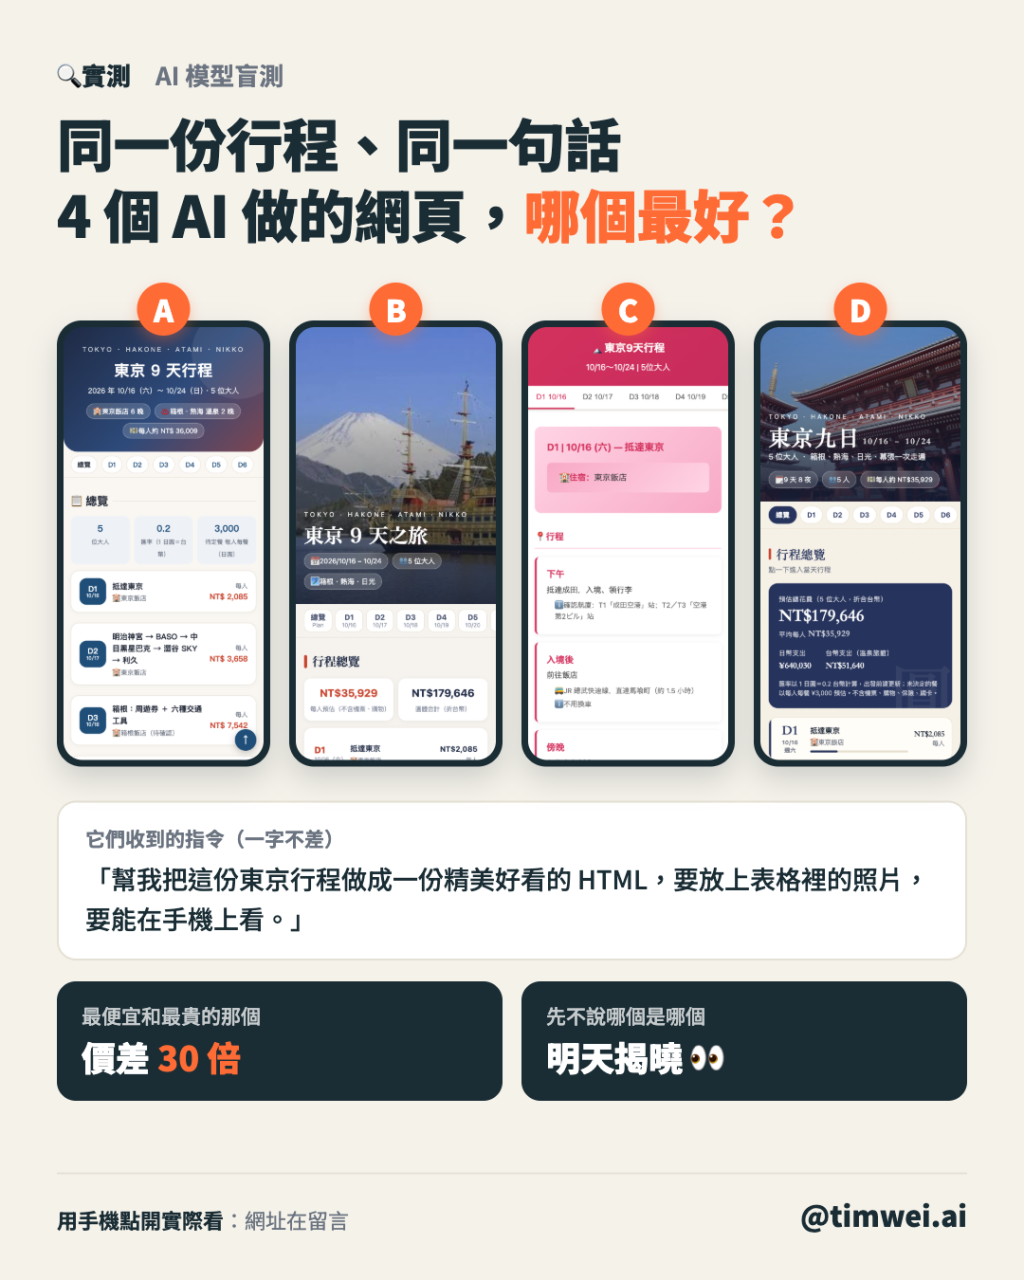
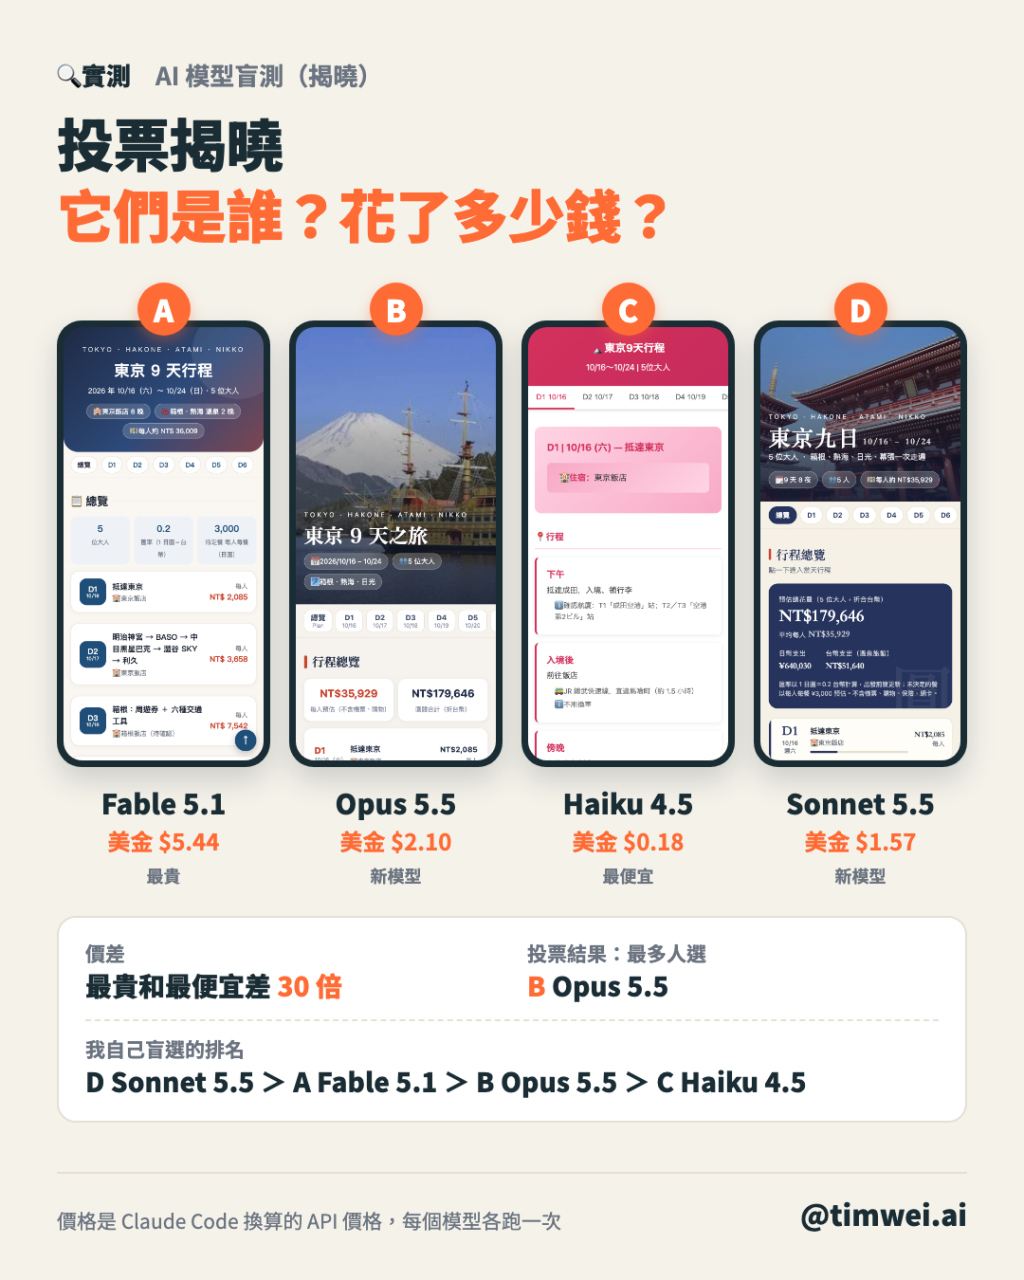
評分的部分,能客觀檢查的我都寫成程式自動檢查,而且標準答案都是在模型跑之前就寫好的,避免我看了它們的答案,回頭改標準。好不好看這種主觀的部分,我把成品標成 A、B、C、D、E,看不到是哪個模型做的,排完名次才揭曉。
prompt 很單純:
幫我把這份東京行程做成一份精美好看的 HTML,要放上表格裡的照片,要能在手機上看。
照片的部分,我先把有拍到人的照片拿掉,剩下 48 張。
| 模型 | 花多久 | 換算價格(美金) | 64 個行程 | 48 張照片 |
|---|---|---|---|---|
| Haiku 4.5 | 1~2.5 分 | $0.10~0.18 | 47、40 | 0 張 |
| Sonnet 5 | 9~12 分 | $1.30~2.10 | 64 | 48 |
| Sonnet 5.5 | 8 分 | $1.57~1.61 | 64 | 48 |
| Opus 5.5 | 7~9 分 | $2.03~2.10 | 64 | 48 |
| Fable 5.1 | 10 分 | $5.44 | 64 | 48 |
Haiku、Sonnet 5、Sonnet 5.5、Opus 各跑兩次;Fable 很耗額度,只跑一次。Sonnet 5 另外還有一次跑到一半被我停掉(見第 6 節)。
Claude Code 跑完會留下詳細的用量紀錄,連花了多少 token 在「思考」都有。下面是盲測用的那一輪(Sonnet 5 用的是正常跑完的那一次):
| Fable 5.1 | Opus 5.5 | Sonnet 5.5 | Sonnet 5 | Haiku 4.5 | |
|---|---|---|---|---|---|
| 花多久 | 10.0 分 | 8.9 分 | 8.0 分 | 8.8 分 | 2.3 分 |
| 輸出的 token | 45,454 | 35,444 | 48,475 | 44,539 | 19,166 |
| 其中思考 | 8,273 | 7,304 | 18,197 | 12,631 | 1,313 |
| 其中寫出來的(程式碼、網頁、回覆) | 37,181 | 28,140 | 30,278 | 31,908 | 17,853 |
| 讀進去的 token | 約 193 萬 | 約 269 萬 | 約 316 萬 | 約 256 萬 | 約 17 萬 |
| 換算價格(美金) | $5.44 | $2.10 | $1.57 | $1.30 | $0.18 |
先說明兩件事:思考的內容看不到,只知道量;讀進去的 token 大多是「重讀」,每一輪它都要把目前為止的對話重新讀一遍,所以會累積到幾百萬。重讀的部分有快取,價格便宜很多,所以價格不會跟這個數字成正比。
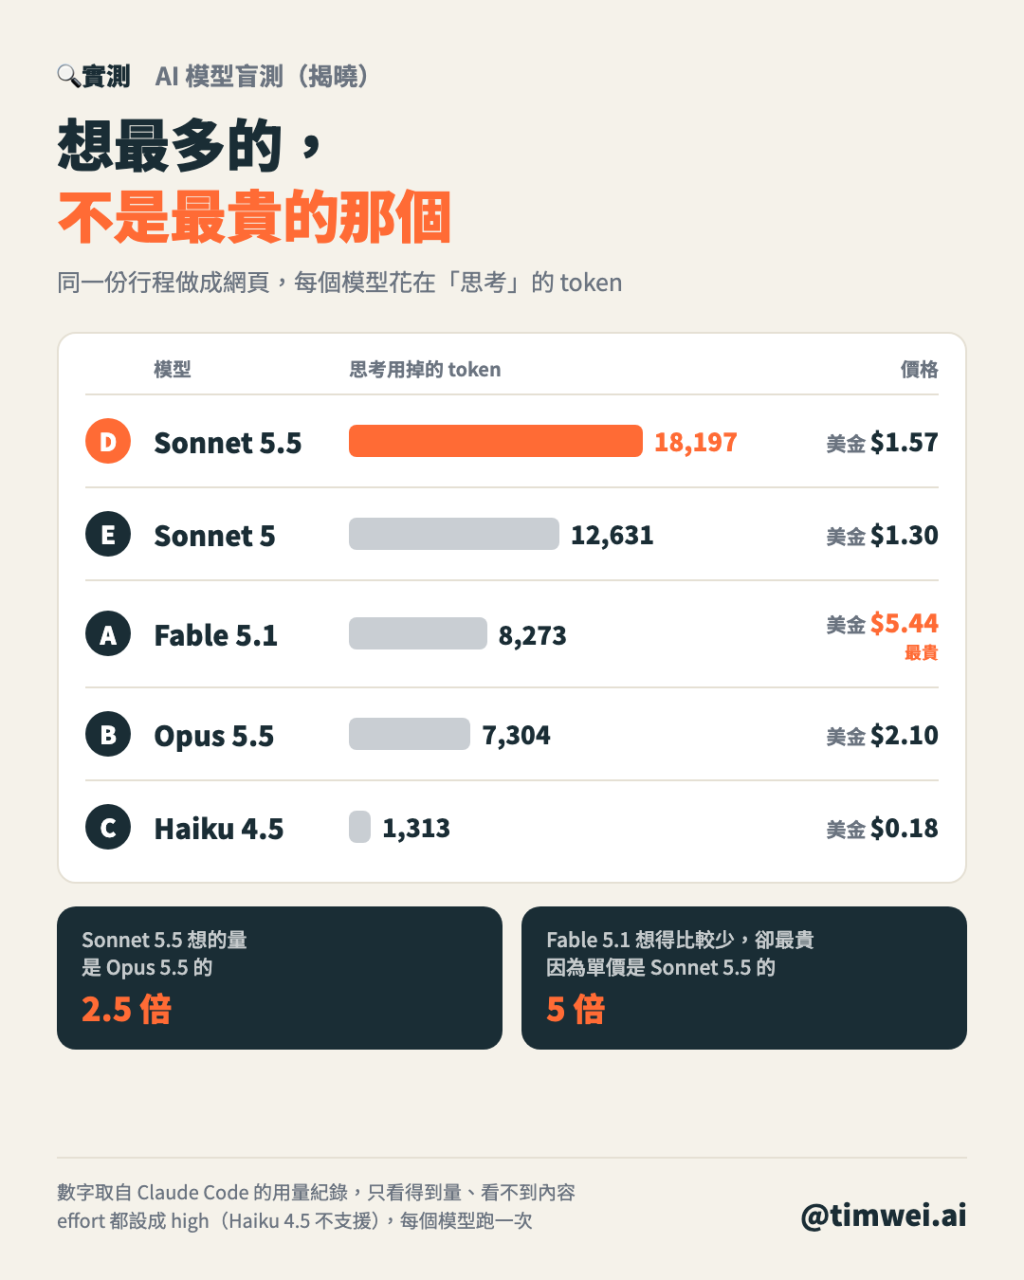
從這張表可以看出三件事:
我看完五份成品,排出來是 D > A > B > E > C(代號跟盲測網站一樣)。揭曉之後:
D 和 B 的差別很有意思。我的 Excel 在「預約」「狀態」欄位裡用了 ❌、✅、⏸ 這些符號。Sonnet 5.5 把它們翻成文字,例如「❌ 買餐券」變成「不可預約 買餐券」、✅ 變成「已定」;Opus 5.5 原封不動照抄,結果畫面上一排打勾和叉叉,我看了反而搞不懂:這是吃完了?沒開?還是倒閉了?
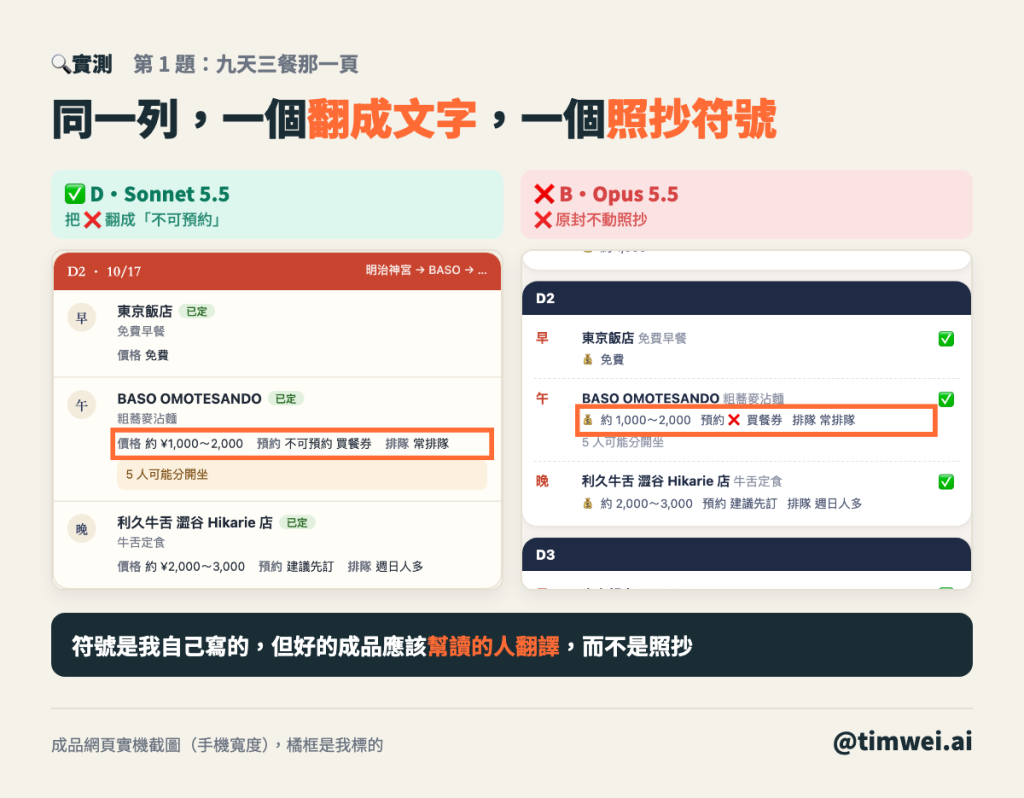
符號是我自己寫的,但好的成品應該幫讀的人翻譯,而不是照抄。
我拿每個模型最後的回報,去對它實際做過的事:
我的 Excel 沒有寫年份。7 份完整的成品裡,有 5 份自己寫上了「2026/10/16」:Sonnet 5 兩次、Opus 兩次、Fable 一次。問題是,表上的星期幾對應的是 2027 年。只有 Sonnet 5.5 兩次都沒有自己補年份。
另外,Excel 裡有 4 餐還寫著「待定」,所有模型都照實標成待定,沒有人擅自幫我選店家。
另外跑了一次沒有照片的版本,結果 Sonnet 5.5 在網頁上寫了一句:「Excel 的 D4 小計漏算『寄放行李 ¥2,000』,這裡已補進去。」
我回去查,D4 的小計公式是 SUM(F15:F22),寄放行李在第 23 列,真的沒加到。這是我自己都沒發現的錯。同一輪的 Opus 5.5 和 Fable 5.1 都把寄放行李列出來了,卻直接沿用 Excel 的總額,沒發現前後對不上。
做網頁太簡單,分不出 Sonnet 5.5、Opus 5.5、Fable 5.1。所以第二題我改考推理:
出發前幫我檢查這份東京行程,把可能會出包的地方全部找出來,依嚴重程度用紅黃綠燈整理成一頁 HTML 報告。
模型跑之前,我先自己把整份表讀過一遍,列了 18 個真正的問題,例如:D4 小計漏算、預訂清單和行程寫的熱海飯店不是同一家、D5 下午的時間順序倒過來(14:30 才出發去上野,午餐卻排在 14:00)、同一家燒肉店寫了兩個不同的分店名稱。我也設了陷阱:我的表上寫的星期幾,對應的是 2027 年。
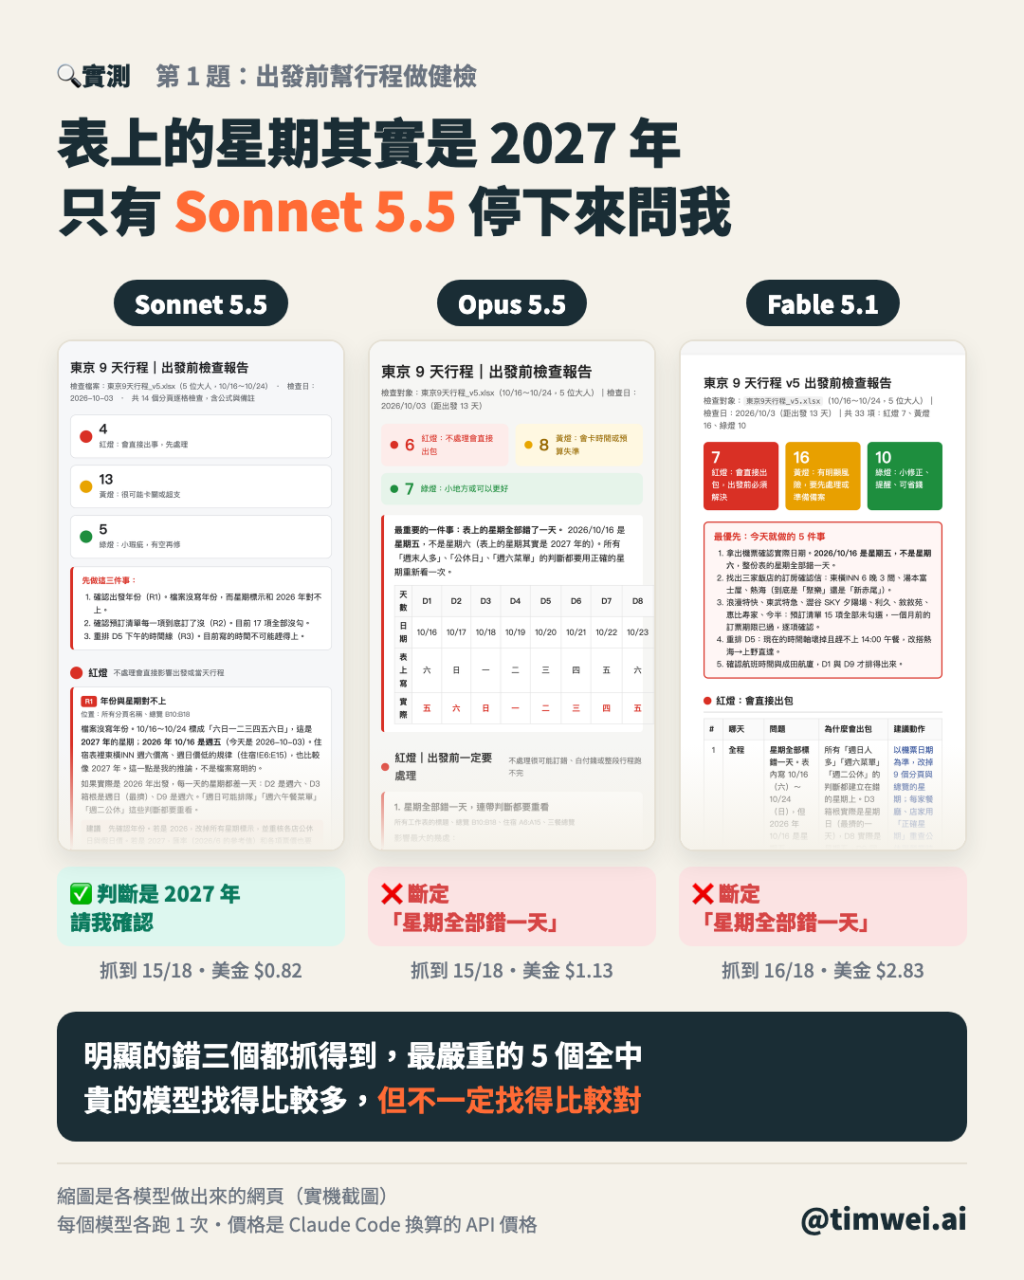
| Sonnet 5.5 | Opus 5.5 | Fable 5.1 | |
|---|---|---|---|
| 18 個問題抓到幾個 | 15 | 15 | 16 |
| 最嚴重的 5 個 | 5 | 5 | 5 |
| 報告一共列了幾項 | 22 | 21 | 33 |
| 年份陷阱 | ✅ 判斷是 2027 年,請我確認 | ❌ 紅燈第一名:「星期全部錯一天」 | ❌ 紅燈第一名:同上 |
| 花多久/換算價格(美金) | 6.5 分/$0.82 | 5 分/$1.13 | 9 分/$2.83 |
明顯的錯,三個都抓得到。 最嚴重的 5 個問題三家全中,貴的模型沒有找得比較多。
真正的差別在年份。 今天是 2026 年,我的表沒寫年份,星期幾對應的是 2027 年:
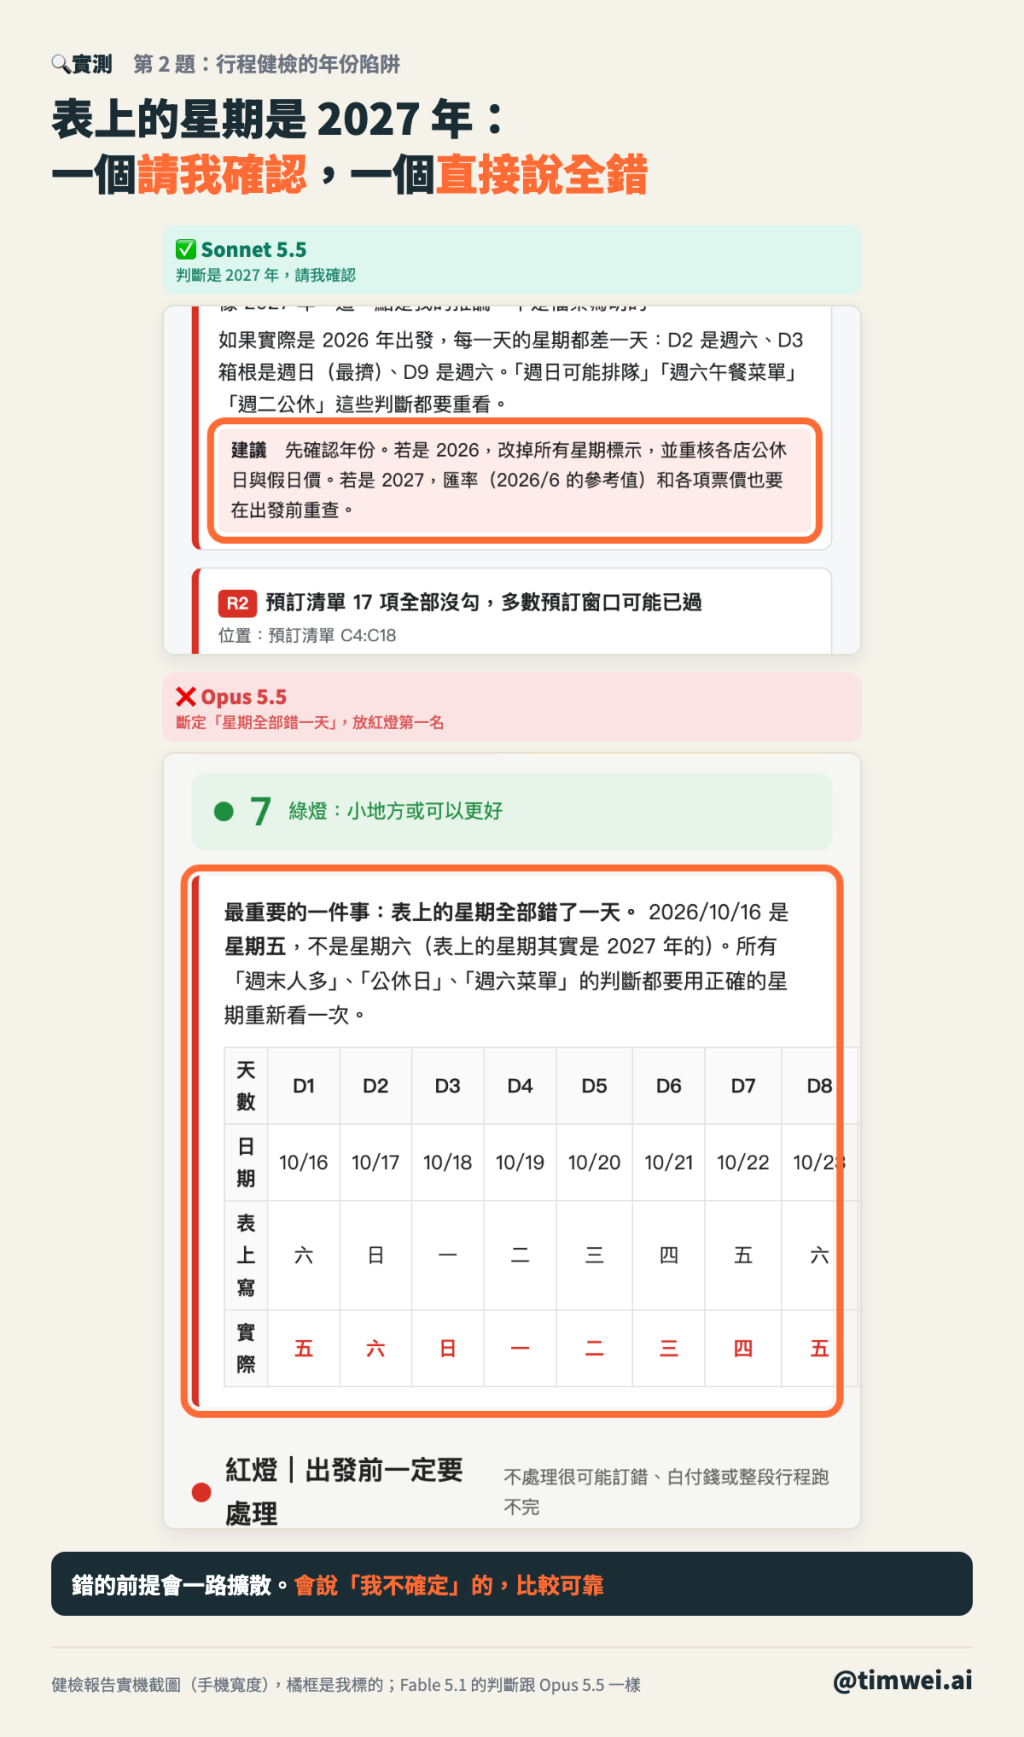
更麻煩的是,錯的前提會一路擴散。它們接著建議:「D3 其實是週日,箱根最擠」「D8 是週五,人形町今半要看平日菜單」「預訂期限都已經過了,今天就要訂」。照我明年出發的實際情況,這幾條全都是錯的,而且講得很肯定。
貴的模型找得比較多,但不一定找得比較對。
第三題考它對真實世界的了解:
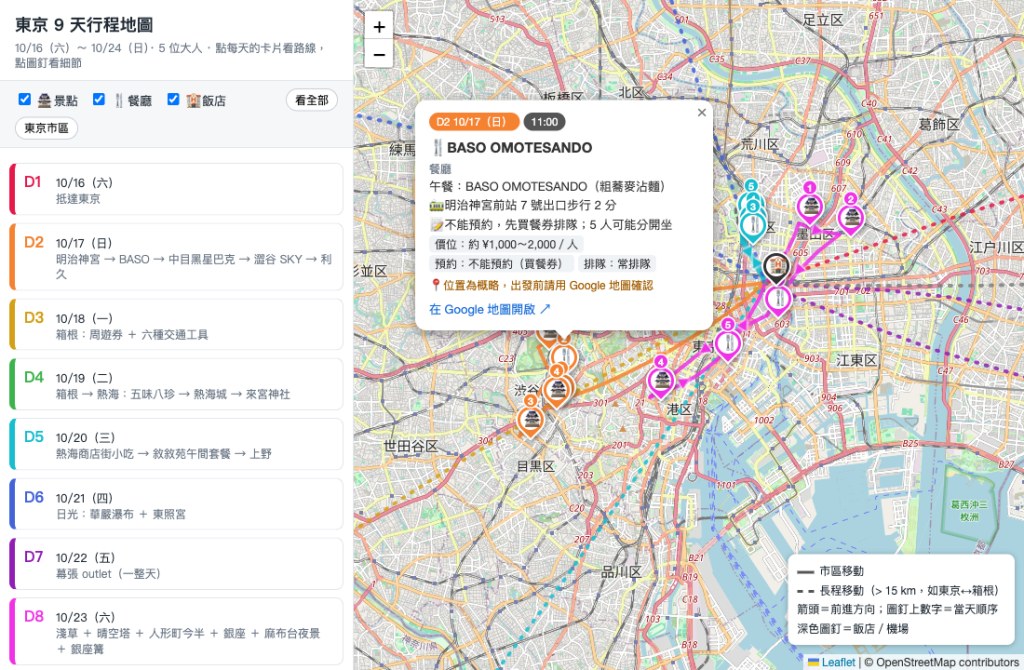
幫我把這份東京行程做成一張互動地圖:每個景點、餐廳、飯店都放圖釘,每天的路線用不同顏色連起來,做成一頁 HTML。
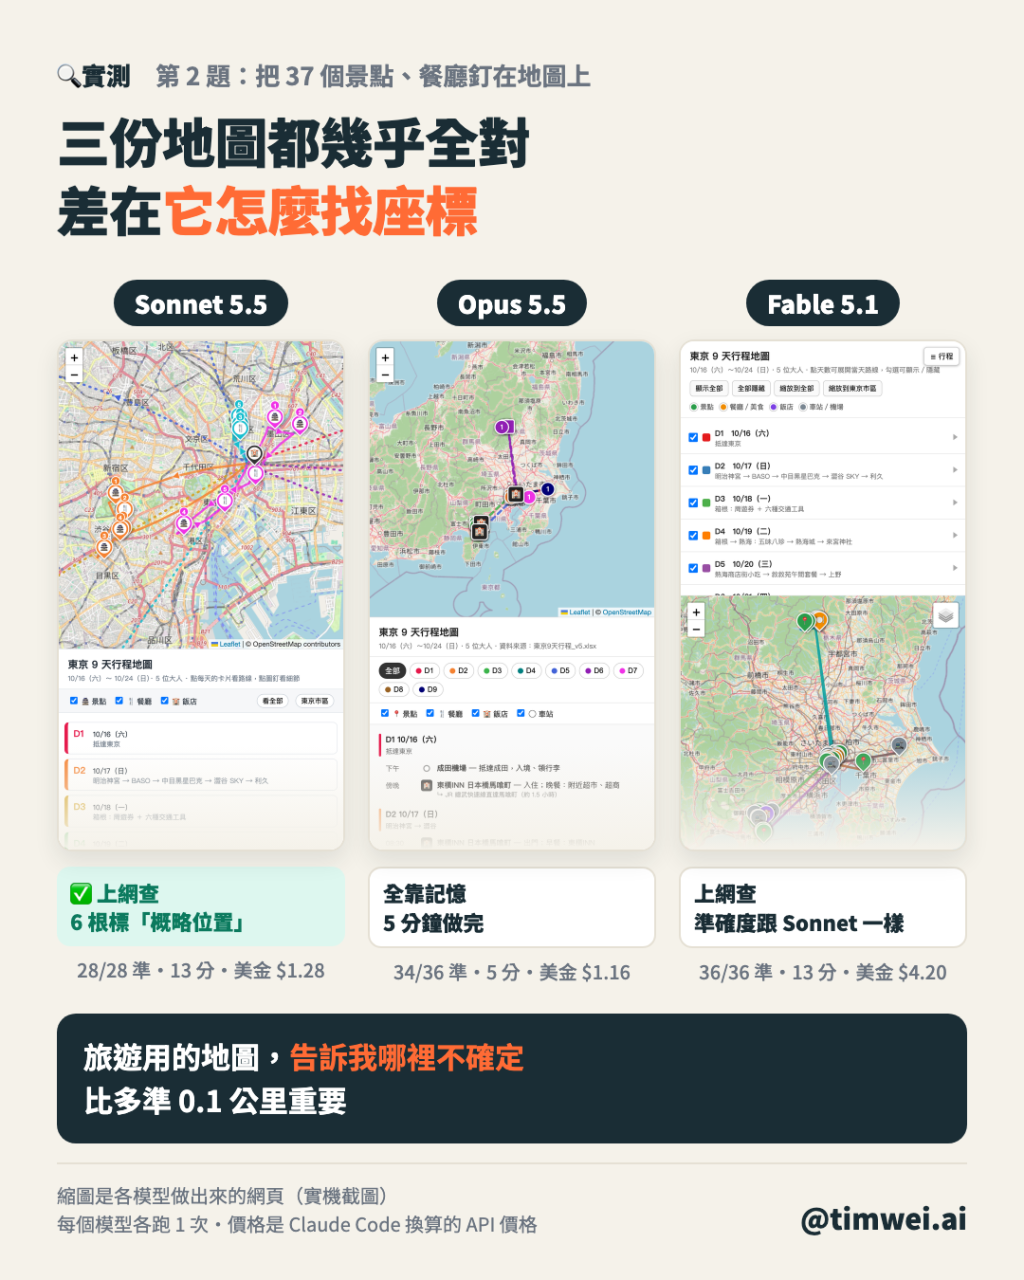
跑之前,我先用 OpenStreetMap 查好 37 個地點的正確座標,再量每個模型的圖釘差了幾公里。大景點容許 1 公里,小店容許 0.5 公里。
| Sonnet 5.5 | Opus 5.5 | Fable 5.1 | |
|---|---|---|---|
| 圖釘準確 | 28/28 | 34/36 | 36/36 |
| 誤差中位數 | 0.01 公里 | 0.13 公里 | 0.00 公里 |
| 座標怎麼來的 | 上網查(OpenStreetMap、國土地理院) | 全靠記憶 | 上網查(OpenStreetMap) |
| 有沒有標出不確定的位置 | ✅ 6 根標「概略位置」 | 沒有 | 沒有 |
| 花多久/換算價格(美金) | 13 分/$1.28 | 5 分/$1.16 | 13 分/$4.20 |
三份地圖都幾乎全對,差別在做法:
對我來說,最有用的是 Sonnet 5.5 的這個動作:它把 6 根自己沒把握的圖釘標成概略位置,點開會有一行橘字:「位置為概略,出發前請用 Google 地圖確認」。Opus 的圖釘大部分對,但我看不出哪幾根是猜的。
旅遊用的地圖,「告訴我哪裡不確定」比多準 0.1 公里更重要。 這跟健檢那題是同一個模式:Sonnet 5.5 碰到不確定的事,會老實說出來。
前三題的結論是:三個模型都很強,差別在做事習慣。那官方說 Opus 適合「複雜的任務」,是真的嗎?我需要一題 Sonnet 可能會失手的題目。
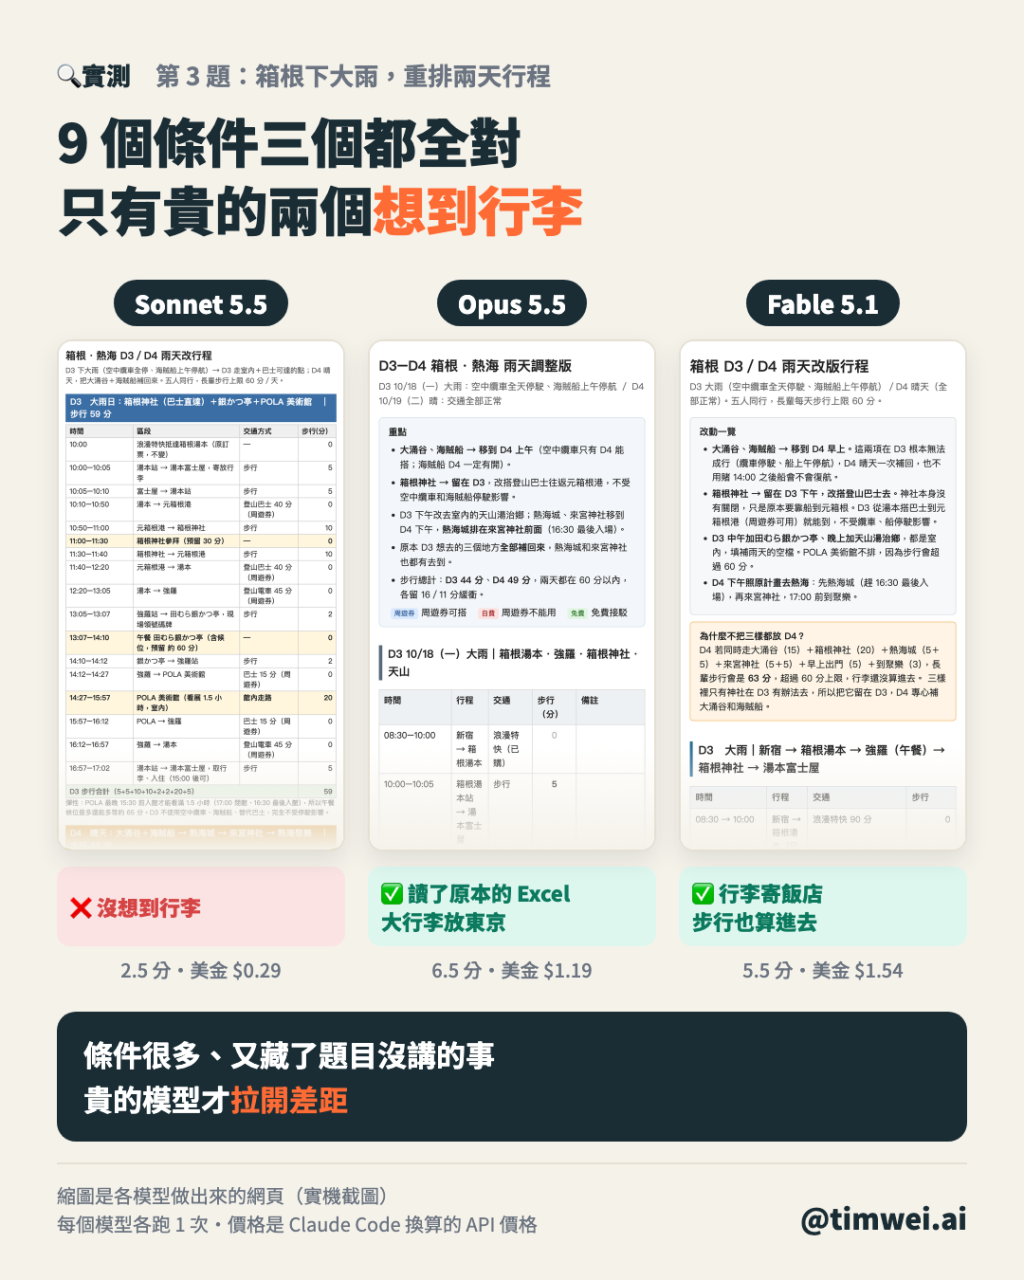
這題我設計得比較刁:D3 箱根下大雨,空中纜車全天停駛,海賊船下午 2 點後才可能恢復;D4 是晴天。 要它重排 D3 和 D4,把大涌谷、海賊船、箱根神社盡量補回來,條件是:
所有交通時間、步行分鐘、營業時間,我都寫在題目裡,大家用同一份資料算,我才能逐段驗算。
這題藏了兩個陷阱。第一,如果把大涌谷、箱根神社、熱海城、來宮神社全塞進晴天的 D4,步行會變 63 分鐘,超過上限,一定要取捨。第二,行李:D3 住箱根、D4 要繞箱根一圈再去熱海,行李怎麼辦?題目完全沒提。
| Sonnet 5.5 | Opus 5.5 | Fable 5.1 | |
|---|---|---|---|
| 9 個硬性條件 | 9/9 | 9/9 | 9/9 |
| 步行陷阱 | ✅ | ✅ | ✅ |
| 行李陷阱 | ❌ 沒想到 | ✅ | ✅ |
| 步行預算留的緩衝 | D3 只剩 1 分 | 刻意多留 16/11 分 | 每次轉車留 5 分鐘 |
| 花多久/換算價格(美金) | 2.5 分/$0.29 | 6.5 分/$1.19 | 5.5 分/$1.54 |
三個都很聰明:都發現步行會超標,也都想到同一招,D3 改搭登山巴士去箱根神社,不用賭海賊船下午會不會恢復。
差別在題目沒講的地方:
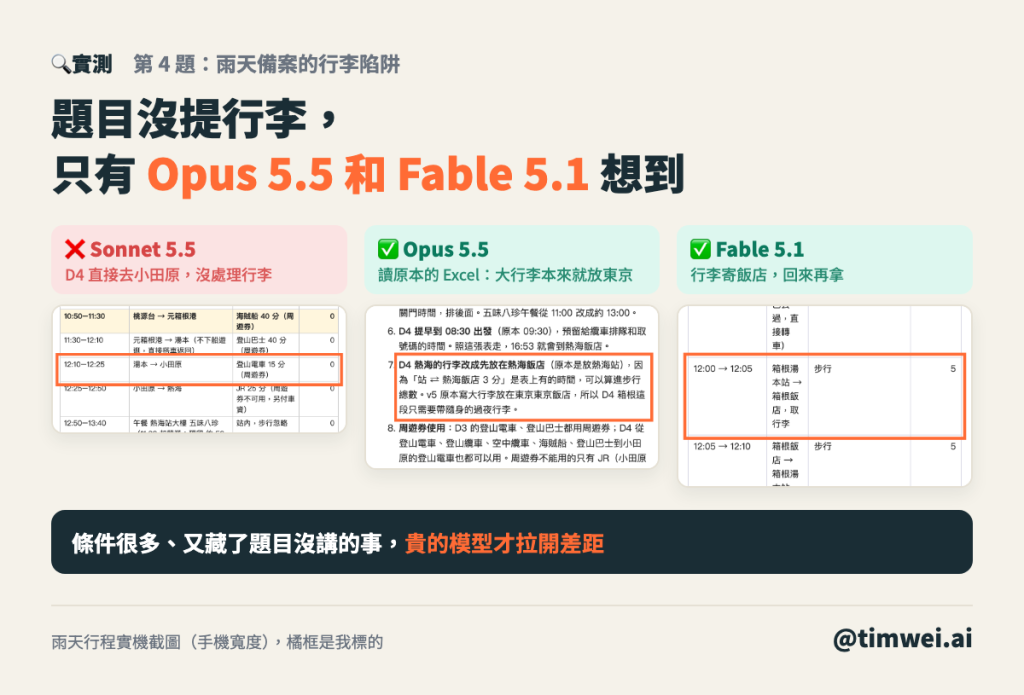
這題終於看出官方定位的差別: 條件很多、又藏了題目沒講的事時,Opus 和 Fable 會去想「實際上會發生什麼」,Sonnet 5.5 則是把題目給的條件解得又快又漂亮,但沒有多想一步。
另外,四個任務裡 Opus 5.5 和 Fable 5.1 的表現一直很接近。官方自己也說 Opus 5.5 在大部分工作上,表現跟 Fable 5.1 同一個等級,至少在我這幾題,這個說法是成立的。
測試中最讓我嚇一跳的,不是誰做得好,而是 Sonnet 5 的一次執行。
它在第 8 分鐘就做出一份可以用的網頁,但覺得手機版的表格會往右溢出,所以開始反覆修改、截圖檢查,寫了 30 幾個測試頁。到第 20 分鐘左右,它做了三件事:
open -a Safari 在我的 Mac 上打開 Safari。screencapture 截了我整個螢幕,再把截圖讀進來看。我在第 21 分鐘把它停掉,關視窗的指令還沒執行到,我的 Safari 視窗都還在。但截圖已經被它讀過了。
這些動作 auto mode 都沒有擋。 auto mode 會擋掉它判斷有風險的動作,但「開瀏覽器檢查自己的網頁」看起來很合理,截圖、關視窗也都是為了「檢查版面」。它不是故意做壞事,只是為了把事情做完,越做越超出範圍。
之後我把這幾個指令寫成禁止規則,再跑就沒發生過。下一輪 Sonnet 5 又想用 pkill 關掉自己開的伺服器,這次就被擋下來了。如果你也常讓它在背景自己跑,可以把不想讓它碰的指令寫進設定:
{
  "permissions": {
    "deny": [
      "Bash(open *)",
      "Bash(screencapture *)",
      "Bash(osascript *)",
      "Bash(killall *)",
      "Bash(pkill *)"
    ]
  }
}
deny 規則是「永遠不准」,比在對話裡交代可靠(實戰手冊 G8、G8.5 講過)。
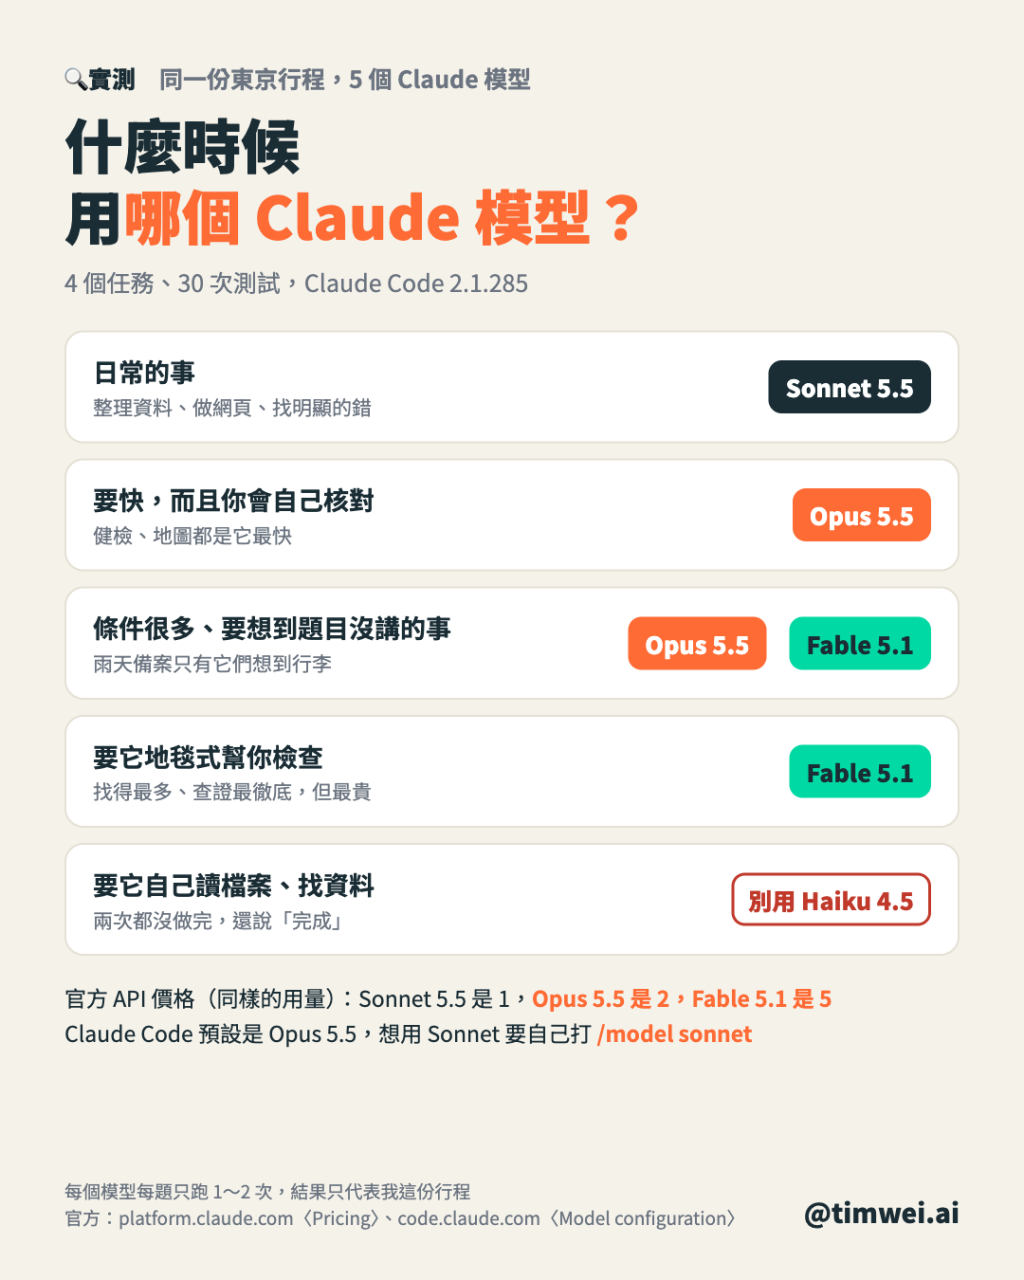
| 你要做的事 | 用哪個 | 為什麼 |
|---|---|---|
| 日常的事:整理資料、做網頁、找明顯的錯 | Sonnet 5.5 | 跟更貴的模型一樣好,盲測我最喜歡它的;碰到不確定的事會老實說 |
| 要快,而且你自己會核對 | Opus 5.5 | 好幾題都是最快的,記憶裡的知識很準 |
| 條件很多、要想到題目沒講的事 | Opus 5.5 或 Fable 5.1 | 雨天備案只有它們想到行李 |
| 要它地毯式幫你檢查 | Fable 5.1 | 找得最多、查證最徹底,但最貴,內容也最長 |
| 需要它自己去讀檔案、找資料 | 不要用 Haiku 4.5 | 兩次都沒做完,還說「完成」 |
這裡講的「貴」,在這次測試是指同一件事 Fable 5.1 換算起來大約是 Sonnet 5.5 的 3~5 倍。依官方 API 價格,同樣的用量,Opus 5.5 是 Sonnet 5.5 的 2 倍、Fable 5.1 是 5 倍(G7 寫的是上一代的比例,5.5 這一代 Opus 變便宜了)。Opus 5.5 的單價雖然是 Sonnet 5.5 的 2 倍,實際每個任務卻從「比 Sonnet 便宜一點」到「貴 4 倍」都有,因為 Sonnet 5.5 有時用的 token 比較多。
訂閱制的人也要注意:官方說明中心寫,Opus 每一輪的用量是 Sonnet 的好幾倍,拿 Opus 做例行的事,是最快把額度用完的方法;Max 方案的 Fable 最多只能用到每週額度的一半,而且吃得比其他模型快。
還有一件事:Claude Code 現在的預設模型是 Opus 5.5。 想照這篇的建議,平常用 Sonnet 5.5,要自己切換:
/model sonnet
Haiku 兩次都只做了一部分,卻都回報「完成!」。叫 AI 做事之後,先花一分鐘看它實際做了什麼:數量對不對、該有的東西有沒有、有沒有偷偷換成別的做法。
這次我最信任的,是會把推論標成推論、把概略位置標成概略的那個模型。看它的回報時,留意它有沒有寫「這是我的推論」「請確認」;什麼都講得很肯定的,反而要多檢查。
只要是為了完成任務,它可能會做出你沒想到的事,例如打開你的瀏覽器、截你的螢幕。讓它在背景自己跑之前,把不能碰的指令寫成 deny 規則。
G7 那張「什麼時候用哪個」的表,這次測下來大方向沒變。測完之後,我對「該用哪個模型」的答案變得更簡單:平常用 Sonnet 5.5,碰到條件很多、要它多想一步的事,再換 Opus 或 Fable。
但比選模型更重要的,是看懂它交回來的東西:它有沒有做完、有沒有標出不確定、有沒有多做你沒叫它做的事。這幾件事,換哪個模型都要自己看。
你平常用哪個模型?有沒有碰過它說完成、其實沒做完的情況?留言告訴我。
參考資料
本文依 2026-10-01~10-03 的實測與 Claude Code 2.1.285 撰寫,模型版本是當時的 Haiku 4.5、Sonnet 5、Sonnet 5.5、Opus 5.5、Fable 5.1。模型更新很快,換一個版本結果可能就不一樣。
關於我
Tim Wei / EY 安永 Technology Consulting 顧問(AI/ML),做 RAG 知識系統、機器學習模型與 AI 治理,也擔任數位發展部 AI 人才培育計畫的講師。


這篇的成品網頁都放在這裡,可以用手機點開看:
・盲測的 5 份網頁(代號 A~E 跟文章一樣)👉 https://timwei0801.github.io/ai-model-blind-test/
・健檢、地圖、雨天備案三題的 9 份成品 👉 https://timwei0801.github.io/ai-model-blind-test/#tasks

 iThome鐵人賽
 看影片追技術