

今天講一個讓人不太舒服的主題:
官方的工具和文件,也不可全信。
而且這一篇跟 AI 直接相關。因為其中一個失效,就是 AI 讀網頁之後給了錯誤的答案。
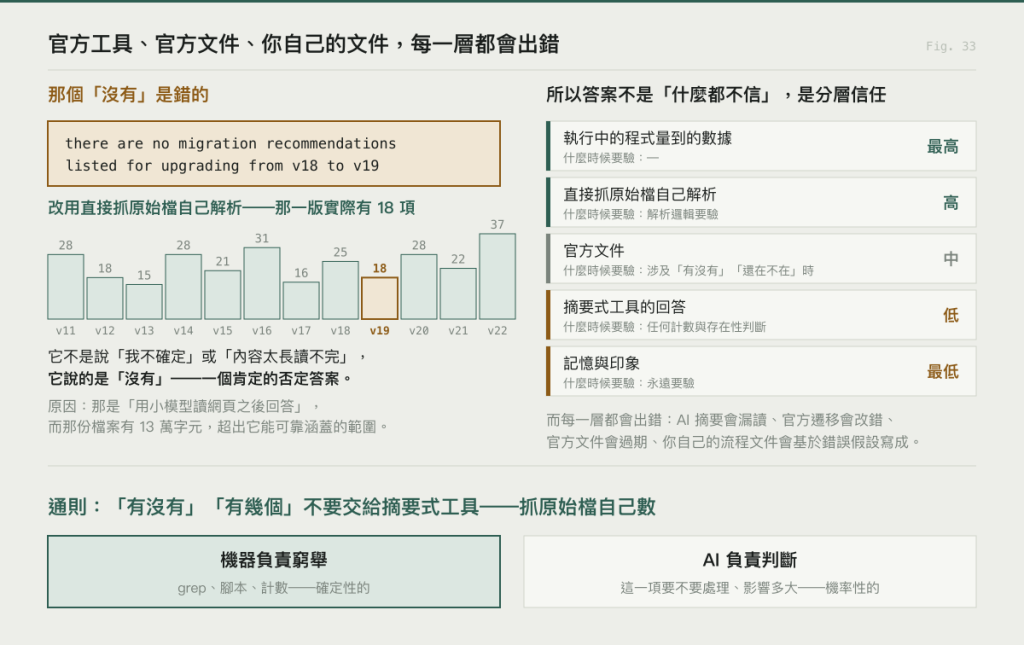
那個案子的標準作業程序裡有一步:每次升級前,先查官方的遷移建議清單。 某一版升級時,用 AI 的網頁擷取工具去查,得到的回答是:
there are no migration recommendations listed for upgrading from v18 to v19
(沒有列出從 v18 升到 v19 的遷移建議)
這是錯的。
改用直接抓原始檔自己解析之後,得到的分布是:
各版本的建議項目數:
  v11:28   v12:18   v13:15   v14:28   v15:21   v16:31   v17:16
  v18:25   v19:18   v20:28   v21:22   v22:37
那一版實際有 18 項。
而且那個檔案裡還有後面幾個版本的資料。28 項、22 項、37 項,全部都在。如果照那個「沒有」的答案走,那一次升級會在完全沒查手冊的情況下進行。
原因不神秘:那個工具是「用小模型讀網頁之後回答」。
而那份檔案有 13 萬字元。超出它能可靠涵蓋的範圍。
所以它讀了一部分、沒讀到目標段落,然後回答「沒有」。
注意它的失效方式:它不是說「我不確定」或「內容太長讀不完」,它說的是「沒有」。
一個肯定的否定答案。
那個回顧下的通則我覺得非常實用:
凡是「有沒有」「有幾個」的判斷,不要交給摘要式的工具。
抓原始檔自己數。
正確的做法就是幾行指令:抓檔案、grep 出所有版本標記、排序、計數。
curl -sL -o /tmp/rec.ts <原始檔網址>
grep -o "possibleIn: *[0-9]*" /tmp/rec.ts | grep -o "[0-9]*$" | sort -n | uniq -c
這是確定性的,而前面那個是機率性的。 又一次 Day 22 講的那條原則:確定性的問題要用確定性的機制解。
我想把這件事講深一點,因為它是整個系列裡少數直接針對 AI 使用方式的教訓。「摘要式工具會漏讀然後回答沒有」這個失效模式,會出現在很多地方:
這三種問法全部是高風險的。 因為 AI 的回答形式是「有」或「沒有」,而它的失效形式也是「有」或「沒有」。**你從答案的形狀看不出它有沒有讀完。**我自己的處理原則是:
| 問題類型 | 交給誰 |
|---|---|
| 「有沒有 X」「有幾個 X」 | grep / 腳本,不要問 AI |
| 「這段 X 是什麼意思」 | 可以問 AI |
| 「這兩個 X 哪裡不一樣」 | 可以問 AI,但要給它明確的兩份輸入 |
| 「找出所有的 X」 | 先用 grep 列出來,再讓 AI 逐一判斷 |
最後一行是我最常用的組合:**機器負責窮舉,AI 負責判斷。**這正好是 Day 20 那句「AI 負責覆蓋率,人負責判斷力」的工具版。只是這裡覆蓋率交給了 grep,因為它比 AI 可靠。
第二個失效更直接:**官方提供的自動遷移工具,改出來的程式碼編譯不過。**這件事的意義在於它打破一個很自然的假設:官方工具是安全的。我們願意跑自動遷移,正是因為它是官方的。它應該比我們自己手改可靠。而大多數時候確實如此。
但「大多數時候可靠」和「可以不驗證」是兩件事。
那份回顧把官方工具的失效整理成三種:
會漏改、會改錯、會亂改
三種的處理方式不同:
第三種對應到 Day 32 講的判斷表:錯了不會有訊號的,必須實測。
要。
我不希望這篇被讀成「不要相信官方工具」。正確的結論是:
自動化解機械問題,不解語意問題。
那個案子的三條安全原則之一就是這樣寫的:
框架的破壞性變更交給 schematic,
行為、樣式、第三方套件靠人工驗證。
分工很清楚:
| 交給自動化 | 保留給人 |
|---|---|
| 大量的機械性改寫(import 路徑、API 改名) | 行為有沒有變 |
| 設定檔的格式轉換 | 畫面有沒有跑版 |
| 已知的破壞性變更 | 第三方套件相不相容 |
自動遷移省下的是打字,不是驗證。
還有第三種,比較少被提到:**你自己寫的流程文件也會錯。**那個案子的升級流程文件在做到一半的時候,被回頭修正了五處與事實不符的地方。修訂記錄長這樣:
| 原本的說法 | 修正後 | 影響 |
|---|---|---|
| 某個測試框架「已被移除」 | 沒有被移除,只有另一個是 | 可整段省下遷移工作 |
| 需要在多個執行環境版本間切換 | 本機版本已滿足全部需求 | 可省下前置作業 |
| 某套件「無相容版本」 | 有,只是斷點在更後面 | 卡點位置更精確 |
| 未提及某個相依 | 補上,而且是工作量最大的一項 | 範圍評估改變 |
注意第一列和第二列——它們讓工作量變少了。
我們通常以為「查證」是為了發現隱藏的風險。但這裡有一半的修正是發現原本以為要做的事其實不用做。
而那份文件的修訂記錄裡有一句我很喜歡的話:
所有標示「✅ 已核實」的內容都附查證方式,可重跑驗證。
不是「我查過了」,是「這是我查的方式,你可以再跑一次」。這跟 Part 3 那個「驗證方法」欄位是同一個紀律。
把三種失效放在一起,會得到一個有點不安、但我認為正確的結論:
你的資訊來源,每一層都會出錯。
AI 讀網頁的摘要   → 會漏讀然後回答「沒有」
官方的自動遷移    → 會漏改、改錯、亂改
官方文件          → 會過期、會有例外
你自己的流程文件  → 會基於錯誤的假設寫成
那要怎麼辦?答案不是「什麼都不信」,是分層信任:
| 來源 | 信任度 | 什麼時候要驗 |
|---|---|---|
| 執行中的程式量到的數據 | 最高 | — |
| 直接抓原始檔自己解析 | 高 | 解析邏輯要驗(Day 32 那個 grep 空白的坑) |
| 官方文件 | 中 | 涉及「有沒有」「還在不在」時 |
| 摘要式工具的回答 | 低 | 任何計數與存在性判斷 |
| 記憶與印象 | 最低 | 永遠要驗 |
而 Day 32 那條判準仍然適用:錯了會靜默放過缺陷的,往上一層驗。
明天講 Part 4 的最後一個結構性問題。安全網不對稱,會決定你敢改什麼。


 iThome鐵人賽
 看影片追技術