
昨天講的是 Naur 那句話:產物不是程式碼,是人腦中的理論。而理論會隨著人的離開而消亡,重建它「嚴格說來不可能」。那句話如果停在感嘆,它就只是一句漂亮的話。今天把它落到四件實務上:逆向工程到底在做什麼、分工怎麼切、什麼情況不能只靠它、產出該長什麼樣。
有了上面的鋪陳,可以講第一個實務結論了。
很多人第一次用 AI 做逆向工程時,心裡的模型是「翻譯」。把程式碼翻成人話、把舊語言翻成 Use Case。
如果只是翻譯,那產物的正確性就等於程式碼的正確性。
問題是舊系統的程式碼本身就有一堆問題。 十五年的系統裡有 bug、有從來不會執行的分支、有當初趕上線臨時加的判斷、有某個人離職前沒改完的東西。如果目標是「忠實翻譯」,那你會忠實地把這些東西全部搬進新系統。
所以逆向的目標不是翻譯,是復原理論。不只是「它做了什麼」,還包括「這樣做合不合理」「當初為什麼這樣做」。
而後面這兩件事,不在程式碼裡。
這導出整個做法最核心的設計:
| 角色 | 負責什麼 | 禁止什麼 |
|---|---|---|
| AI | 完整覆蓋所有分支、標註信心等級、列出 bug 候選 | ❌ 自行判斷「這是 bug 要修」❌ 跳過看不懂的邏輯不寫 |
| 工程師 | 校對來源行號、補齊非程式碼資產、維護版本綁定 | ❌ 把 AI 產出當最終版❌ 替業務方決定商業規則 |
| 業務方 | 回答「現行行為是否合理」、補商業規則來源、簽核 | ❌ 只看摘要不看細節 |
濃縮成一句:
AI 負責「什麼在發生」,
業務方負責「該不該這樣發生」,
工程師負責「把這兩者對齊,而且可追溯」。
**「AI 不可以自行判斷這是 bug 要修」**這條特別重要。發現 bug 是好事,但如果 AI 在產規格的時候順手把它「修正」進去,那份規格就同時混雜了現況和提案,而沒有人知道哪裡被動過手腳。
正確做法是:發現了,另外記錄,不要動主文件。
這一段我認為最重要,但最少人講。
大部分討論 AI 逆向工程的文章都在講「可以怎麼用」。而我認為該先講清楚哪些情況不能只靠它:
| 情境 | 為什麼不行 |
|---|---|
| 新功能需求 | 逆向產的是現況,不是該有的樣子 |
| 涉及法規或合約的規則 | 程式碼裡不含法規出處 |
| 涉及金額計算 | 把 bug 當規格的風險極高 |
| 涉及權限邊界 | 誤解權限邊界等於資安事故 |
這張表背後只有一句話:
AI 逆向工程只解決「覆蓋率」問題,不解決「正確性」問題。
它能保證所有分支都被掃過,但它不會問「這段邏輯該不該這樣」。因為它沒有立場,也沒有業務知識,更不知道三年前那次客訴。
四個驗收標準。
一、每條邏輯綁定來源與版本。 檔名加行號,加上「以哪個 commit 的舊系統為準」。因為遷移期間舊系統常常還在改。有行號才回得去;沒有,這份文件就只是另一種形式的幻覺。
我看過一個逆向試點的紀錄寫著「每份規格平均 12 條檔名加行號的佐證」,並註明「不是臆測,是可回查的事實」。
二、標註信心等級,而且標低的優先送審。 把有限的審核資源導向最該被看的地方。
三、bug 候選獨立成檔。
四、產出「未知清單」,而且不能是空的。 如果它真的空了,我第一個反應不是「太好了都很清楚」,而是「這輪掃描是不是不夠認真」。
明天講怎麼確保「走完了」。
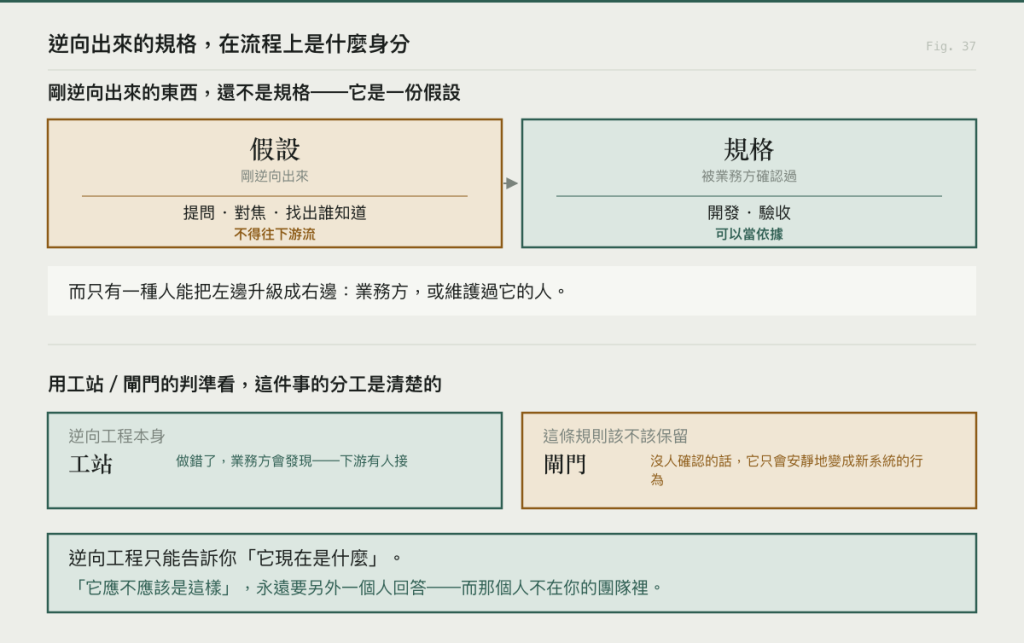
還有一件事必須釘死,不然前面的分工會在第一週就鬆掉:**逆向產出的那份規格,在被業務方確認之前,它不是規格。**它是一份假設。而假設跟規格的差別,在流程上是可以標出來的:
| 假設(剛逆向出來) | 規格(被確認過) | |
|---|---|---|
| 可以拿來做什麼 | 提問、對焦、找出誰知道 | 開發、驗收 |
| 誰能把它升級 | 業務方或維護過它的人 | — |
| 沒人確認時的處置 | 標記為未確認,不得往下游流 | — |
用 Day 19 那個判準看:逆向工程本身是工站。它做錯了,下游還有人(業務方)會發現。而「這條規則到底該不該保留」是閘門。沒有人確認的話,不會有任何機制告訴你它是錯的,它只會安靜地變成新系統的行為。
還有一個接點值得標出來:Day 07 那三個標籤(複製/改版/新做),在這個階段就該被貼上了。逆向出來的每一條行為,都要回答「它是要被複製的規格,還是要被丟掉的負債」。而這個問題,逆向工程本身答不了。
逆向工程只能告訴你「它現在是什麼」。
「它應不應該是這樣」,永遠要另外一個人回答。
明天講怎麼確保自己「真的走完了」。因為逆向工程最危險的不是做錯,是做了八成然後以為做完了。



 iThome鐵人賽
 看影片追技術