
行情跟下單的路徑上如果有防火牆,每個封包都要多經過這一台設備,花多少時間要看封包是由硬體轉發還是由 CPU 處理。防火牆會替每一條流量建立一筆 session(依來源、目的 IP、port 與協定區分的紀錄)。新 session 開頭的封包由 CPU 比對 policy、建立 session,符合加速條件的話,FortiGate 把這筆 session 寫進專用的網路處理器,之後的封包就由網路處理器直接轉發,稱為硬體加速(hardware acceleration);沒有加速的 session,每個封包都由 CPU 處理。今天把一台 FortiGate 201G 接進量測路徑,比較硬體加速開與關時,封包經過防火牆的延遲,結果有三點:
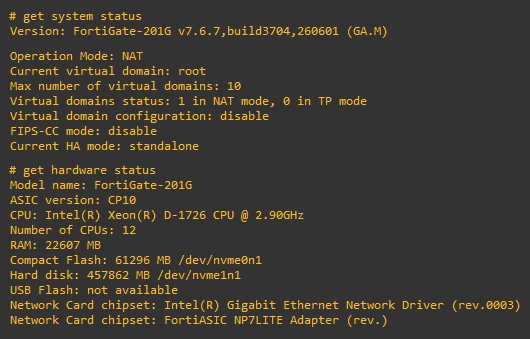
受測設備是 FortiGate 201G,版本 FortiOS 7.6.7,硬體加速由 NP7Lite 網路處理器負責。不同晶片能加速的項目不同,各版本的預設值也可能不一樣,以下數字只代表這個組合:
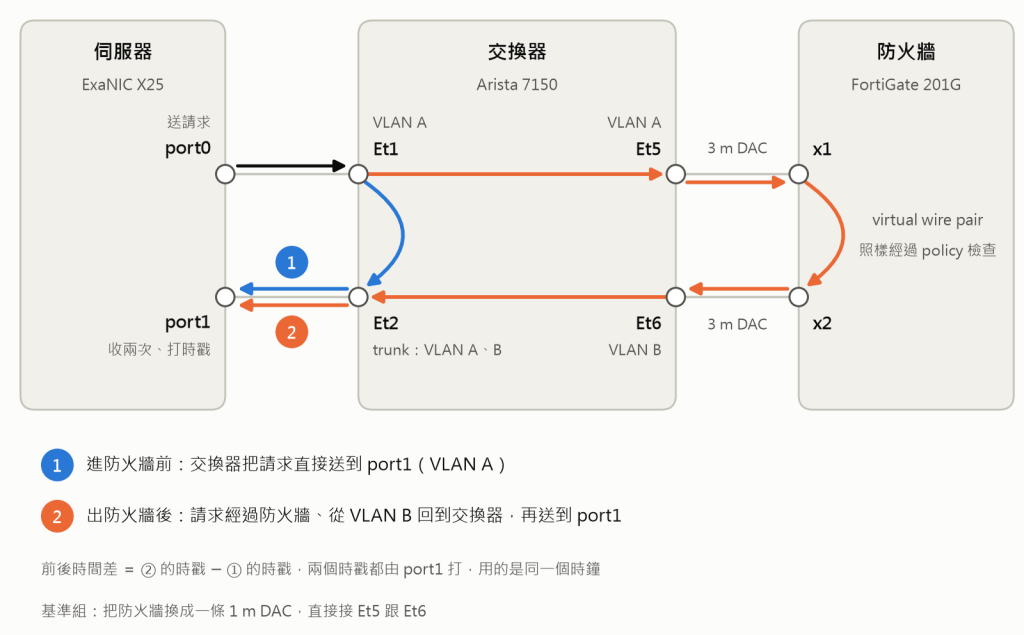
防火牆的 x1、x2 設成 virtual wire pair(兩個 port 像一條線一樣直接接通,不用設 IP,封包照樣要經過 policy 檢查),各用一條 3 m 的 DAC 接到交換器兩個不同 VLAN 的 port,量測拓樸如下圖:
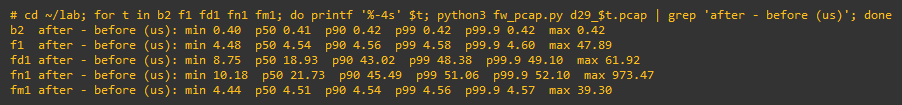
| 情境(截圖裡的名稱) | 前後時間差中位數 | 防火牆本身中位數 | 防火牆本身 p99 | session 的狀態 |
|---|---|---|---|---|
| 基準組,直接接線(b2) | 0.41 µs | — | — | — |
| 硬體加速開(f1) | 4.54 µs | 4.10 µs | 4.14 µs | 已加速,CPU 只處理 2 個封包 |
| 關掉硬體加速(fd1) | 18.93 µs | 18.49 µs | 47.94 µs | 沒加速(disabled-by-policy),10000 個都由 CPU 處理 |
| 每個封包換一個來源 port(fn1) | 21.73 µs | 21.29 µs | 50.62 µs | 每個封包各一個 session,都沒加速 |
| 多播,加了 multicast policy(fm1) | 4.51 µs | 4.07 µs | 4.12 µs | 已加速,CPU 只處理 2 個封包 |
依「開、關、關、開」量的四輪,加速開兩輪的前後時間差中位數一樣,關掉兩輪是 18.93 與 18.97 µs,同一個設定重量最多差 0.2%,遠小於加速開與關之間 14.4 µs 的差距。下圖是表中五輪的前後時間差(截圖裡的 after - before):
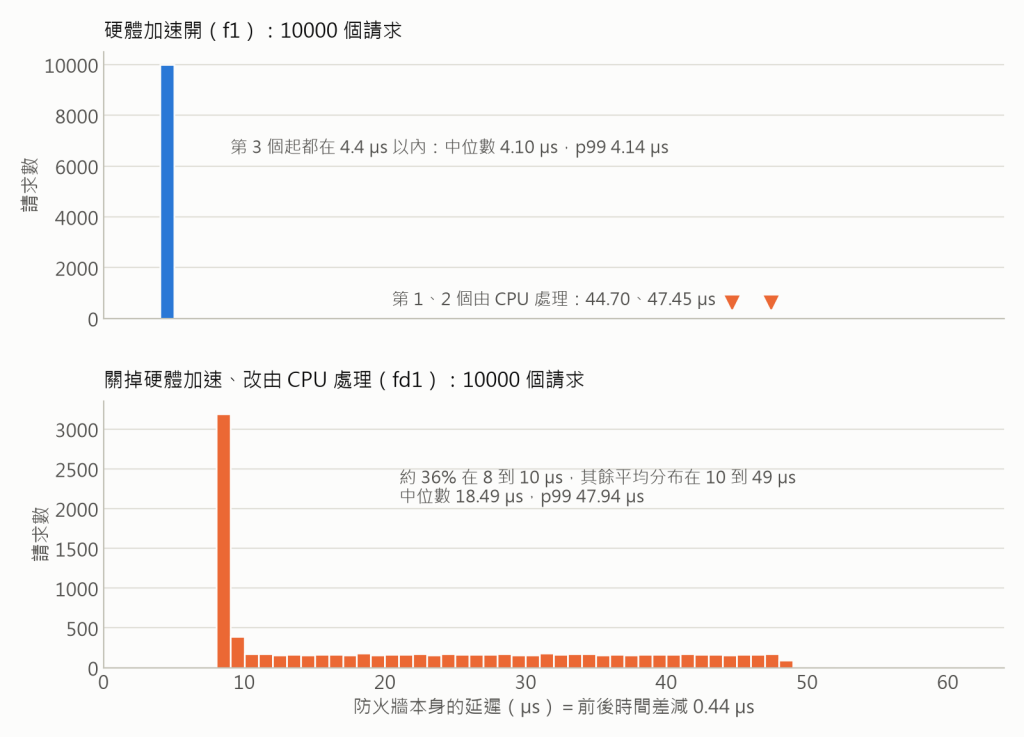
硬體加速時,防火牆本身的延遲集中在 4.1 µs 附近;改由 CPU 處理後分布很寬,約 36% 落在 8 到 10 µs,其餘大致平均分布在 10 到 49 µs。兩者差這麼多,通常是因為網路處理器用固定的硬體流程轉發,每個封包花的時間幾乎一樣,CPU 則要等中斷、排程才處理到封包,等的時間不固定。只看中位數會低估改由 CPU 處理的影響,最慢的 1%(p99)從加速時的 4.14 µs 拉長到 47.94 µs,是 11.6 倍:
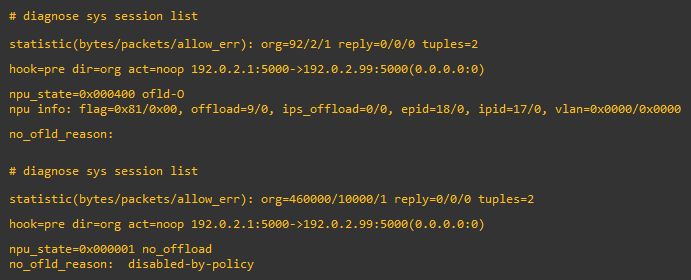
有沒有加速,用 diagnose sys session list 列出這條流量的 session 就看得到。下圖上半是硬體加速開(f1)跑完後的 session,npu_state 是 ofld-O(原方向已加速,測試流量沒有回程),statistic 只算到 2 個封包(org=92/2),其餘 9998 個由網路處理器直接轉發、沒經過 CPU。statistic 的 bytes 算的是 IP 封包長度,64 bytes 的 frame 扣掉 Ethernet 標頭跟 FCS 後是 46 bytes,2 個就是 92 bytes。下半是關掉加速(fd1)那輪,npu_state 是 no_offload,no_ofld_reason 寫出沒加速的原因 disabled-by-policy,statistic 算到 10000 個封包:
依 session 的狀態跟延遲,有三種情況封包會由 CPU 處理:
set auto-asic-offload disable),每個封包都由 CPU 處理,就是上圖下半那輪。Fortinet 文件也列出,policy 套用 proxy 模式的安全檢查(例如防毒、網頁過濾)時,session 一樣不會加速。diagnose sys session stat 顯示被加速的 session 數(npu_session_count)是 0;每個封包都要先建 session,中位數 21.29 µs,比關掉加速時還慢 2.8 µs。巡檢腳本第一次對交換器跟防火牆實際執行,結果如下:
write memory),下一次巡檢回到 OK 才算完成。show running-config 需要特權模式(privileged EXEC),用 ssh 遠端執行的指令則是在一般模式下跑。離線測試用的是存下來的指令輸出,不會遇到權限問題,所以要連上實機才看得到。腳本已改成每個指令前先執行 enable,並在交換器上確認可行。| 項目 | 怎麼看 | 異常 | 等級 |
|---|---|---|---|
| 加速狀態 | 單播用 diagnose sys session list(先設 filter,只列這條流量),多播用 diagnose sys mcast-session list |
行情、下單的 session 沒加速 | 交易時段 P1,盤後 P2 |
| policy 設定 | auto-asic-offload、安全檢查模式等 policy 設定 | 跟基線不同 | P2 |
| 經過防火牆的延遲 | 變更或升級前後,照今天的量法各量一輪 | 中位數高 5%、p99 高 10%(中位數、p99 重量最多差 0.2%) | P2 |
| session 建立速率 | diagnose sys session stat 的 setup_rate |
超過同時段基線的最大值 | P2 |
| 防火牆 CPU | get system performance status |
超過 70% | P2 |
後兩項是間接指標:新 session 開頭的封包都由 CPU 處理,建立速率突然變高,代表有大量封包沒被加速,CPU 使用率也會跟著上升。
session 建好之後封包才會加速,所以行情、下單的連線要在開盤前就建立(例如先登入、開始收行情),讓建立 session 的封包提早由 CPU 處理掉,開盤前再查一次 session 的加速狀態。交易時段中可能停頓超過 180 秒的 UDP 單播流量,可以在對應的 service(firewall service custom)上把 udp-idle-timer 設得比最長的停頓還長,只影響用到這個 service 的流量,設完照今天的量法確認停頓後的第一個封包。多播走的是 multicast policy,沒有 service 可以設,不適用這個做法;行情多播通常會定時送 heartbeat,交易時段中不會停頓這麼久。
明天把這 29 天的量法跟維運檢查整理成一份手冊。


 iThome鐵人賽
 看影片追技術