
釐清能力邊界、上手方法與成本,建立第一次使用的判斷依據。
這篇把 GPT-6 Astra 對開發者的實際用處講清楚:它是什麼、和過去的模型差在哪、能接哪些工作、怎麼開始用、要花多少錢、有哪些做不到的事,以及什麼人值得用。讀完你能判斷它適不適合接進你現在的工作,而不是只記住幾個參數。
GPT-6 Astra 由 OpenAI 開發,官方把它定位在複雜推理、程式開發、電腦操作、研究與文件產出這幾類比較吃力的工作上。它讀你給的文字和圖片,產出文字。
| 資訊項 | 內容 |
|---|---|
| 模型定位 | 面向高難度端到端工作 |
| 輸入 | 文字、圖片 |
| 輸出 | 文字 |
| 上下文視窗 | 1,050,000 Token |
| 知識截止 | 2026 年 4 月 30 日 |
規格細節見 OpenAI 官方模型文件。
有三件事要先分開:模型負責推理,讀資料、想、產出建議;開發環境提供入口,編輯器、終端機、你自己寫的程式決定它看得到什麼;工具負責執行,真正去讀檔案、跑測試的是你這一側的程式。
所以兩個常見誤解可以先排除:它不會自己打開你的專案,知識截止日期講的是訓練資料的時間、和你電腦裡的程式碼無關。它讀不到你沒給它的東西。
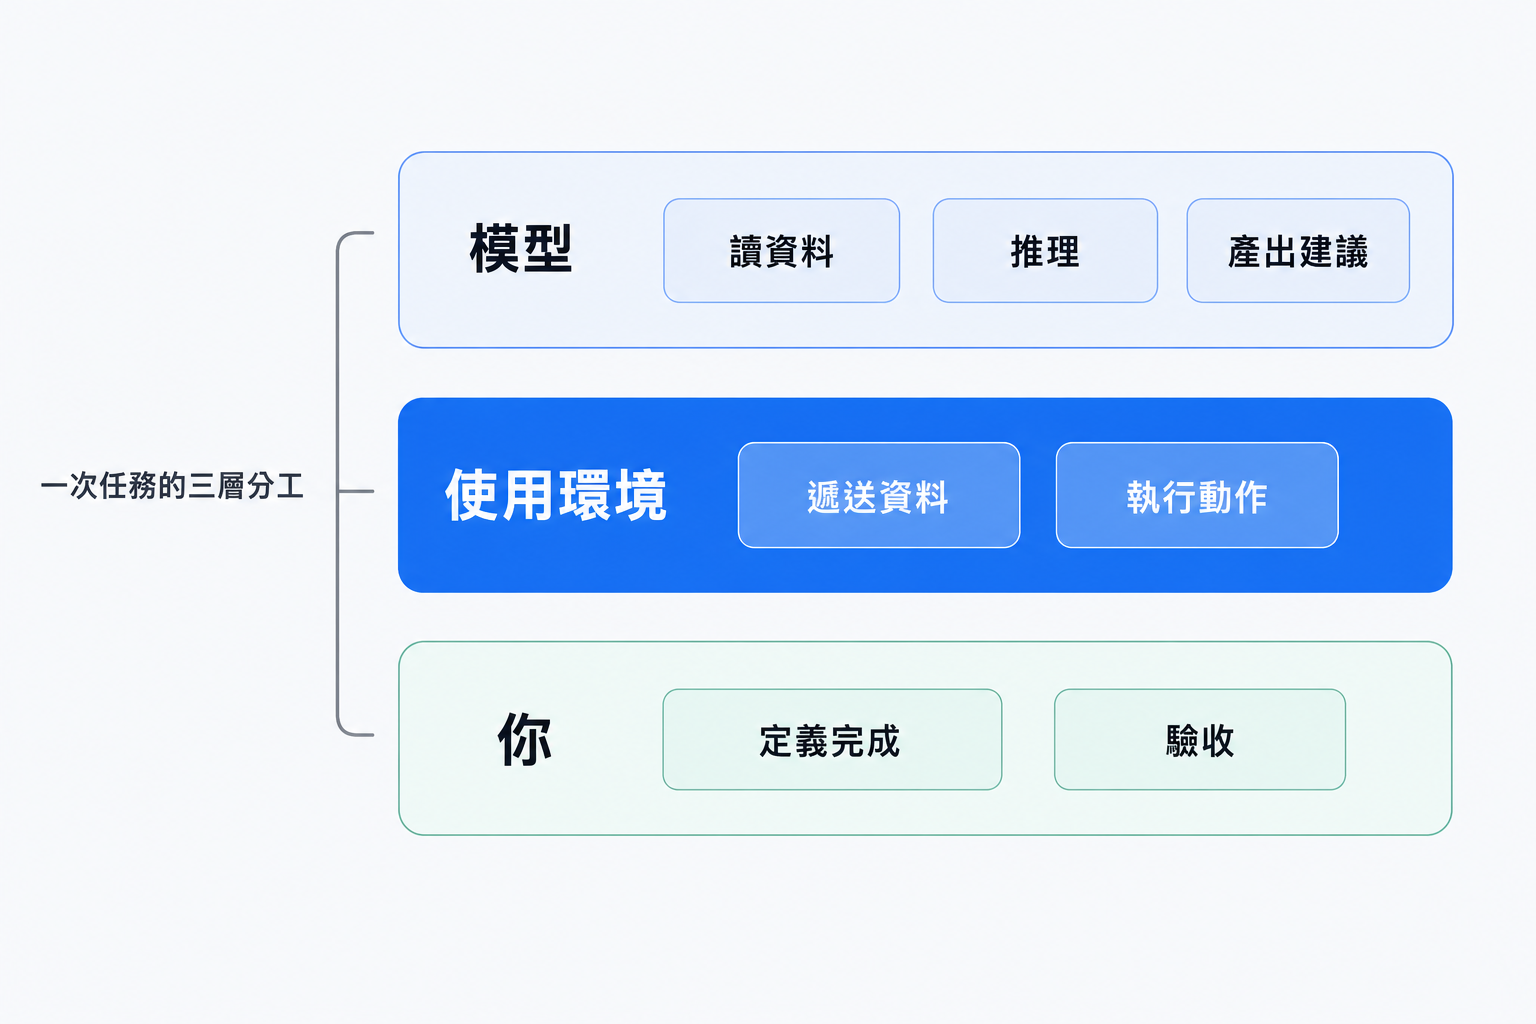
圖1:一次任務的三層分工示意圖(AI 生成),非產品截圖。
差別落在兩個地方。
第一是能一次吃下多少材料。 105 萬 Token 的視窗大約放得下一個中型專案的全部原始碼。過去處理長材料要先切片、各自摘要、再把摘要拼回去,每一道摘要都在丟資訊,最後的結論建立在二手材料上。現在可以整包丟進去,在完整脈絡下回答。接手舊專案、做架構梳理時,這個差別體感最明顯。
第二是它會把確定和不確定分開。 這點比前一點更實用。過去問一段錯誤紀錄,拿回來的通常是一段聽起來很合理、但你分不出哪句有根據的解釋。現在只要在請求裡寫一句「區分推測原因與可重現原因,並指出還需要哪些資料」,它會把三種東西分開擺:對得上紀錄的、合理但沒依據的、以及它明說資料不足的。
第三格有東西,這份回覆才可信。如果從頭到尾都很篤定、第三格是空的,那不是它比較厲害,是它在補你沒給的資料。
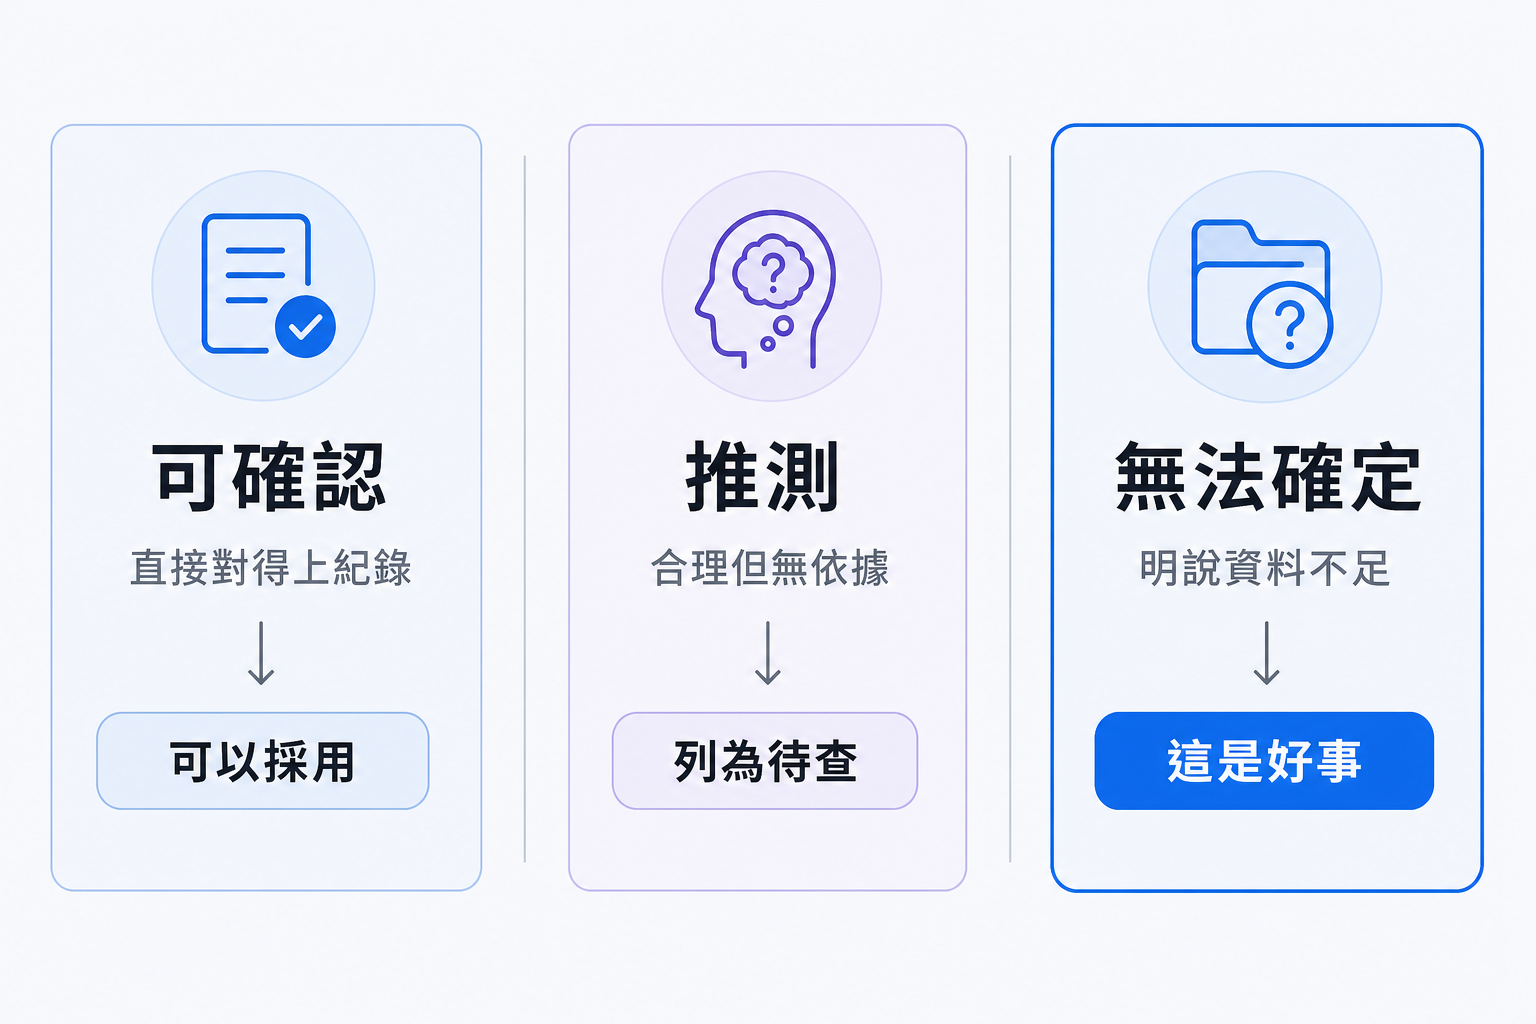
圖2:回覆分類核對示意圖(AI 生成),非產品截圖。
對開發工作來說,這四類最划算。
不划算的是語法查詢、格式轉換、簡單計算。這些用更輕的模型或現成工具更快也更便宜。
分兩條路。產品入口是 ChatGPT 這類介面,不用寫程式,適合先感受能力;具體哪些方案涵蓋這個模型,以官網當前說明和你帳號實際看得到的清單為準。API 接入則適合接進自己的流程。
接入前先確認模型標識在不在:
curl https://api.crazyrouter.com/v1/models \
  -H "Authorization: Bearer $API_KEY"
本次在 Crazyrouter 上拉到 172 個模型,gpt-6-astra 在列。接入前仍要自行確認你要用的參數在該通道上是否支援。
把任務說清楚,返工率會明顯下降。五項寫進請求裡:
其中驗收最常被省略也最影響結果。沒寫,它只能照一般習慣回答;寫了,它會主動把不符合條件的地方標出來。
| 現象 | 常見原因 | 處理方向 |
|---|---|---|
| 認證失敗(401) | Key 錯誤、過期、帶了多餘空格 | 核對 Authorization: Bearer <key> 格式;不要把 Key 寫進命令列字面量 |
| 模型不可用(404) | 標識拼錯,或該通道沒有這個模型 | 先拉 /v1/models 對標識;錯誤體會附 request id,排查時直接帶上 |
| 限流(429) | 超出當前用量檔位 | 做指數退避重試,不要原地高頻重試 |
| 逾時 | 長上下文或高推理檔位下單輪拉長 | 調大用戶端逾時;必要時降推理檔位或拆小任務 |
具體原因以服務實際回傳的錯誤體為準,不要憑狀態碼猜。
訂閱是按月付產品使用權;API 按 Token 計量。官方標準價(2026-10-13 核對):
| 計量項 | 每百萬 Token |
|---|---|
| 輸入 | $10.00 |
| 快取命中輸入 | $1.00 |
| 輸出 | $50.00 |
第二行最值得注意:命中快取的輸入只要十分之一。 這決定了划算的用法——把大段材料固定放在對話前段、問題放後段,反覆針對同一批材料提問時,後面幾輪的輸入成本會降一個量級。每次都換材料重新開始,就是滿價。另外批次處理約為標準價一半。
一次完整的除錯往往來回好幾輪,每輪都會把先前的上下文再帶一次,所以不能只看最後那段回覆的長度估成本。
另外補一句:支援某種介面,不等於支援該介面的全部參數。 官方文件明確列出它不支援微調、向量嵌入與即時介面;走第三方通道時,可用參數還可能再有差異。寫程式前先用最小請求把你真正要用的那幾個參數逐個試出來。
| 工作類型 | 結果品質 | 人工修改量 | 費用考量 | 值不值得 |
|---|---|---|---|---|
| 讀懂/維護他人的程式碼 | 整包讀比片段猜可靠 | 明顯下降 | 多輪累積,善用快取 | 值得 |
| 除錯時收斂範圍 | 能分開確定與推測 | 下降,仍需自己驗證 | 單次不高 | 值得 |
| 整理有出處的技術文件 | 帶來源、標未決問題 | 下降 | 輸出佔比高,留意 $50 單價 | 值得 |
| 語法查詢、格式轉換 | 夠用但無優勢 | 本來就低 | 明顯偏貴 | 不值得 |
最後一個建議:第一次試它,挑一件你已經知道答案的小事。你熟悉答案,才判斷得出它哪一步靠得住、哪一步在編——這個判斷力建立起來之後,才談得上把真正不確定的工作交給它。

 18924485322

 iThome鐵人賽
 看影片追技術