
以DeepSeek V4.1 Flash與GPT-6 Astra的公開評測為起點,分清模型能力、人工補救與真正省下的成本。
封面由gpt-image-2生成,為編輯插畫,並非實測截圖。
模型費用下降,通常會讓團隊想把更多程式工作交給AI。但真正困難的交接發生在後面:誰判斷修改正確?失敗時誰接手?節省的費用是否被人工重做吃掉?
Fireworks於2026年9月14日公布的DeepSWE結果很有吸引力。DeepSeek V4.1 Flash的Pass@1為74.34%,GPT-6 Astra為74.12%;平均每項任務的模型費用分別是0.430美元與6.524美元。前者採max、後者採xhigh設定,費用約差15倍。
這適合啟動試行,卻還不是全組切換的驗收單。費用優勢要成為團隊收益,還取決於能力是否匹配、修補是否完整,以及人工補救有沒有減少。
「協助開發」太寬,無法解釋成功或失敗。修正局部條件、追蹤多次呼叫後的狀態、評估架構取捨,雖然都和程式有關,卻不一定能用相同方法驗收。
試行範圍可以先由現有測試來界定:哪些問題已有固定重現方式?哪些修改可以透過相關回歸測試確認?哪些工作即使產生合理文字,仍必須由人重新建立判斷?
| 任務特徵 | 導入時先準備什麼 |
|---|---|
| 能穩定重現的缺陷 | 固定版本、觸發條件與預期行為 |
| 影響多個模組的修補 | 呼叫關係、必須保留的介面與測試範圍 |
| 缺少明確正確答案的方案分析 | 評審責任與接受標準,不套用修補通過率 |
這樣區分,不是預先判定Flash只能處理簡單工作,而是讓每一種工作都有可以比較的結果。
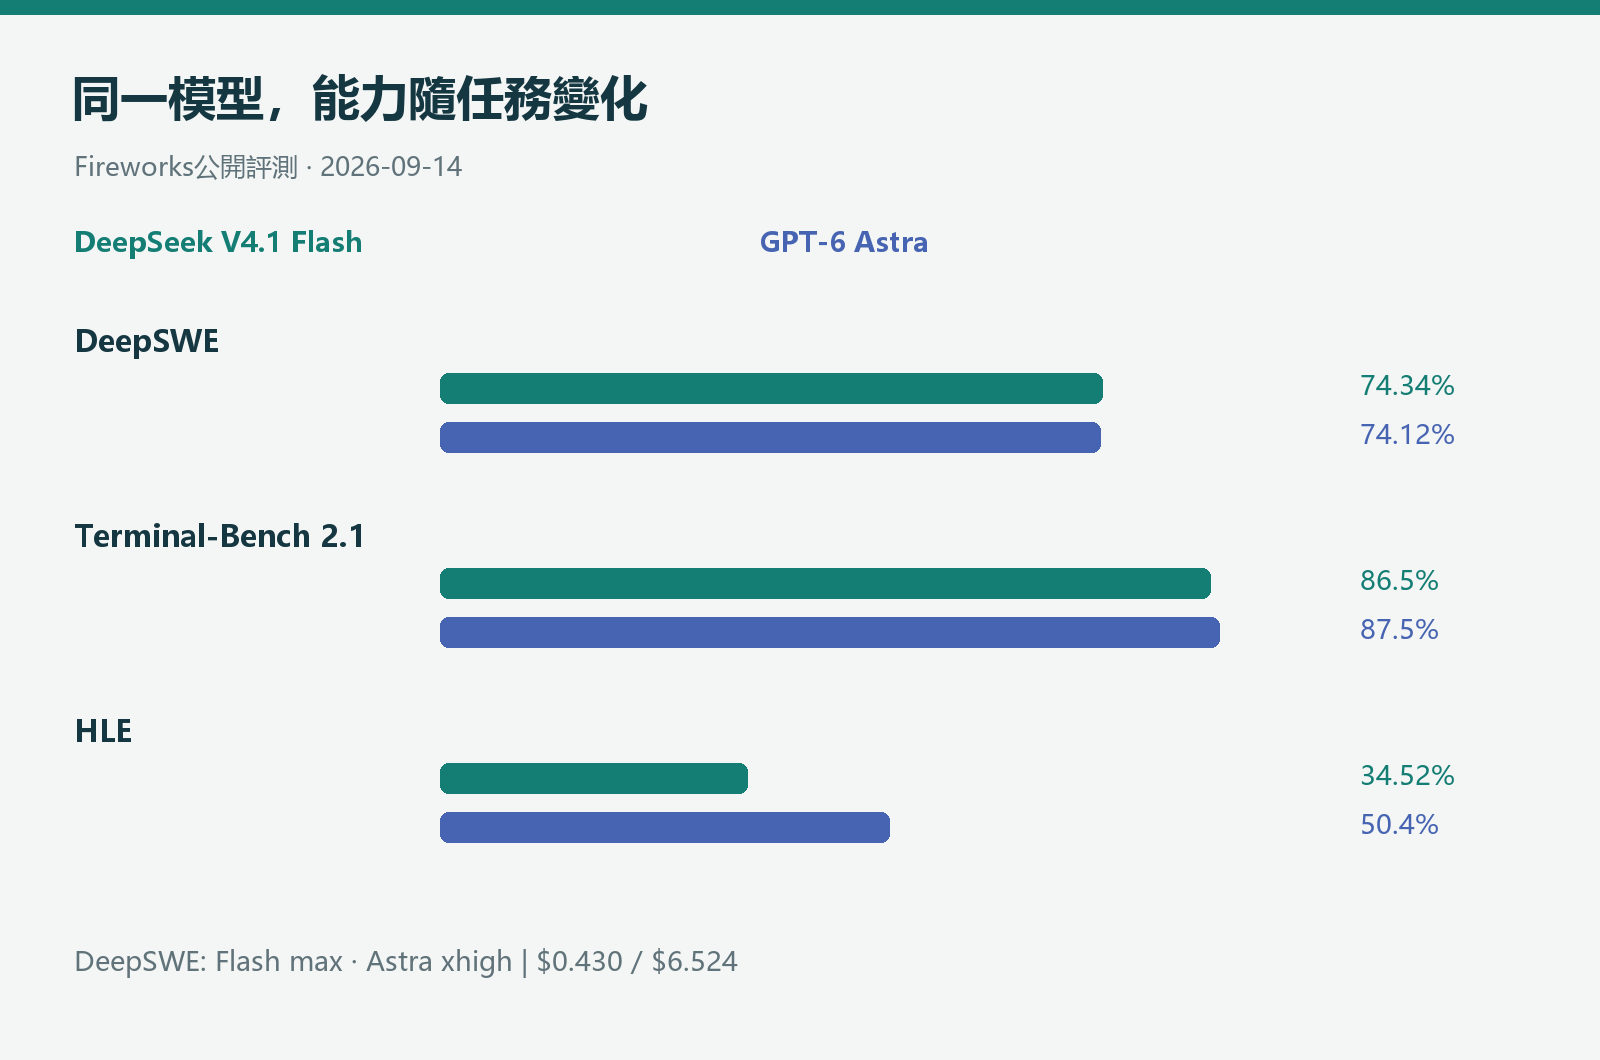
圖1|依Fireworks資料重繪。DeepSWE成績接近,不代表HLE等其他任務也有相同差距。
在HLE中,Flash與Astra分別為34.52%與50.40%;Terminal-Bench 2.1則為86.5%與87.5%。若團隊工作分布不同,單一榜單就不該成為共同預設值的唯一依據。
pytest曾有一項目錄收集缺陷:同一測試檔單獨處理正常,前面多了其他路徑後,fixture參數卻無法正確解析。重新收集目錄產生了新節點,舊fixture仍連到原節點,才是問題核心。
上游修補不是全面禁止重複收集,而是復用同路徑的Directory子節點,並保留Module與File原本的行為。這個差別提醒我們:測試綠了之前,還要問它驗證的是哪一個承諾。
另一項缺陷涉及重複使用警告物件。當警告被設為錯誤,同一實例反覆拋出時會保留舊堆疊。本地重現的第一次為3個frame,第二次變成6個。只改一個呼叫點,可以修掉眼前例子,卻不保證其他相關位置一起處理完成。
本地驗證確認了兩項缺陷與上游參考修補;這些修補不是由Flash或Astra生成,因此不構成兩款模型的工程能力對測。
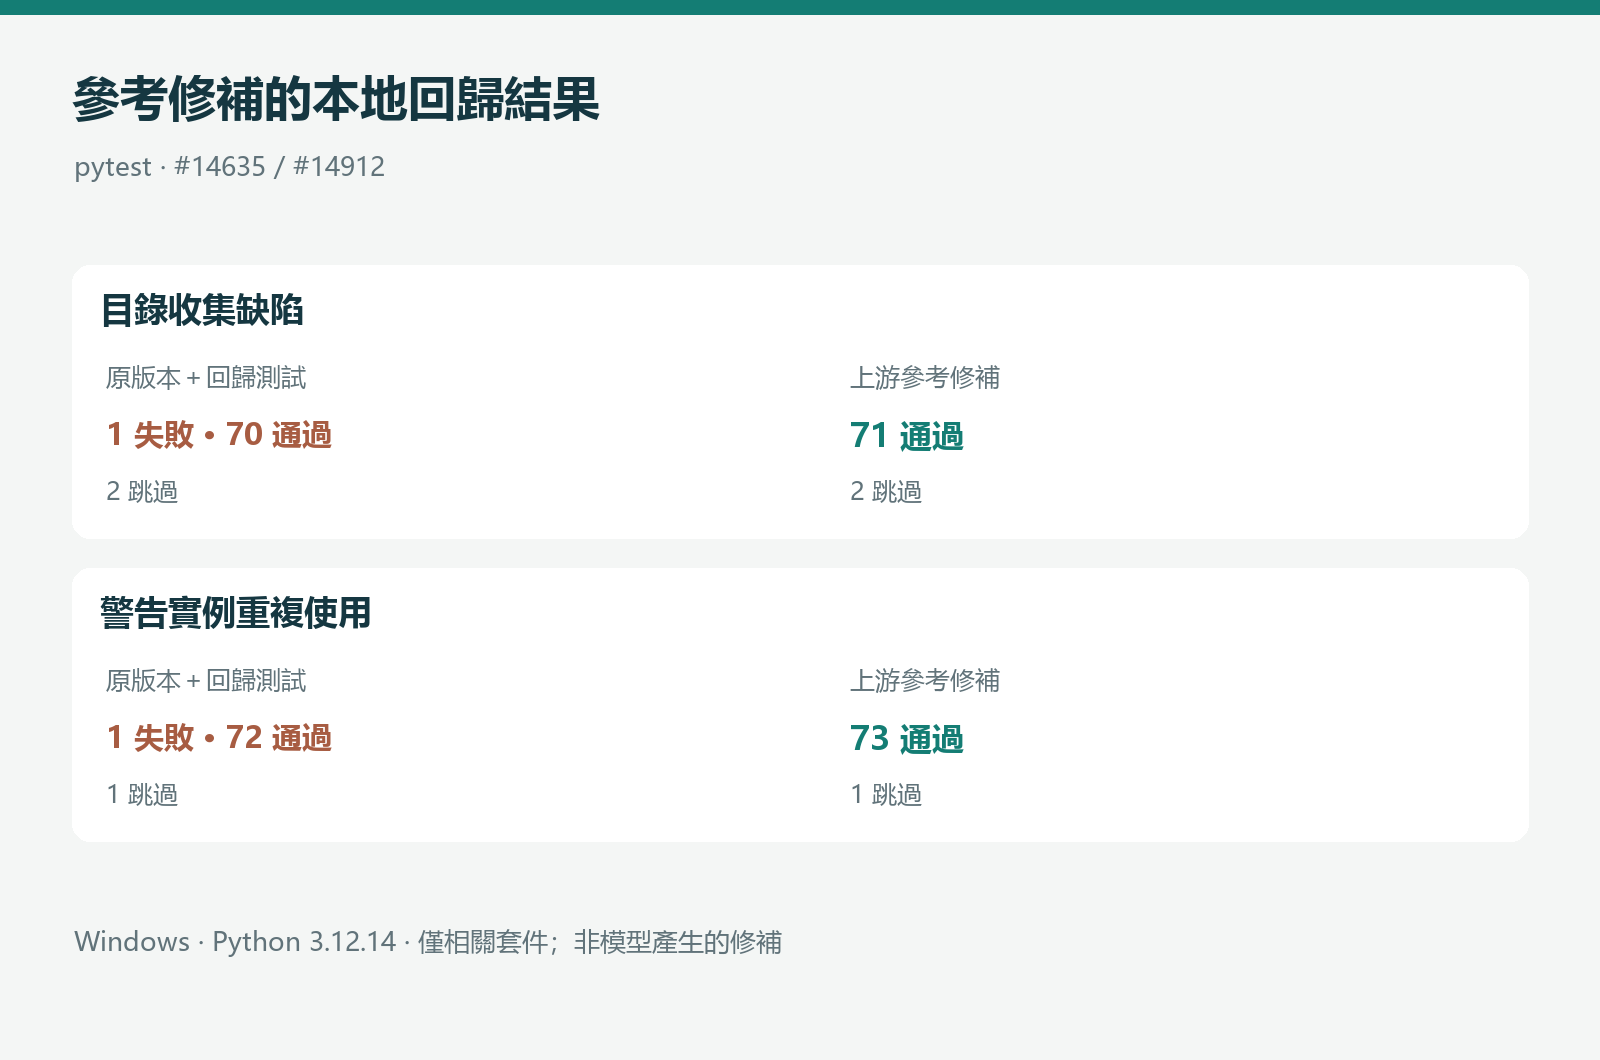
圖2|Windows、Python3.12.14下的相關套件結果。跳過項不列入通過,也未執行整個專案測試集。
實際試行時,交接單不需要很長,但應保留原始補丁、測試紀錄、漏改位置,以及人工介入的內容。只留下最後成功的截圖,後續就很難知道節省來自模型能力,還是同事默默補完了工作。
導入低成本模型,不必以一次性替換為目標。比較穩健的方式,是在相同任務類別中逐步增加使用範圍,並事先寫清楚什麼情況需要退回人工或其他模型。
例如,補丁無法通過既定回歸、修改範圍超出可審查邊界、相關呼叫點仍有漏改,都是具體的處理訊號。它們比「感覺回答不夠聰明」更容易追蹤,也更方便改善輸入材料或驗收方式。
但退回Astra不代表必然解決。接手後是否成功、增加多少呼叫與人工時間,也要留在同一份任務紀錄裡。否則成本只記前半段,成果卻算完整段,試行就會失真。
Fireworks記錄的Flash任務中,約99.6%的累計輸入命中快取;快取讀取仍占約59.9%的模型費用。這是多輪讀取累積的結果,不是單次請求的上下文長度。
因此,透過Crazyrouter等服務部署時,應以實際渠道的模型價格與計費項目核對一般輸入、快取輸入與輸出。架構效率、平台單價、整項任務支出,不能直接畫上等號。
試行結束後,最值得討論的不是「便宜模型用了多少次」,而是哪些任務在相同驗收下減少了總支出,哪些任務仍依賴大量補救。保留這份分類,下一輪導入才有可以累積的經驗。
Flash的價值不只是讓同樣預算能多呼叫幾次,而是能否在某類工作中交出同樣可靠的結果,並減少完成它所需的總支出。把能力匹配、修補完整性與補救負擔放在一起看,才能知道便宜的是回答,還是整件工作。
資料:Fireworks評測;pytest PR #14645與PR #14931。本地基線分別為eb79044cea1c2c7b6e58ebcce17c55da871fef6c、f5240bef4d8b31232d570fb80ea4f7c50b087d1b,兩組環境補充相同的建置版本中繼資料。本文以AI協助撰寫,引用資料與本地驗證範圍分開標示;核對日期為2026-10-13。

 18924485322

 iThome鐵人賽
 看影片追技術