

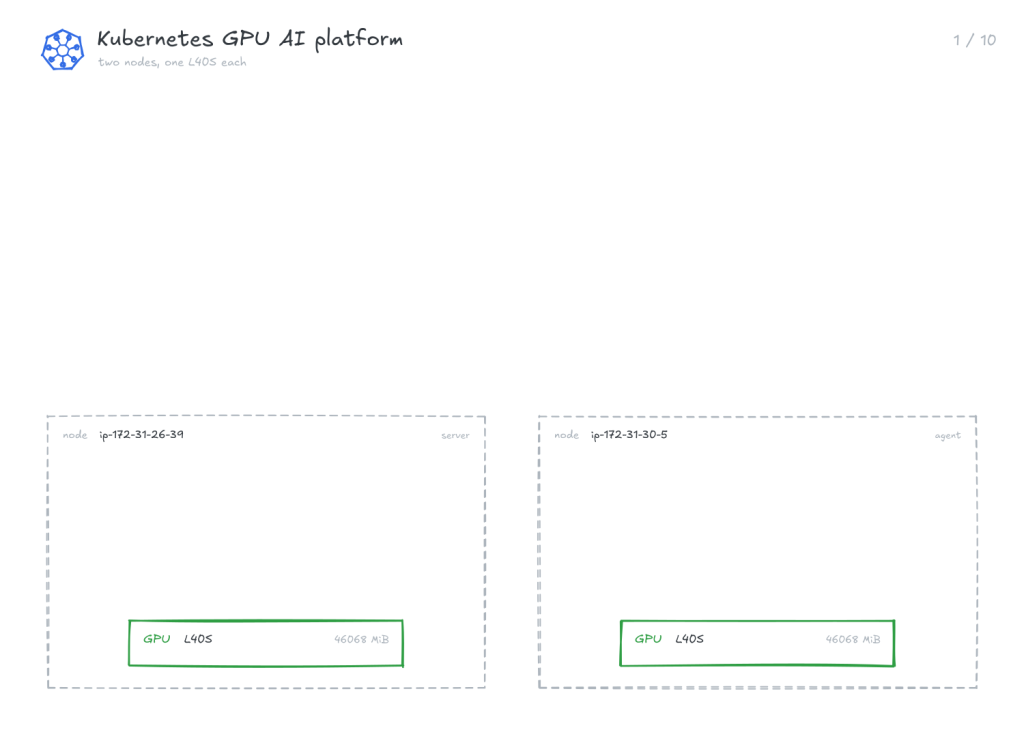
今天把過去 28 天講過的技術整合在一起,真正打造一座 Kubernetes GPU 叢集。開局你只有兩張卡,叢集裡什麼都還沒裝。
前面每一篇大多只處理一件事,各自裝、各自驗,叢集裡同時只有那一套東西在跑。接起來之後要回答的是另一組問題:卡怎麼配給 Pod、一組 Pod 怎麼排、配額誰在算、流量從哪裡進來、一發請求怎麼落到某一台引擎。k3s 之上要裝的十個元件分別負責這幾件事。
今天清理 Day 1 的環境,清到只剩兩張卡跟 Kubernetes,我們慢慢地把服務加上去,最後會給各位滿滿的 Kubernetes 大平台。
k3s 的三個啟動參數:--default-runtime nvidia 讓容器預設走 NVIDIA 的 runtime,traefik 和 servicelb 兩個內建元件關掉,流量那一層要自己裝。
| 層 | 元件 | 版本 |
|---|---|---|
| 底座 | k3s | v1.36.5+k3s1 |
| 卡 | GPU Operator(DRA 模式) | v26.7.0 |
| 卡 | HAMi k8s-dra-driver |
v0.1.0 |
| 指標 | dcgm-exporter | 4.6.0-4.8.3 |
| 排程 | Volcano | v1.15.2 |
| 配額 | Kueue | v0.19.5 |
| 工作負載 | LeaderWorkerSet | v0.11.1 |
| 流量 | Envoy Gateway | v1.8.1 |
| 流量 | Envoy AI Gateway | v0.7.0 |
| 流量 | llm-d router 的 EPP | Standalone |
| 引擎 | vLLM | 0.30.0 |
這個叢集沒有 device plugin,節點不會通報 nvidia.com/gpu 這種整數資源,所有的卡都走 DRA 配出去。
GPU Operator 預設會把驅動、container toolkit、device plugin 一起裝上去。這個叢集上驅動已經在節點裡,runtime 也接好了,所以只留 DRA driver 這一塊:clusterPolicy.deployCR=false 不建 ClusterPolicy,gpuCluster.deployCR=true 改建 GPUCluster,driver 和 toolkit 兩個子元件不裝。
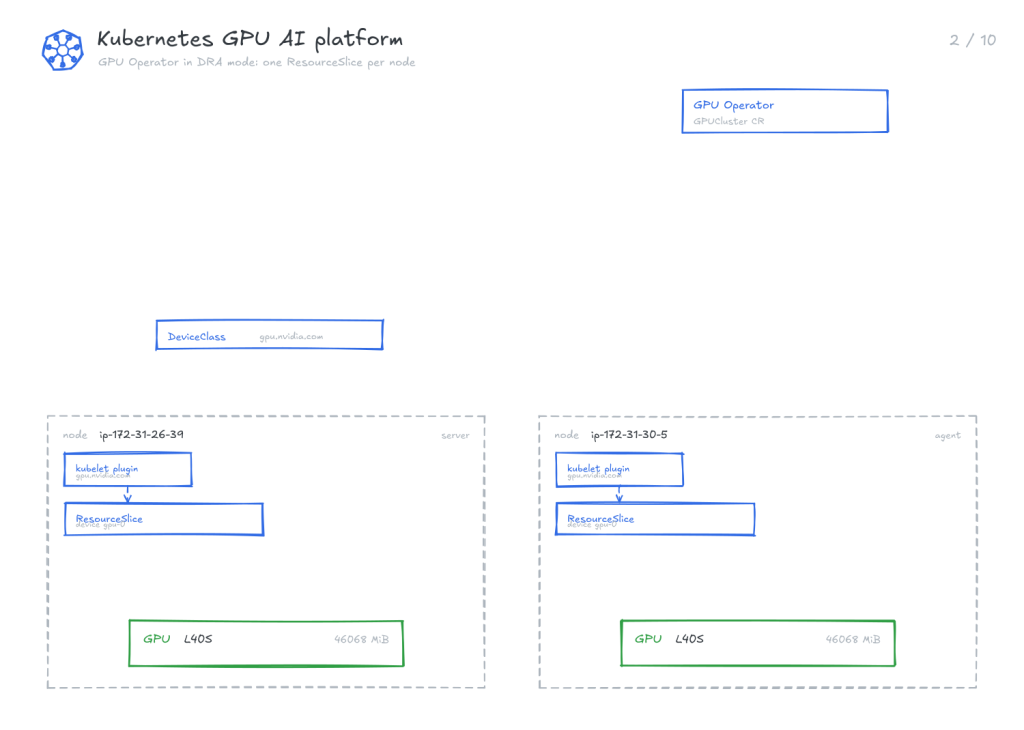
裝完之後每個節點上多一個 kubelet 的 DRA plugin,註冊的名字是 gpu.nvidia.com,叢集裡有一個同名的 DeviceClass,每個節點各一份 ResourceSlice,裡面一個 device。
HAMi 的切分是 HAMi-core 執行的,容器裡那顆 libvgpu.so 擋記憶體和算力。它走 DRA 的那一支是 k8s-dra-driver,DeviceClass 的名字是 hami-core-gpu.project-hami.io。
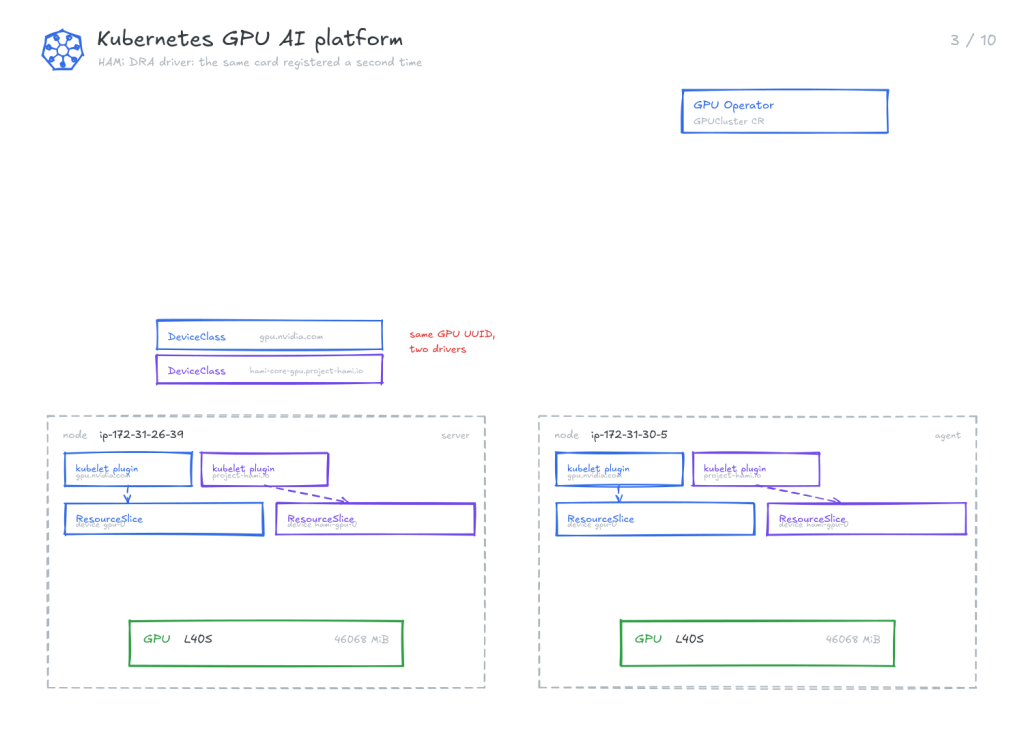
它要求叢集打開 DRAConsumableCapacity 這個 beta 的 feature gate,因為它的 device 不是整張配出去的。那份 ResourceSlice 裡的 device 帶 allowMultipleAllocations: true,另外有 cores 和 memory 兩個容量欄位,各自帶一份 requestPolicy,claim 可以只要其中一部分。
現在每個節點上有兩個 kubelet plugin、兩份 ResourceSlice,叢集裡有兩個 DeviceClass。兩份 slice 裡那張卡的 UUID 相同。
硬體指標這一層是 dcgm-exporter,以 DaemonSet 跑。它自己帶一份 adminAccess: true、allocationMode: All 的 claim,這樣它看得到節點上所有的卡,而不是占用其中一張。
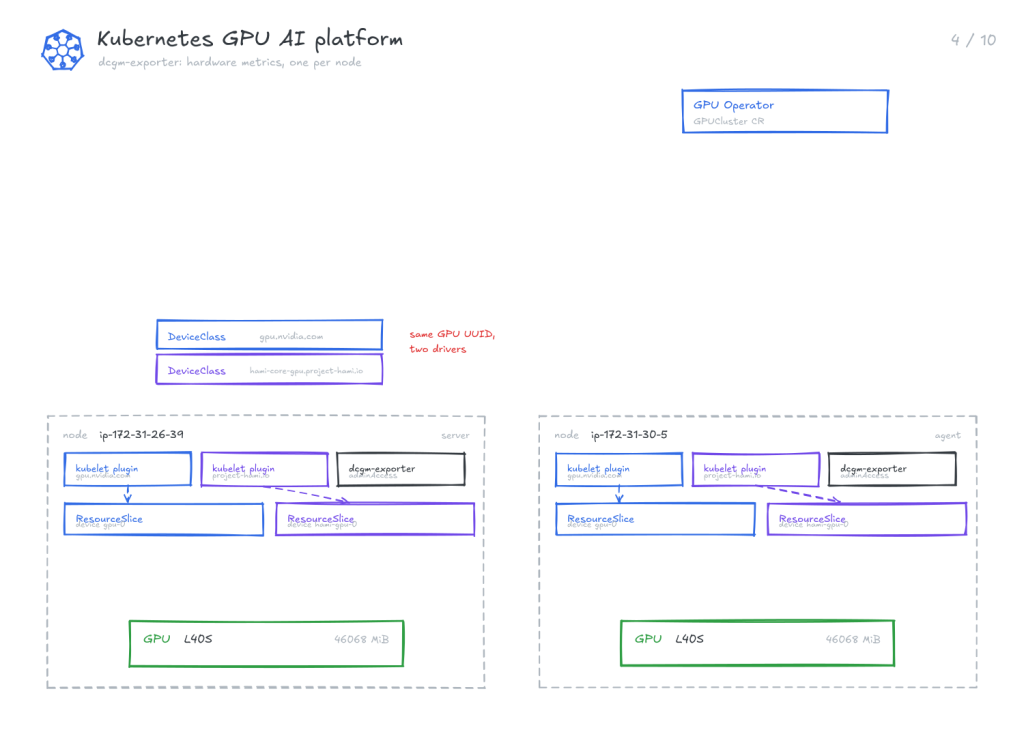
它要在指標上補 pod、namespace、container 這些標籤,得先認出哪一份 claim 是 GPU 的,而比對用的 DRAGPUDriverName 是編譯期寫死的 gpu.nvidia.com。比對得上的是 exporter 自己那份 claim。走 HAMi 那個 DeviceClass 配到卡的 Pod,指標上那組 pod、namespace 標籤不會指向它,而是指向 exporter 自己。數值是對的,歸屬是錯的。
Volcano 這一側要打開 DynamicResourceAllocation 這個 feature gate。scheduler 設定裡的 predicate.DynamicResourceAllocationEnable 在這個版本是預設開的,顯式寫上去比較保險。
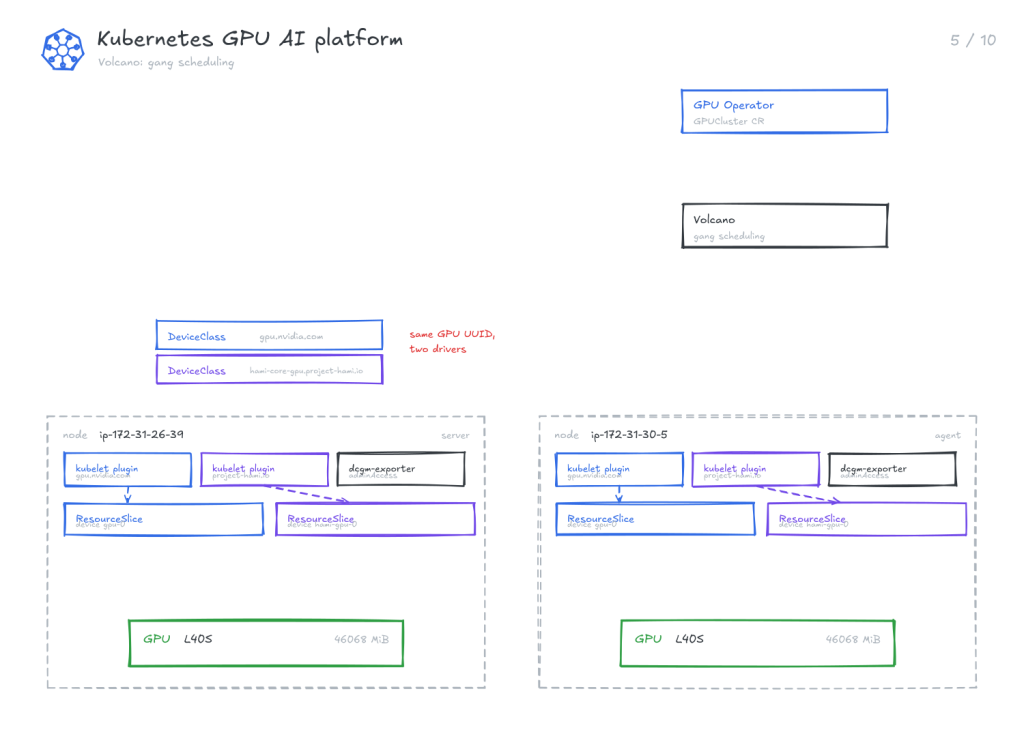
它在 DRA 上做的是 gang 那一段,決定一組 Pod 要不要一起配到資源。
配額那一段是 Kueue。整數資源的配額直接寫在 ClusterQueue 裡,而 DRA 的卡不是整數資源,節點上沒有對應的欄位可以數。Kueue 的 deviceClassMappings 處理這件事:自己取一個資源名字,對到一個 DeviceClass。
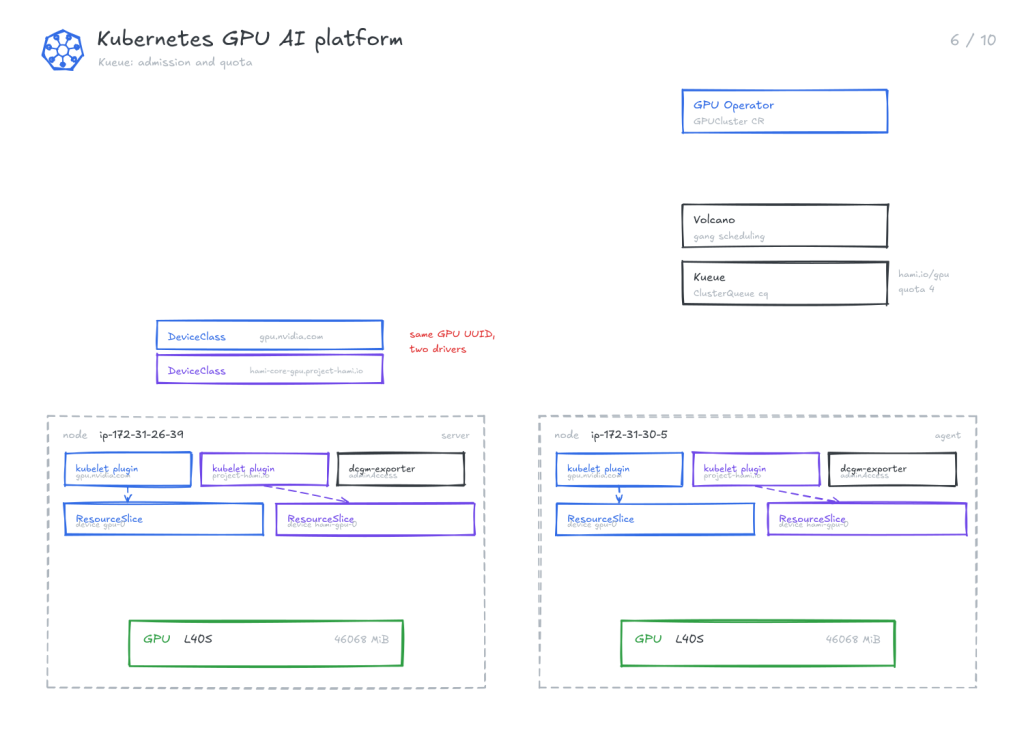
這個叢集裡的對應是 hami.io/gpu 對到 hami-core-gpu.project-hami.io。ClusterQueue 叫 cq,hami.io/gpu 的配額是 4,底下一個 LocalQueue 叫 lq。
LeaderWorkerSet 用 enableDisaggregatedSet=true 裝,把 DisaggregatedSet 那一組 CRD 一起帶進來。
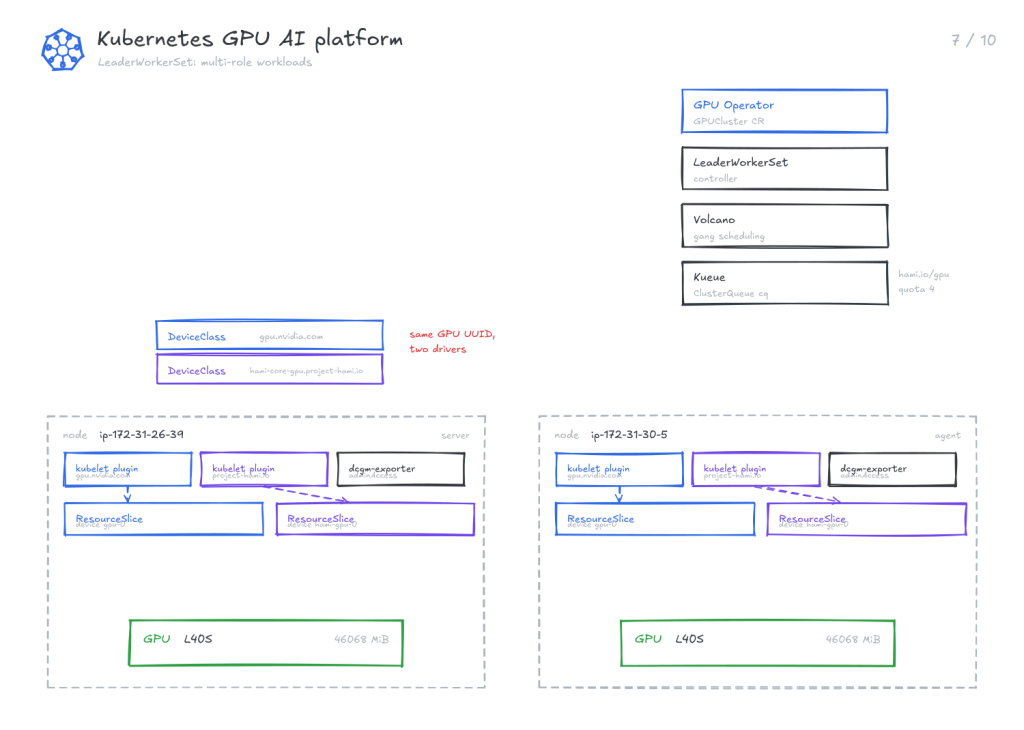
流量的入口是 Envoy Gateway 和 Envoy AI Gateway,另外要裝 Gateway API Inference Extension 的 CRD。
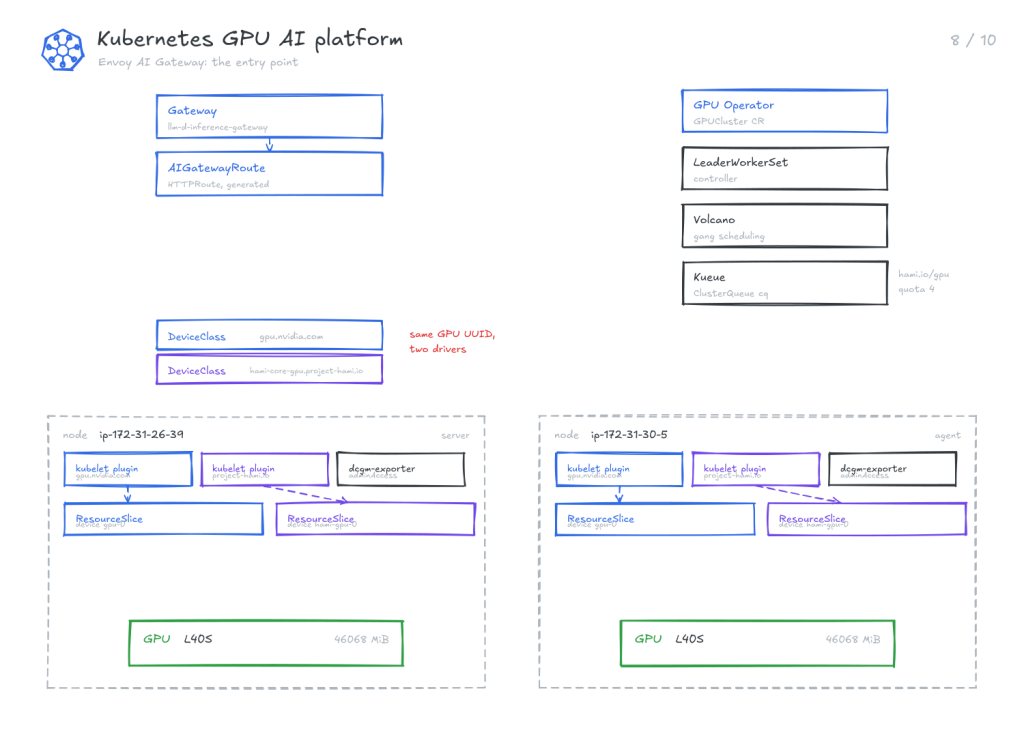
這一段有兩處要自己補。一處是權限,要另外加一個 ClusterRole,讓控制面讀得到 inferencepools 這個資源。另一處是 Service 的型別,Envoy Gateway 預設會給 Gateway 建一個 LoadBalancer 型的 Service,而這個叢集把 servicelb 關掉了,沒有元件會去配位址,所以用 EnvoyProxy 把它 patch 成 ClusterIP。
挑副本的那一層是 llm-d router 的 EPP,走 Standalone 的裝法,profile 是 optimized-baseline,ext_proc 的埠是 9002,failureMode 是 FailOpen。
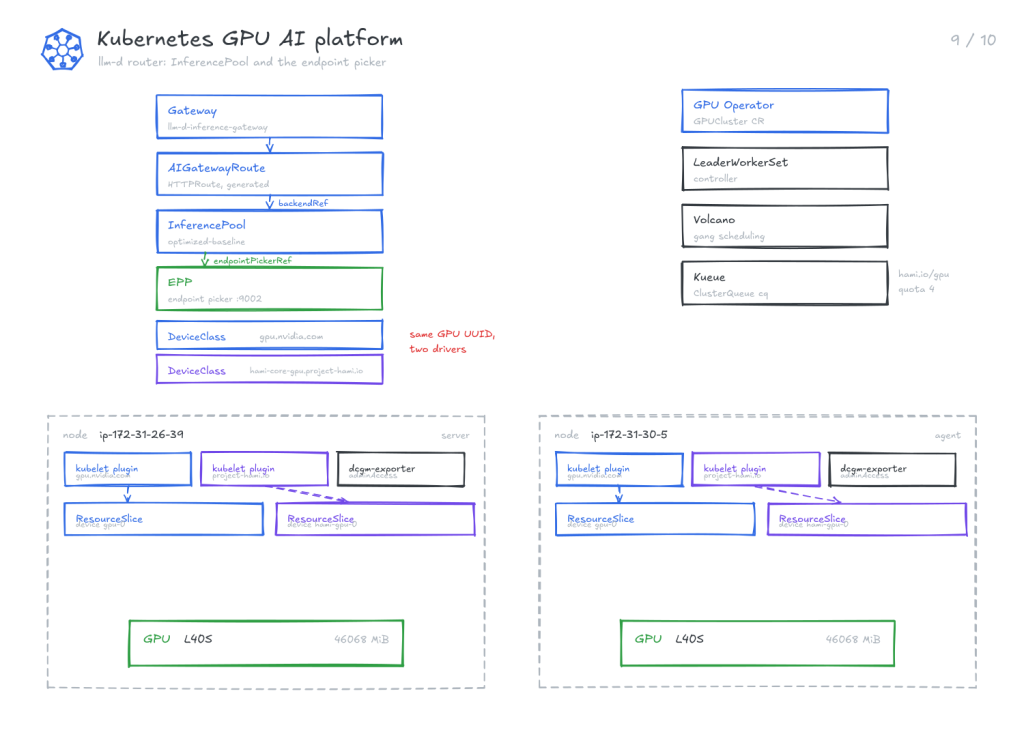
接線是兩段。InferencePool 的 endpointPickerRef 指到 EPP 的 Service,AIGatewayRoute 的 backendRefs 指到那個 InferencePool,而 AIGatewayRoute 自己會生出一份 HTTPRoute,掛在 Gateway 上。
最上面是兩個 vLLM 副本,模型是 Qwen2.5-7B-Instruct。
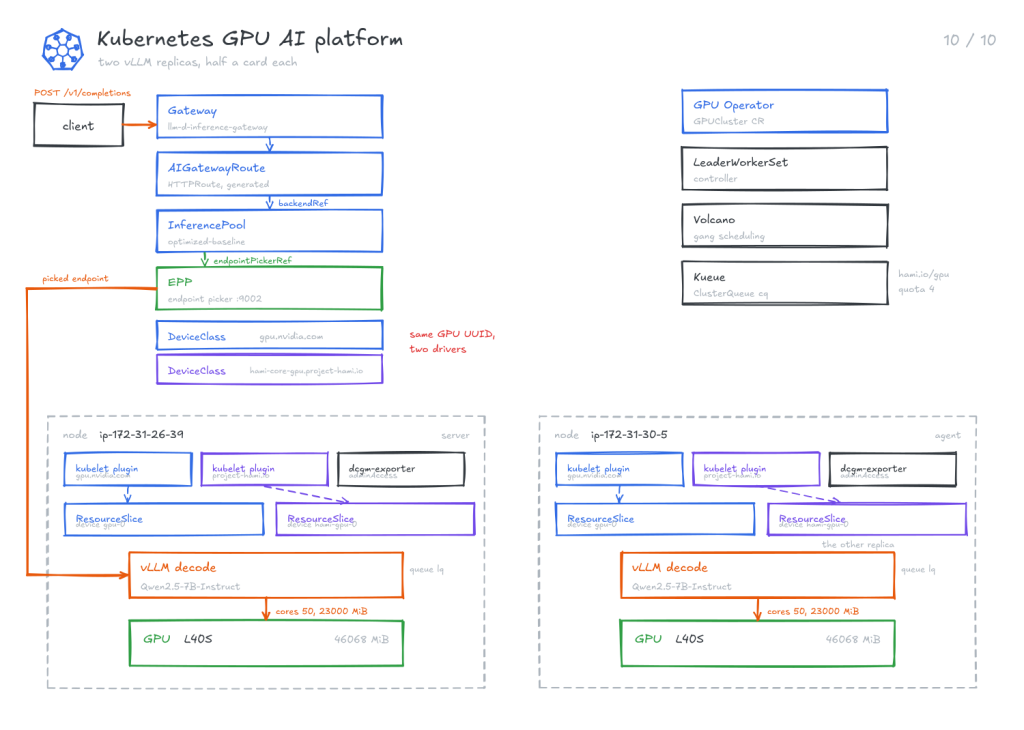
卡是從 HAMi 那個 DeviceClass 要的,claim 裡寫 cores: "50" 和 memory: 23000Mi。進到容器裡跑 nvidia-smi,看到的記憶體上限是 23000 MiB,不是整張卡的 46068 MiB。
Pod 上帶 kueue.x-k8s.io/queue-name: lq,先經過 Kueue 准入才排得出去。更新策略設成 Recreate,另外加一條 required 的 anti-affinity,把兩個副本分到兩個節點。
kustomize 這邊要補一個 namereference.yaml。namePrefix 會改掉 ResourceClaimTemplate 的名字,而 Pod 裡引用樣板名字的那個欄位不在 kustomize 預設的改名清單裡,不補就會引用到一個不存在的名字。
過去幾天一個一個講過的服務,今天接在同一個叢集上。卡走 DRA 配出去,排程和配額接在 DRA 的物件上,流量從 Envoy 進來交給 EPP 挑副本,最上面是兩個 vLLM。k3s 之上十個元件各管一段,一發請求從上到下穿過它們。
這套環境留著,下一篇在上面跑實驗。
Dynamic Resource Allocation - Kubernetes
DRA API Objects - Kubernetes
Observability of Dynamic Resources - Kubernetes
KEP-5075: DRA Consumable Capacity
DRA Driver for NVIDIA GPUs - GPU Operator 26.7
Project-HAMi/k8s-dra-driver
HAMi 文件 — Dynamic Resource Allocation
NVIDIA/dcgm-exporter
How to Enable Dynamic Resource Allocation (DRA) in Volcano Scheduler
Volcano v1.15.0 release
Volcano — Gang plugin
Kueue — Dynamic Resource Allocation
Kueue — Set Up Dynamic Resource Allocation
kubernetes-sigs/lws
DisaggregatedSet 總覽
System Architecture Overview, Envoy AI Gateway
AIGatewayRoute + InferencePool Guide, Envoy AI Gateway
InferencePool - Gateway API Inference Extension
EPP Configuration - llm-d
k3s Server Configuration Reference


 iThome鐵人賽
 看影片追技術