
今天是 Day 30,也是這個系列的最後一天。
前面 29 天,我一路從:
不知道 Claude Code 是什麼
	↓
學會在終端機使用
	↓
建立 Flask Web App
	↓
接 MySQL
	↓
完成 CRUD
	↓
加入狀態、分類、篩選
	↓
開始用 Git
    ↓
讓 Claude Code 做 Code Review
	↓
串接 Groq API
	↓
加入 Structured Outputs
    ↓
調整 Prompt
    ↓
把 AI 任務拆解正式接進 Web App
做到 Day 29,其實主要功能已經完成了。
所以最後一天,我不打算再塞新功能。
Day 30 的重點只有三件事:
完整 Review
   ↓
最後整理
   ↓
同步專案最終狀態
Day 30 一開始,我先讓 Claude Code 做一次唯讀 Review。
這次檢查的範圍包含:
app.py
ai_service.py
groq_api_test.py
config.py
db.py
models/
templates/
static/
requirements.txt
.env.example
.gitignore
schema.sql
另外也用:
Git
AST
grep
去找一些比較容易漏掉的問題。
例如:
有沒有未使用 import?
有沒有 debug 暫時程式?
有沒有過期註解?
有沒有沒用到的 CSS?
有沒有敏感資訊被 Git 追蹤?
有沒有 Day 29 整合完留下的暫時檔案?
這次 Review 的結果其實滿乾淨的。
Review 最後真正找到一個值得動的地方:
ai_service.py
裡面的:
except BadRequestError
和:
except APIStatusError
有一段幾乎一樣的處理。
原本大概是:
BadRequestError
→ 特別看 json_validate_failed
→ 其他 400 用通用訊息

APIStatusError
→ 其他 API status 用通用訊息
但:
BadRequestError
本身其實是:
APIStatusError
的子類別。
所以兩段可以合併。
Day 28 已經刪過一輪沒有引用的 CSS。
Day 30 再檢查一次後,目前:
35 個 class
都有被模板使用。
所以沒有再找到新的 dead CSS。
唯一有一個:
class="empty-state"
有出現在模板裡,但沒有對應 CSS。
這不是 Bug。
只是代表:
目前那段文字沒有專屬樣式
所以最後也沒有為了它硬加 UI。
最後實際程式改動是:
ai_service.py
大約:
+6 / -15 行
也就是:
刪掉重複,比新增更多。
這個結果其實很符合我對最後一天的期待。
不是再做新東西。
而是把已經完成的專案收乾淨。
目前完成的功能整理成:
任務新增
任務編輯
任務刪除
任務狀態更新
分類
截止日期
狀態篩選
分類篩選
Groq AI 任務拆解
AI 預覽
確認後批次寫入 MySQL
AI 與原本 Task CRUD 整合
Git
Code Review
CLAUDE.md 工作流程
最終 Review 與整理
AI 最後的完整流程則是:
使用者輸入大型目標
 ↓
Flask
 ↓
Groq
 ↓
openai/gpt-oss-20b
 ↓
Structured Outputs
 ↓
parse_tasks()
 ↓
網頁預覽
 ↓
使用者確認
 ↓
批次寫入 MySQL
 ↓
回首頁
一開始我以為這個系列主要是在學:
Claude Code 怎麼幫我寫程式
但做到最後,我覺得自己學到的東西比這個更重要。
前面剛開始時,很容易直接說:
幫我做這個功能
後來慢慢變成:
先進 Plan Mode
   ↓
先看會改哪些檔案
   ↓
確認範圍
   ↓
 再實作
這樣可以少掉很多:
AI 自己擴大需求
AI 順手改別的地方
AI 做得比我想像更多
這 30 天裡,我很多次看到 Claude Code 說:
已完成
但真的測才發現問題。
Day 29 就是一個很好的例子。
一開始:
tasks_json
只放了一個 list:
[
  ...
]
但:
parse_tasks()
期待的是:
{
  "tasks": [...]
}
所以確認 route 會一直:
400
如果沒有真的按:
產生預覽
   ↓
確認建立
這個 Bug 根本不會被發現。
所以:
AI 說完成,不等於功能真的完成。
Day 23 開始用 Git 之後,整個流程變得安心很多。
每次可以先看:
git status
git diff
git log
知道:
它到底改了什麼
有沒有多改
哪一版是正常的
對 AI coding 來說,Git 不只是版本控制。
更像:
安全網。
前面很容易看到:
這裡可以改
就覺得一定要改。
做到後來開始比較會分:
真正 Bug
已知限制
可能風險
純推論
未來優化
像:
title 超過 200 一定 500
這種沒有實測過的事情,就不能直接寫成已確認 Bug。
這種分辨能力,我覺得比單純會改程式更重要。
Day 25 第一次呼叫 Groq 成功時,看起來很像:
API 接好了
但做到 Day 29 才知道真正麻煩的是:
輸入驗證
錯誤處理
Structured Outputs
parse_tasks()
預覽
確認
hidden JSON
transaction
rollback
避免重新呼叫 AI
避免直接寫入錯誤資料
所以真正做成產品,不是:
API 回得出字
就結束了。
Day 26 用:
strict=true
一開始會覺得:
那格式應該一定正確
但 Day 27 還是實際遇到:
json_validate_failed
模型生成的 JSON 本身可能先出錯,服務端驗證直接拒絕。
所以更精確的理解是:
Structured Outputs 可以約束成功回傳的格式,但不能保證每一次生成請求都一定成功。
這也是為什麼 Day 29 Web App 還是要保留錯誤處理。
Day 27 調 Prompt 時,一開始很容易一直加:
不要這樣
不要那樣
一定要這樣
必須那樣
但規則越長,不一定越好。
最後留下比較重要的幾個:
不要亂補使用者沒提到的內容
資訊不足時保守處理
任務要具體
title 簡短
description 不重複 title
只回指定格式
反而比較清楚。
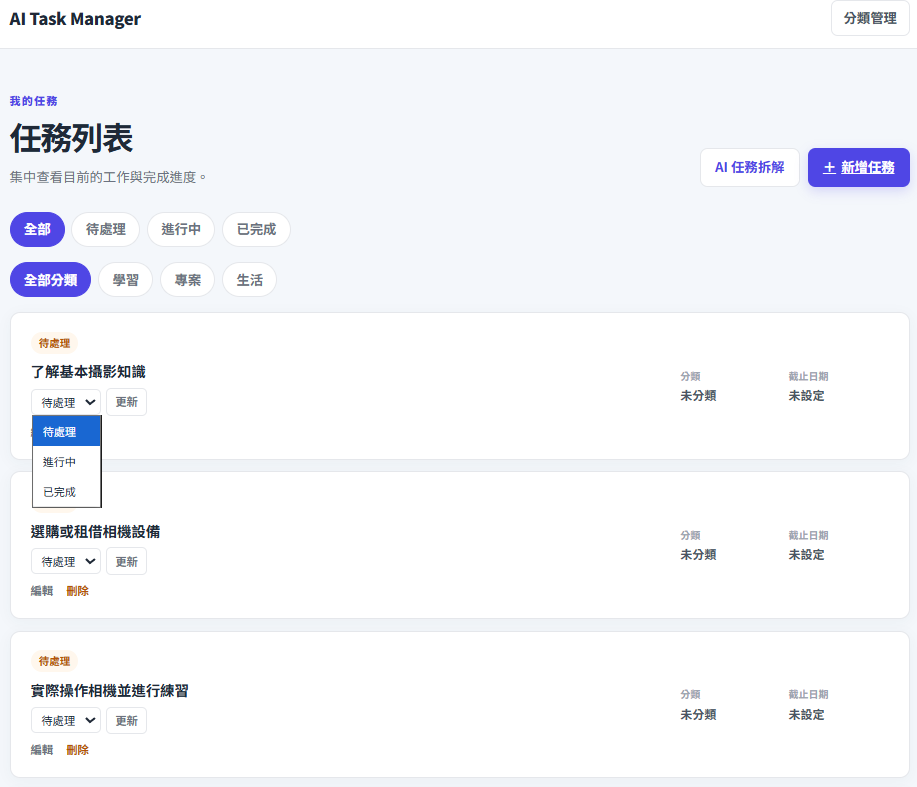
做到 Day 30,現在這個 Web App 已經可以:
新增任務
編輯任務
刪除任務
更新狀態
設定分類
設定截止日期
依狀態篩選
依分類篩選
也可以:
輸入大型目標
	↓
AI 拆成 5~8 個任務
	↓
先在網頁預覽
	↓
使用者確認
	↓
一次寫進 MySQL
	↓
回首頁繼續管理
這個專案還有一些已知限制。
例如:
分類 CRUD 還沒做
部分表單驗證還沒完全統一
AI 預覽頁重新整理可能再次呼叫 Groq
json_validate_failed 不自動 retry
前端只有基本防連點
沒有伺服器端防重複提交
AI 任務沒有 source 欄位
但這些不代表:
專案沒完成
而是:
已經知道目前邊界在哪裡。
這也是一個專案「完成」很重要的一部分。
從 Day 1 到 Day 30,我最後得到的不只是:
一個 AI Task Manager
而是一套比較完整的 AI 協作開發流程:
需求
 ↓
Plan
 ↓
確認修改範圍
 ↓
實作
 ↓
git diff
 ↓
測試
 ↓
修 Bug
 ↓
Code Review
 ↓
文件同步
 ↓
commit
Claude Code 可以幫我:
讀專案
規劃
修改
找問題
整理程式
但最後還是要自己決定:
這是不是我要的?
這算不算 Bug?
這要不要現在修?
這次改動有沒有超出範圍?
一開始我比較常問:
Claude Code 可以幫我做什麼?
做到最後,我比較會問:
這次應該讓 Claude Code 做什麼?
哪些東西不應該讓它動?
我要怎麼證明它真的做對?
這大概就是這 30 天最大的差別。
Day 30 完成。
30 天專案正式結束。


 iThome鐵人賽
 看影片追技術