
第十二天,我們要從基礎繪圖進階到統計視覺化利器——Seaborn。昨天使用的 Matplotlib 適合精細調整圖表細節,而 Seaborn 是建立在 Matplotlib 之上的高階封裝套件,專門用來探索變數之間的關聯性與統計分佈,只要幾行程式碼就能產出兼具美感與資訊量的圖表。今天我們建立純 Python 腳本 day12_seaborn_basics.py,掌握帶趨勢線的散佈圖與探索多變數關聯的相關係數熱力圖。
第一部分
新建 day12_seaborn_basics.py。首先設定繁體中文字型與 Seaborn 風格,並模擬一組廣告投放預算與營業額的數據,使用 sns.regplot() 繪製帶有回歸擬合線的散佈圖,直觀觀察兩者之間的線性趨勢: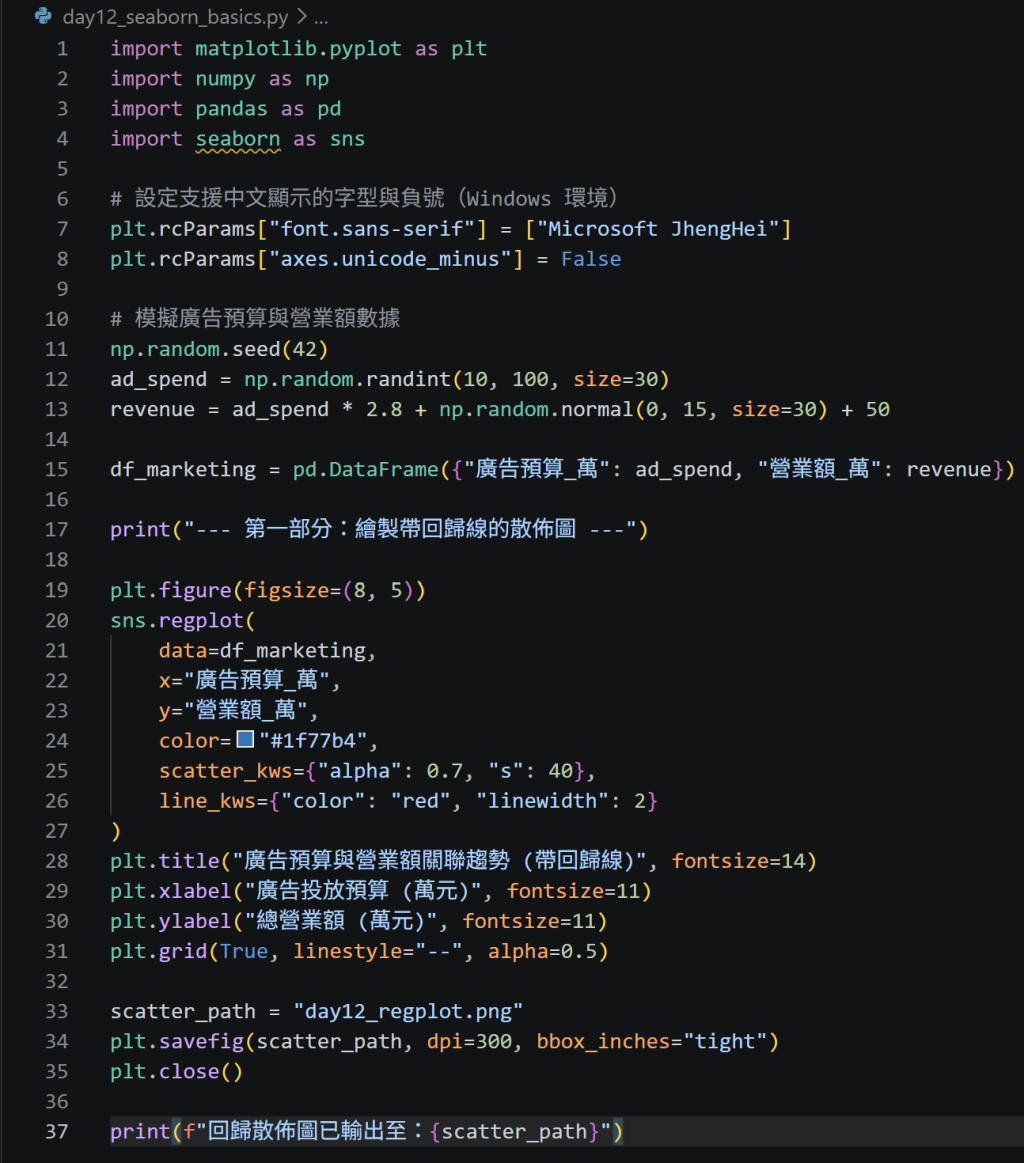
第二部分
在探索性資料分析(EDA)中,我們常需要一次檢驗多個數值變數之間的相互關聯。我們先透過 Pandas 的 .corr() 計算皮爾森相關係數矩陣(值介於 -1 到 1 之間),再使用 Seaborn 的 heatmap() 繪製熱力圖,搭配顏色深淺快速找出強相關特徵: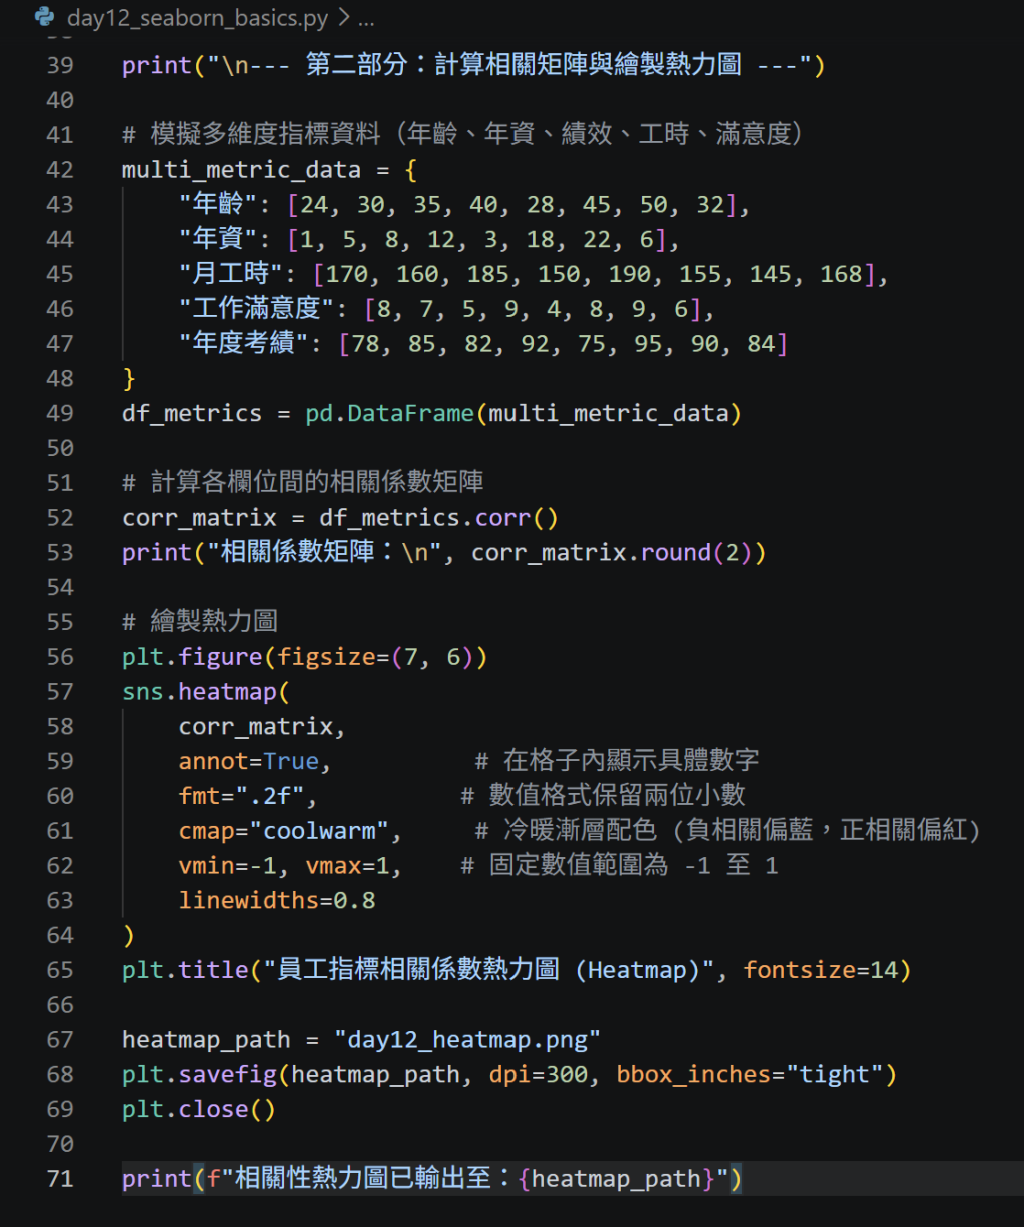
第三部分
最後示範 Seaborn 專為分類變數比較設計的「箱形圖(Boxplot)」,用來檢視不同組別的數值中位數、四分位距以及是否有離群值(Outliers):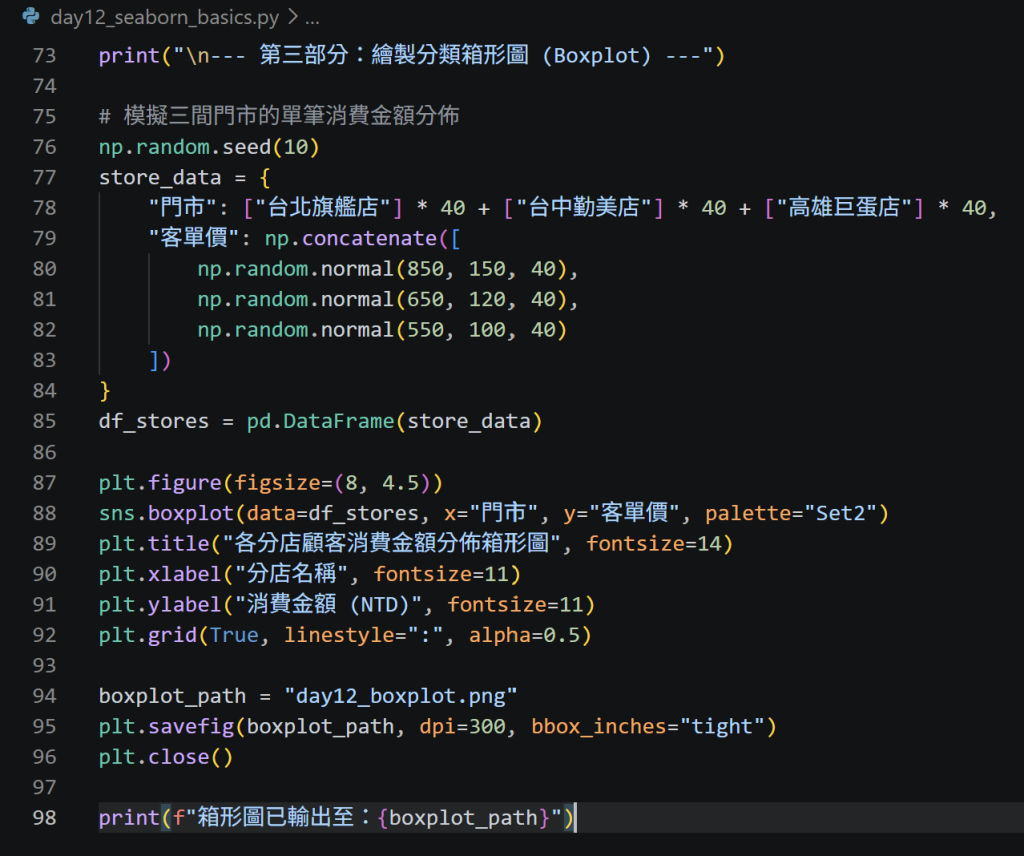
第四部分
在終端機輸入 python day12_seaborn_basics.py 執行驗證,確認三張統計圖表均順利產生且數值矩陣正確印出。記得按 Ctrl + S 儲存後推送到遠端儲存庫: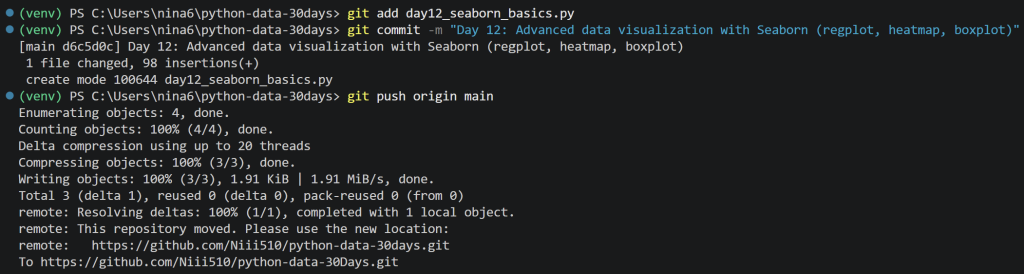
今日心得/遇到的問題
今天認識了 Seaborn 在探索性數據分析中的威力。特別是 sns.heatmap() 搭配 df.corr(),是拿到多欄位資料集時快速找出哪些變數之間存在高度關聯的必備起手法;而 boxplot 則能一眼看出各組別的資料離散程度與極端值。在寫純 .py 腳本時,同樣要記得每次存完檔加上 plt.close(),確保記憶體被完整釋放。

 niii

 iThome鐵人賽
 看影片追技術