
第十四天,我們正式踏入機器學習與進階數據建模的敲門磚——特徵工程(Feature Engineering)!乾淨的資料並不等於可以直接拿來給演算法計算的資料。例如:「年齡(20~60)」與「年收入(30萬~200萬)」在數值尺度上差距巨大,容易導致演算法偏向數值較大的特徵;而像「性別」或「城市」這類文字類別特徵,電腦根本無法直接進行四則運算。今天我們建立純 Python 腳本 day14_feature_engineering.py,掌握數值標準化(Standardization)、最小最大縮放(Min-Max Scaling)以及獨熱編碼(One-Hot Encoding)。
第一部分
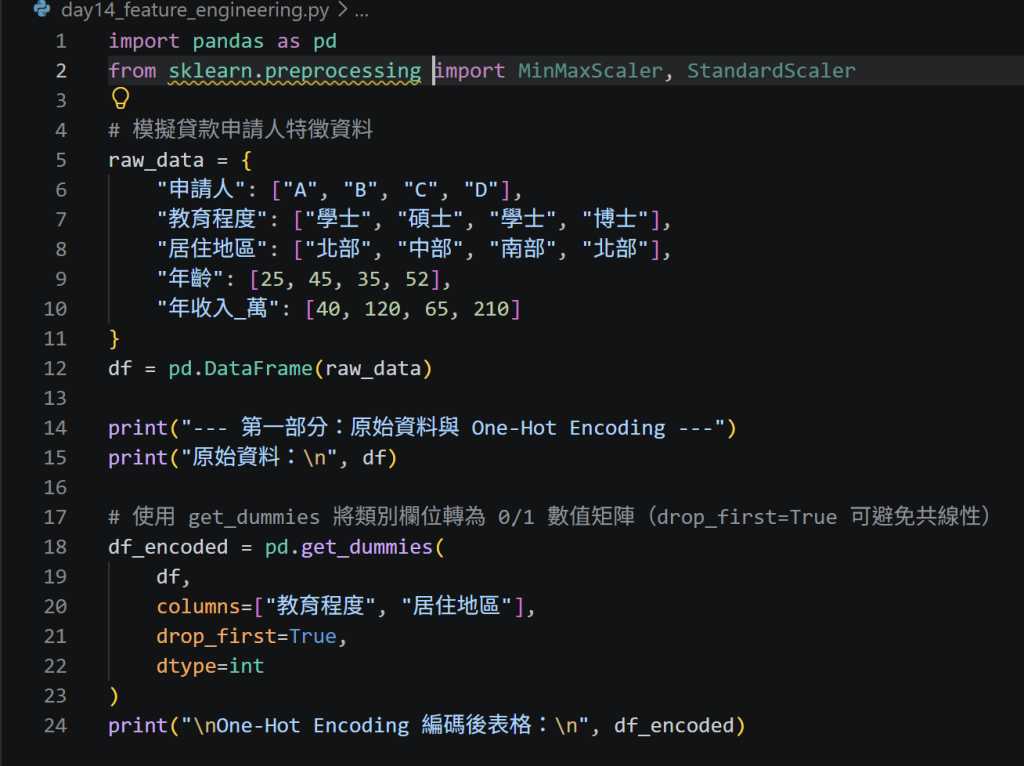
新建 day14_feature_engineering.py。首先建立包含數值與文字類別的原始資料集,並使用 Pandas 內建的 pd.get_dummies() 快速進行獨熱編碼(One-Hot Encoding),將類別變數轉化為機器看得懂的 0 與 1:
第二部分
接著處理數值特徵的尺度縮放。第一種常用方法是 Min-Max Scaling(最小最大值縮放),它會將數值線性壓縮至 [0, 1] 區間內,特別適合用於沒有極端離群值、且邊界明確的特徵: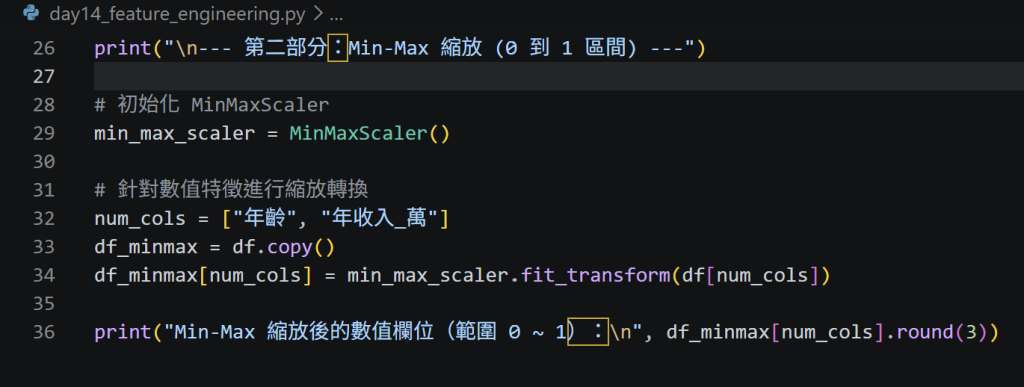
第三部分
第二種也是統計與機器學習最標準的縮放方法是 StandardScaler(Z-Score 標準化)。它將數據轉換為「平均數為 0、標準差為 1」的標準常態分佈,能夠大幅降低不同量綱對模型權重更新時的干擾: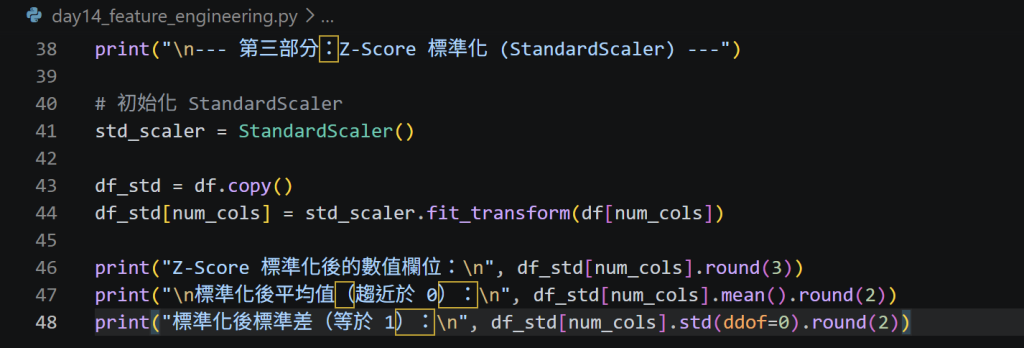
第四部分
在終端機輸入 python day14_feature_engineering.py 執行驗證,確認編碼後的 0/1 欄位生成正確,且數值縮放後的平均數與標準差符合數學定義。按 Ctrl + S 儲存後推送到遠端儲存庫: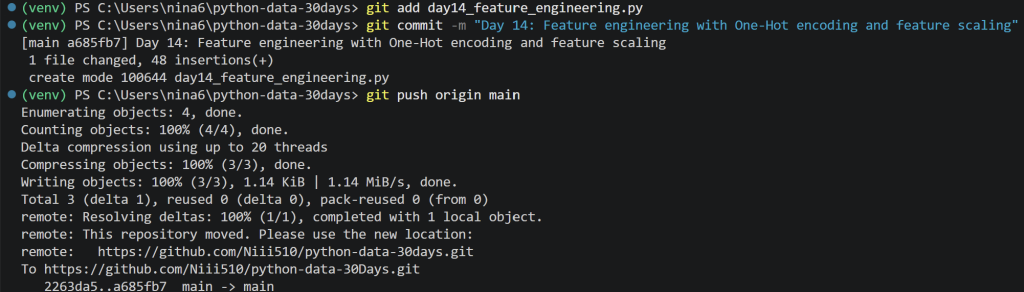
今日心得/遇到的問題
今天學到了資料分析過渡到機器學習最關鍵的轉換步驟。以往常以為把遺漏值填好就能直接拿去分析,但忽略了不同特徵量綱(例如年齡只有幾十,年收入卻有幾百萬)會對以距離或梯度下降為主的演算法產生嚴重的偏差。另外,使用 pd.get_dummies 時加上 drop_first=True 是一個非常重要的實務習慣,它能剔除多餘的基準欄位,有效避免統計學上的虛擬變數陷阱(Dummy Variable Trap)。

 niii

 iThome鐵人賽
 看影片追技術