
第十六天,我們正式踏入機器學習(Machine Learning)的領域!在昨天的半程專案中,我們完成了資料清理與特徵工程;今天我們要學習如何讓電腦「從數據中學習規律」,並對未知資料做出預測。在監督式學習中,最基礎且最具解釋性的模型就是線性回歸。今天我們建立純 Python 腳本 day16_linear_regression.py,掌握標準的訓練集與測試集切割、模型擬合訓練以及預測成效評估。
第一部分
新建 day16_linear_regression.py。首先模擬一組「工作年資」與「月薪」的連續型數據,並使用 train_test_split 將資料切分為 80% 的訓練集與 20% 的測試集,確保模型不會因為死記硬背所有資料而產生過度擬合: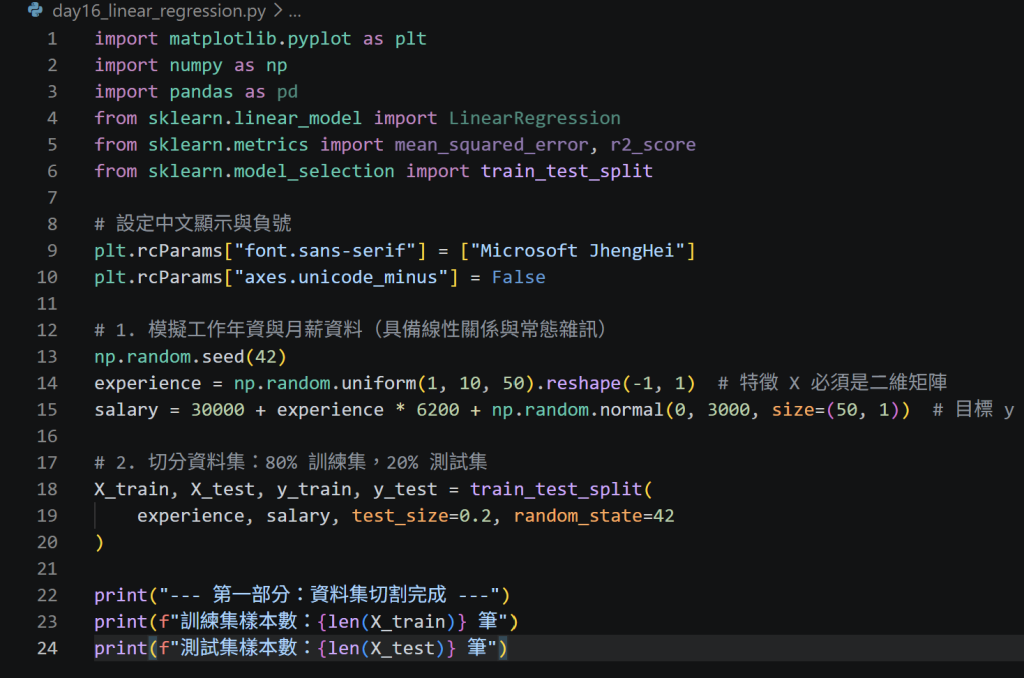
第二部分
接著初始化 Scikit-Learn 的 LinearRegression 模型,並調用 .fit() 在訓練集上進行模型擬合。訓練完成後,我們印出模型學到的迴歸參數:斜率(Weight / Coefficient)與截距(Bias / Intercept):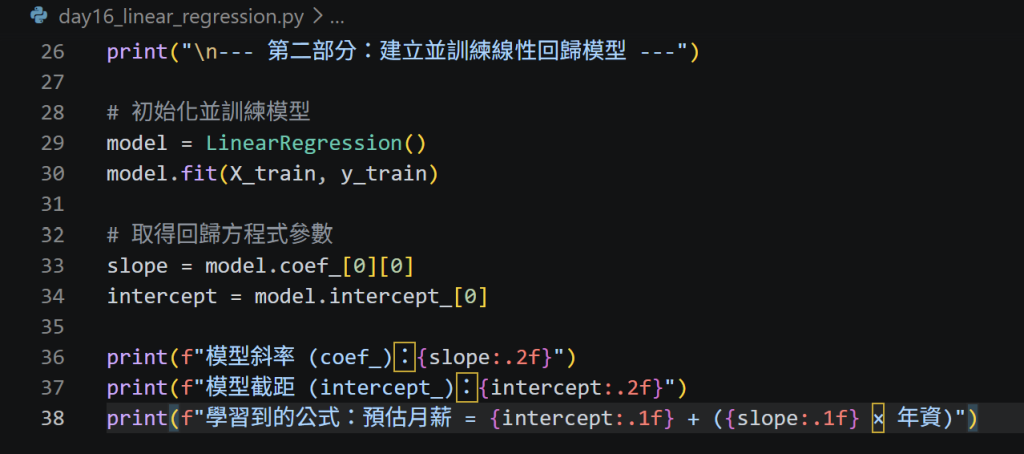
第三部分
模型訓練完成後,我們必須拿它從未看過的測試集 X_test 來進行預測,並使用兩大核心評估指標來驗證模型準確度:
均方誤差:評估預測值與真實值之間的平均平方誤差,數值越小越好。
判定係數:衡量模型解釋資料變異的能力,越接近 1 代表擬合效果越佳。
最後將回歸擬合線與測試集樣本繪製成圖檔: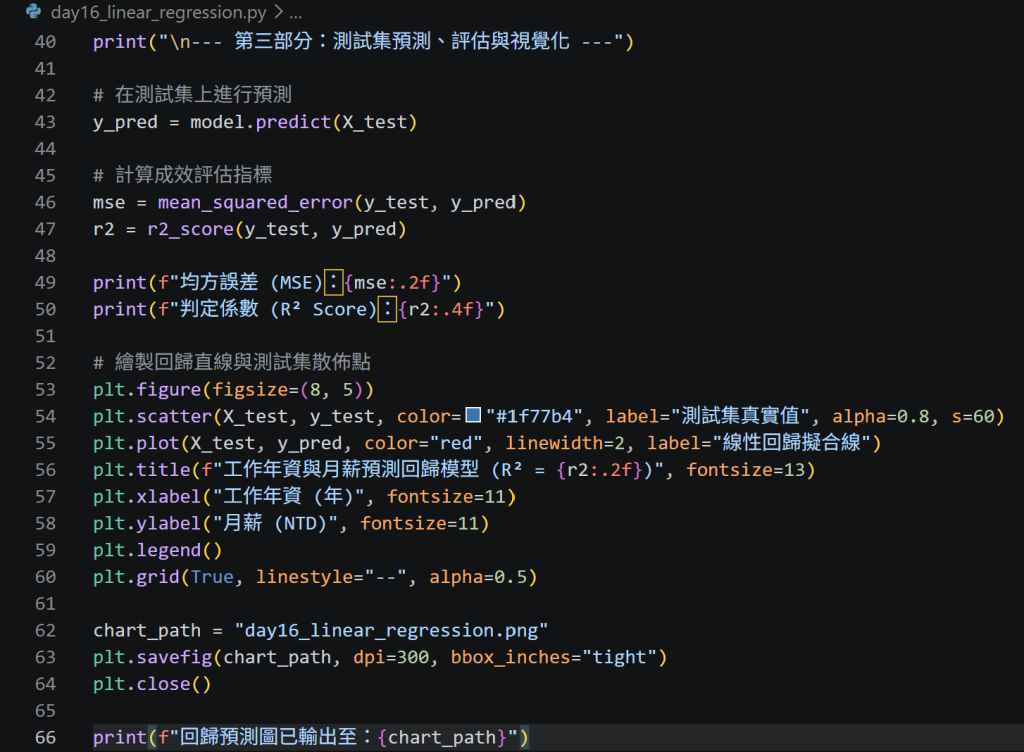
第四部分
在終端機輸入 python day16_linear_regression.py 執行驗證,確認模型學習到的斜率、截距以及評估指標 MSE / R² 順利印出,且圖片 day16_linear_regression.png 生成完畢。確認存檔(Ctrl + S)後推送到 GitHub 進行版本控制: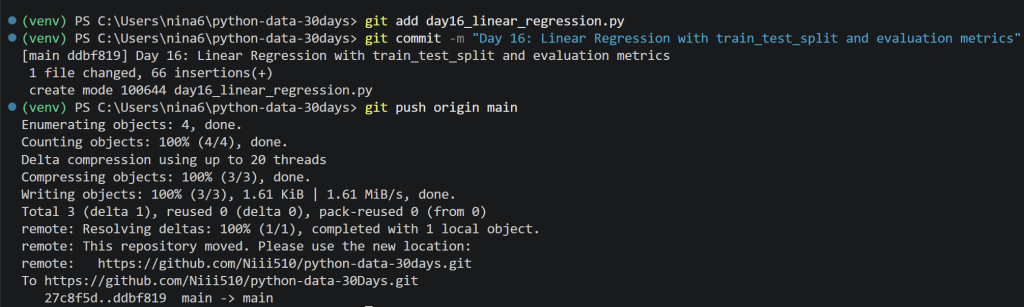
今日心得/遇到的問題
今天正式跨進了機器學習的大門!最重要的一個觀念是資料集切割(train_test_split):絕對不能把所有資料都拿去給模型訓練再用原資料評估,那樣就像是「把考試題目直接給學生背答案」,無法測出模型面對未知新資料的泛化能力(Generalization)。此外,特徵 X 丟進 Scikit-Learn 時必須是二維結構(DataFrame 或 reshape 成 (N, 1)),也是剛從 Pandas 轉到機器學習時需要特別注意的語法細節。

 niii

 iThome鐵人賽
 看影片追技術