
第十七天,我們要從「數值預測(回歸)」轉向機器學習另一大主流應用——分類問題(Classification)。昨天的線性回歸用來預測連續數值(如薪水、房價),但現實中有更多問題屬於二元判斷,例如:這封信是正常信還是垃圾郵件?客戶會續約還是流失?這名受檢者是有病還是健康?處理這類二元分類最經典且穩健的演算法就是邏輯斯迴歸(Logistic Regression)。今天我們建立純 Python 腳本 day17_logistic_regression.py,掌握機率轉換、分類門檻判斷,以及使用混淆矩陣(Confusion Matrix)全面評估模型表現。
第一部分
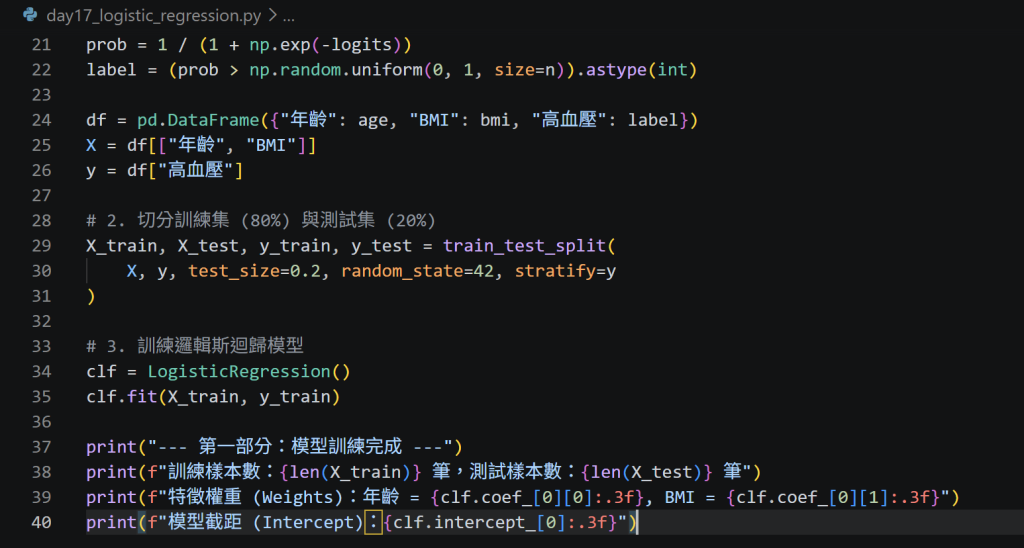
新建 day17_logistic_regression.py。首先模擬一組受檢者的「年齡」、「體質指數(BMI)」與「是否罹患高血壓(0 為否,1 為是)」的資料集,使用 train_test_split 切分訓練集與測試集,並建立且擬合邏輯斯迴歸模型: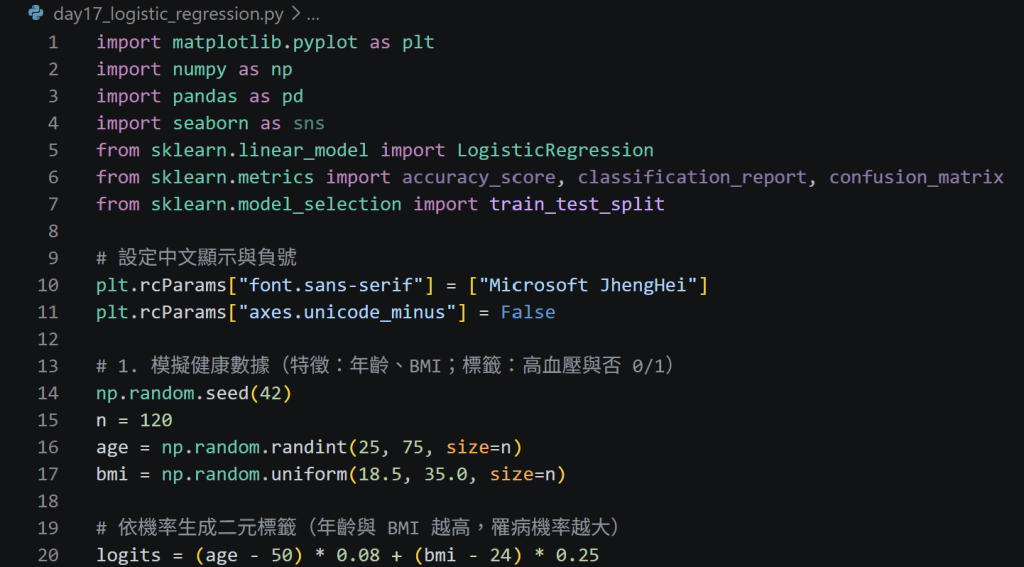
第二部分
邏輯斯迴歸本質是透過 Sigmoid 函數輸出「0 到 1 之間的機率值」。我們可以使用 predict_proba() 檢視樣本屬於正樣本(罹病)的具體信心程度,並使用預設門檻 0.5 轉換為預測類別(0 或 1):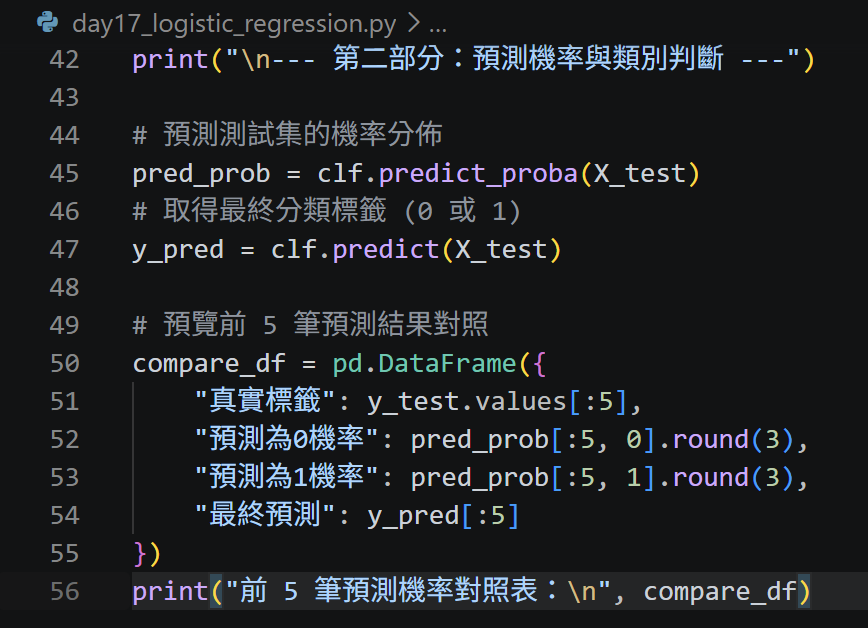
第三部分
評估分類模型不能單看準確率(Accuracy),特別是在類別不平衡或醫療診斷情境下,漏診(False Negative)與誤診(False Positive)的代價截然不同。我們計算混淆矩陣與綜合指標報告(Precision、Recall、F1-Score),並利用 Seaborn 繪製混淆矩陣熱力圖: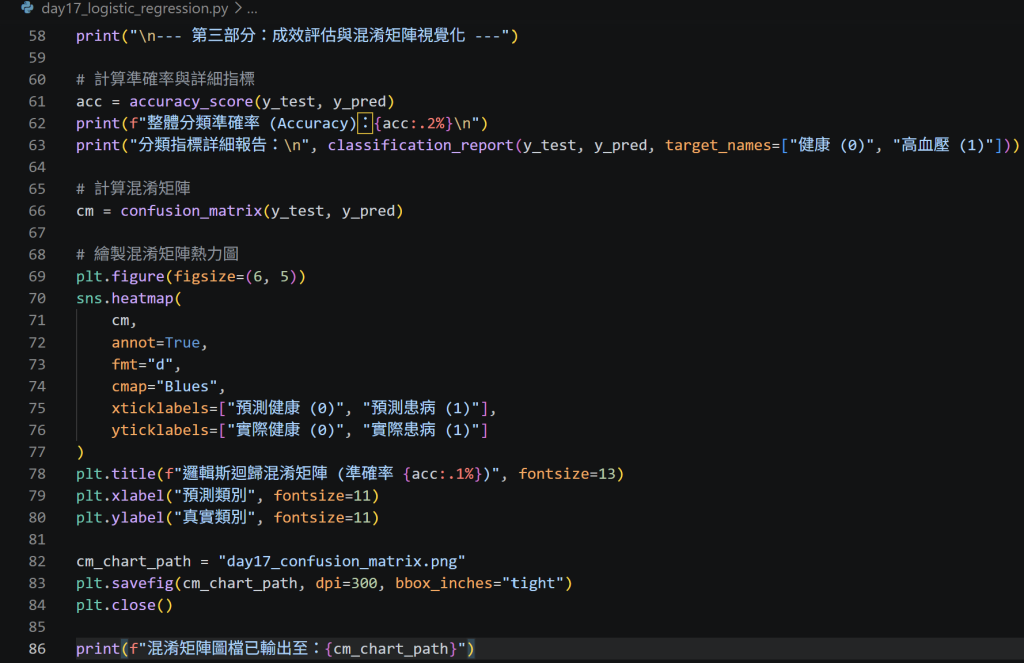
第四部分
在終端機輸入 python day17_logistic_regression.py 執行驗證,確認權重、前 5 筆機率值、分類評估報告完整印出,且圖片 day17_confusion_matrix.png 生成完畢。確認存檔(Ctrl + S)後推送到遠端儲存庫: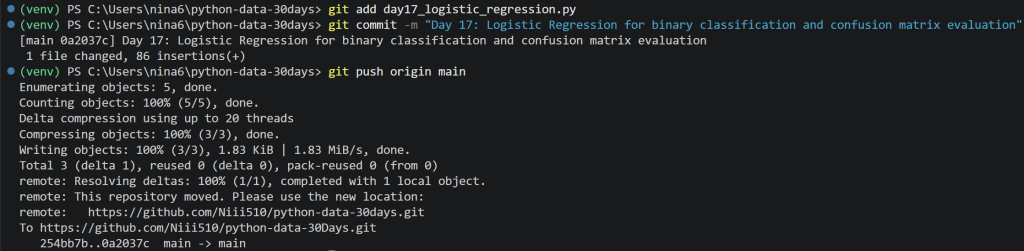
今日心得/遇到的問題
今天跨入了分類問題的世界。雖然名字帶有「迴歸(Regression)」,但邏輯斯迴歸本質是用於預測離散的類別標籤。今天特別學會了混淆矩陣(Confusion Matrix)的判讀:真正例(TP)、偽正例(FP)、真反例(TN)與偽反例(FN)。在醫療或風險控制場景中,召回率(Recall,真實有病的人抓出多少)往往比整體的單純準確率更具參考價值。另外在切分資料時加上 stratify=y,可以確保訓練集與測試集保有相同比例的正負樣本,這是一個非常實用的分層抽樣技巧。

 niii

 iThome鐵人賽
 看影片追技術