
工作中的 Spark job 一旦跑得比平常久,很容易立刻想到 Executor memory、Executor 數量或某個 Spark 設定。這些猜測缺少證據時,往往只會讓排查繞遠路。經過前面的 local mode、Standalone cluster、YARN 與 Kubernetes,我已經知道 Spark job 會經過 Driver、Executors、tasks 與平台資源;這一集要把它們放進一個實用的排查順序。
我先跑一個包含 Parquet scan 與一次 shuffle 的小型 application,刻意不製造 skew、OOM、spill 或小檔案。它提供一份正常基準,讓我練習從 Spark UI 收集第一輪證據:慢的是整個 Job、其中一個 Stage、少數 tasks,還是 Executors 的資源狀態?
Ep15–Ep18:認識 Driver、Executor、task、shuffle、cache 與 recovery
        ↓
Ep19–Ep21:了解 YARN/Kubernetes 如何提供 application 的執行環境
        ↓
Ep22:先建立 Spark UI 的診斷順序
Jobs → Stages → Tasks → Executors
        ↓
Ep23–Ep26:分別驗證 skew、join、小檔案與 memory 症狀
這是實務診斷區段的起點。這篇不會提供一張「看到慢 job 就調這些設定」的清單;每個設定背後都有不同的資料、query 與資源條件。第一步是把症狀轉成可驗證的問題。
我會依照下列順序閱讀 Spark UI:
Job 花很久
  ↓
Jobs:是哪一個 Job?它由幾個 Stages 組成?
  ↓
Stages:時間、Input、Shuffle 成本集中在哪個 Stage?
  ↓
Tasks:所有 task 都慢,還是少數 task 明顯落後?
  ↓
Executors:工作量、GC、spill 或失敗是否集中在特定 Executor?
  ↓
決定下一個需要驗證的原因
每一頁縮小一次範圍。Jobs 告訴我該追哪次 action;Stages 將 Job 切回 scan、shuffle 等資料流步驟;Tasks 顯示平行工作是否平均;Executors 則補上運算資源與 process 層的訊號。
Spark UI 的用途不是直接替我下結論;它讓「job 很慢」變成下一個可以驗證的問題。
實驗沿用兩個 2-core Workers 的 Standalone cluster。先建立 800,000 rows 的共享 Parquet input,application 讀取後 filter,再依 category 重分區並聚合:
events = spark.read.parquet(INPUT_PATH)
summary = (
    events.filter(F.col("value") >= 10)
    .repartition(8, "category")
    .groupBy("category")
    .agg(
        F.count("*").alias("row_count"),
        F.sum("value").alias("value_sum"),
    )
)

result = summary.collect()
repartition(8, "category") 是這段 pipeline 唯一刻意指定的 shuffle 邊界。為了讓 UI 的數字穩定對照程式,我將 AQE 關閉;這只服務實驗觀察,並不構成一般 application 的設定建議。
action 完成後,程式會刻意等待 420 秒,讓 completed Job 仍留在 Driver UI。我需要先分開兩個時間:application 的 Total Uptime 包含這段等待;每個 Job duration 才是那次 action 實際佔用的時間。
這次 Driver UI 的 Jobs 頁有兩個 Completed Jobs。我要追的是 collect at ... diagnosis_observer.py:32:它有兩個 Stages、12 個 tasks,duration 是 4 秒。另一個 parquet at <unknown> Job 與讀取 input 的準備工作有關,只有一個 Stage、一個 task。
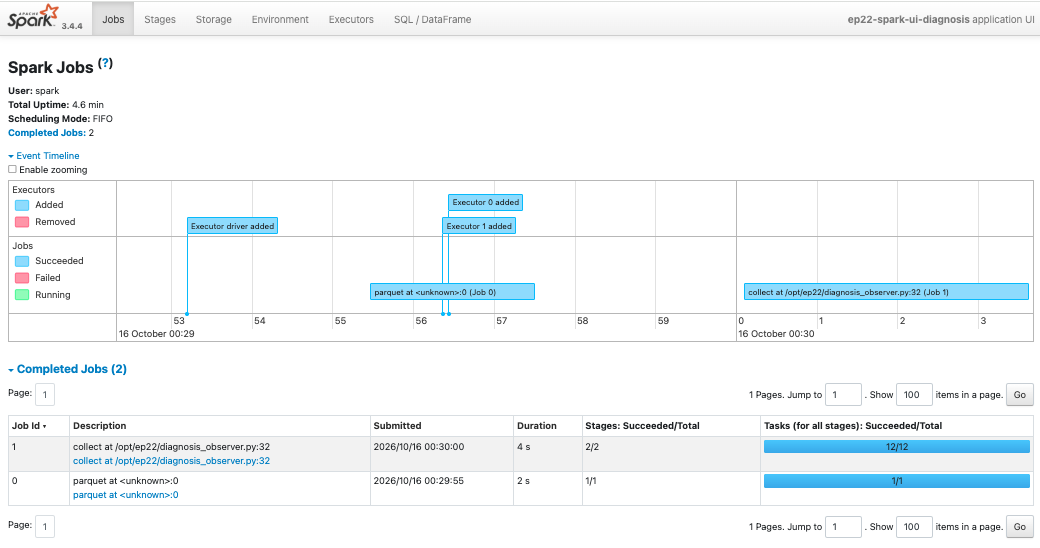
頁面上方的 Total Uptime 為 4.6 分鐘,和 4 秒的 collect duration 差距很大。這個差距主要來自我為截圖保留的 420 秒等待,沒有代表 Spark 計算花了四分多鐘。真實排查也需要先確認:我看到的是 application 生命週期、排隊時間,還是特定 action 的 execution time?
Jobs 頁提供入口;接下來點進 Job 1,才能知道這四秒落在什麼工作上。
Spark UI 同時顯示幾種時間,先分清楚層級才能避免把不同範圍的數字直接相減後下結論:
| 時間 | 它涵蓋的範圍 | 差距出現時,先問什麼? |
|---|---|---|
| Total Uptime | Driver/Spark application 從啟動到目前或結束的 wall-clock 時間。 | Job 以外的時間落在第一個 Job 前、Jobs 之間,還是最後一個 Job 後? |
| Job Duration | 一次 action 對應的 Job 從提交到完成的 wall-clock 時間。 | 這個 Job 的時間主要落在什麼 Stages?tasks 是否真的開始執行? |
| Stage Duration | Job 中一個 Stage 的執行期間。 | Input、shuffle、task duration 或 task 分布是否指向特定資料處理步驟? |
當 Total Uptime 明顯大於所有 Job Duration 的加總,差距可能來自 Driver 初始化、action 前後的 application code、Jobs 之間的空檔或 cleanup。第一個 Job 開始前等待 Executors 註冊也可能在其中;要確認資源等待,需要再對照 Executors 出現時間與 Standalone/YARN/Kubernetes 的資源狀態。
當單一 Job Duration 明顯大於 Stage Duration 的加總,先查看 task timeline、Executor 註冊時間與 Driver logs。可能的範圍包括 Driver 建立與提交 Stages、等待 task slot、Executor 配置、stage 交界的排程與結果處理。很小的差距也常來自 UI 的秒數四捨五入。若 application 同時執行多個 Jobs,Job Duration 相加還可能超過 Total Uptime,因為它們的 wall-clock 時間會重疊。
Job details 的 DAG 將這次 collect() 切成兩個 Stages:Stage 1 從 Parquet scan 開始,最後經過 Exchange 寫出 shuffle;Stage 2 讀回 shuffle 資料,完成下游聚合。
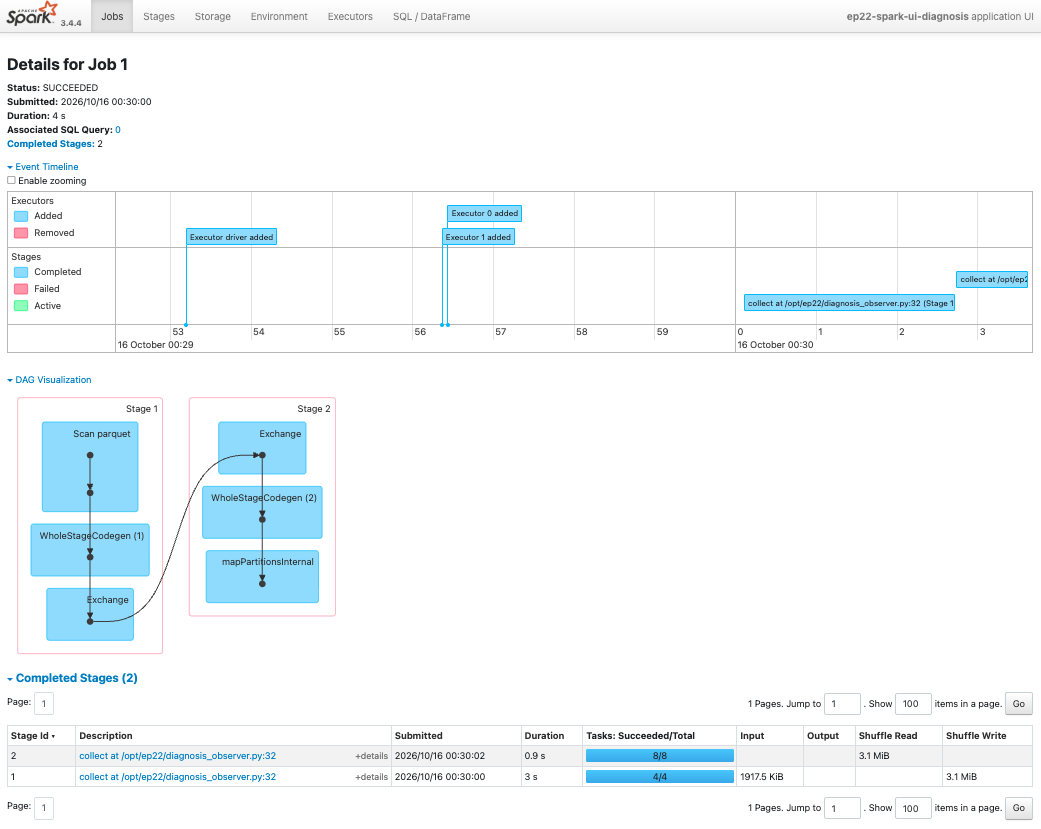
同一張畫面的 Completed Stages 表提供第一輪數字:
| Stage | tasks | 要先看的訊號 | 本次觀察 |
|---|---|---|---|
| Stage 1 | 4 | Input、Shuffle Write | Input 1917.5 KiB;Shuffle Write 3.1 MiB。 |
| Stage 2 | 8 | Shuffle Read | Shuffle Read 3.1 MiB。 |
Stage 1 的 Input 證明資料從 Parquet files 讀進來;Shuffle Write 表示上游 tasks 已將依 category 重分區後的 intermediate data 寫出。Stage 2 的 Shuffle Read 與前一個 Stage 的 Shuffle Write 對得上,表示下游 tasks 正在取得這批 intermediate data。
這一步回答的是「資料的主要移動發生在哪裡」。若某個慢 Job 的 shuffle 數字很大,我會回頭找對應的 repartition、groupBy、join 或其他 wide transformation;若 Input 特別大,則要回到 scan plan、file layout 與 filter 條件。數字本身仍不足以決定要改哪個設定。
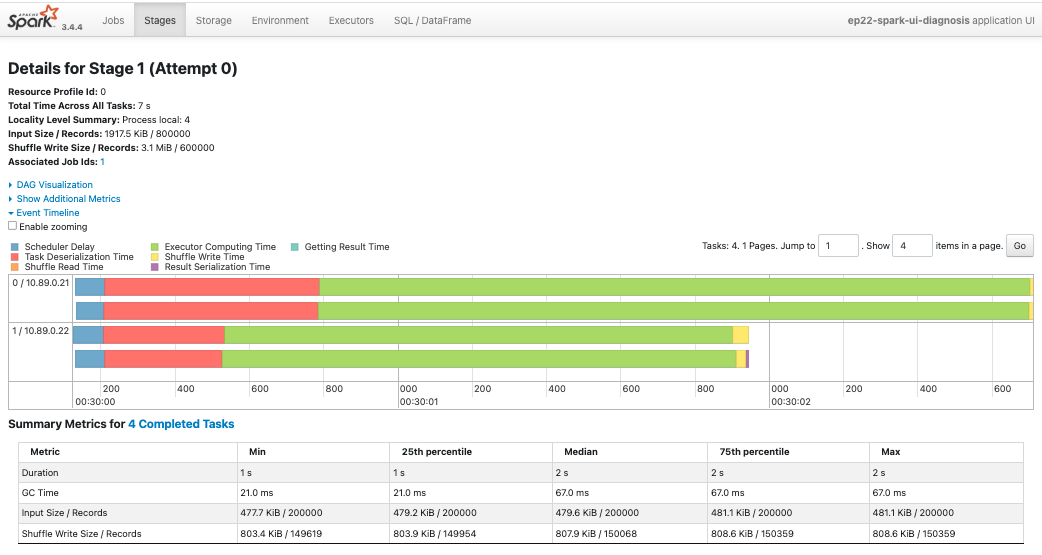
Stage 1 的四個 tasks 各讀取約 478–481 KiB input,並各自寫出約 804–810 KiB shuffle data。這是一個相當平均的 scan 加 shuffle write 基準。
Stage 2 則有八個下游 tasks。每個 task 的 Shuffle Read 約在 337–511 KiB 間,duration 約為 33 ms 到 0.6 秒;任務都成功完成,沒有一個 task 長時間拖住 stage。
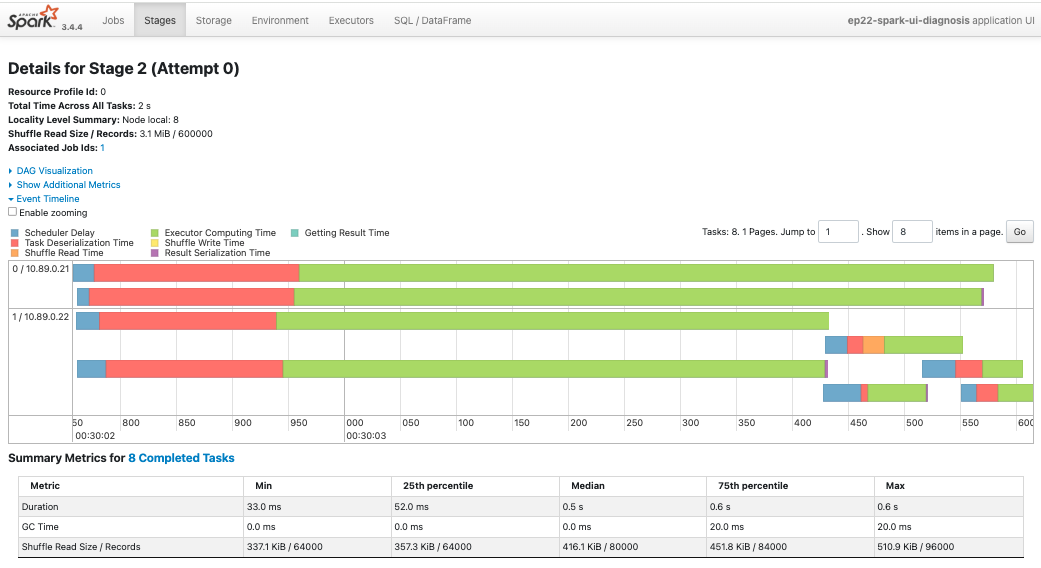
這張 timeline 還能連回 Ep16:兩個 Executors 各有 2 cores,因此這個 application 同時最多有四個 task slots。前四個 Stage 2 tasks 先開始,task slot 空出後其餘 tasks 再被排入。這是資源上限造成的正常排程節奏,沒有單一落後 task 的形狀。
當看到某個 Stage 特別久時,我會先將 Tasks table 依 Duration、Input Size、Shuffle Read Size 或 Records 排序。若只有少數 task 同時有明顯較長 duration 與更大的資料量,才形成「可能是 skew」的假設;Ep23 會用控制資料分布驗證這種情境。
Executors 頁將同一 application 的 task 數、Input、Shuffle Read/Write 與 GC time 匯總到每個 Executor。這次兩個 Executors 都完成 tasks,也都讀到接近 1 MiB 的 input,並各寫出約 1.6 MiB shuffle data。
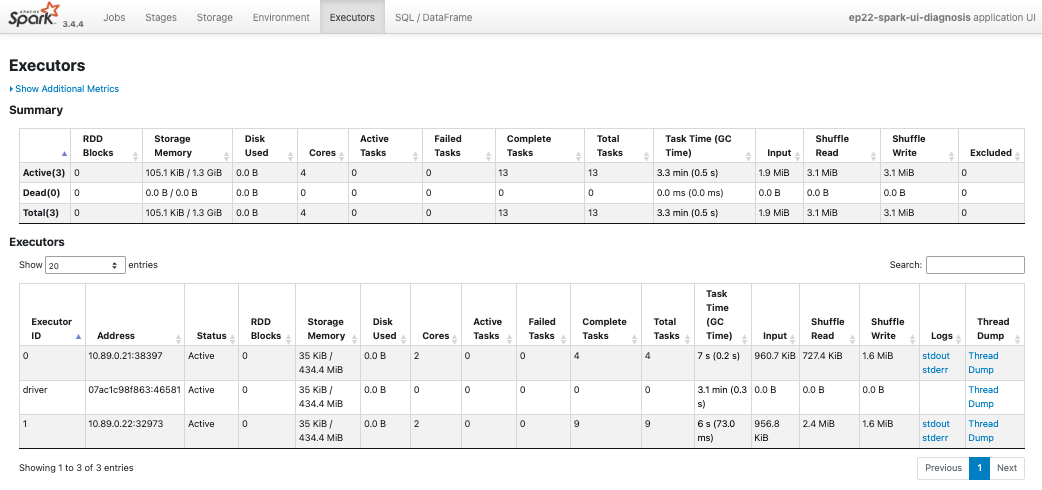
Executor 1 的 completed task 數較多,Shuffle Read 也較高。這些彙總值需要回到 Stage 的 Tasks table 交叉閱讀:它們告訴我該查看哪個 Executor 與哪些 tasks,還沒有單獨構成資源瓶頸的證據。
GC time 的數字也遵循同樣原則。這次可以看到 GC time,application 沒有失敗;畫面未展開 spill metrics,因此我不從這張截圖推論 memory 或 disk spill。關於這些疑似 memory 問題,我會在後面的文章展開 memory、spill、GC 與 partition 的相關實驗。
| 先看到的證據 | 下一個要驗證的問題 | 對應課程 |
|---|---|---|
| 少數 task 同時較慢且資料量較大 | key 或 partition 的資料是否偏斜? | Ep23:data skew |
| DAG 出現 Exchange,shuffle read/write 成本高 | 哪個 repartition、aggregation 或 join 造成資料交換? |
Ep24:join 策略與 shuffle 成本 |
| task 數量很大,但單個 task 時間很短 | 是否被大量 files 與 task launch overhead 主導? | Ep25:小檔案 |
| GC time、memory spill、disk spill 或 Executor error 異常 | Executor memory、資料量與 partition 如何互動? | Ep26:memory 與 spill |
| Pod/container 尚未啟動或突然終止 | 平台是否成功提供 application 的執行環境? | 回看 Ep20、Ep21 的 YARN/Kubernetes logs 路徑 |
慢 job 的第一步是定位時間花在哪個層級;找到假設後,再用下一個實驗驗證原因。
Spark UI 的 Jobs、Stages、Tasks 與 Executors 不是四張獨立報表。它們依序將同一個問題從 action 收斂到資料流、平行工作與資源 process。這次基準 job 很小,也沒有真正的異常;它讓我確認每個正常訊號長什麼樣子,之後才能辨認偏離基準的畫面。
下一篇會刻意讓少數 tasks 拿到遠多於其他 tasks 的資料,觀察 data skew 如何讓一個 Stage 等待少數 stragglers 完成。
🚀 GitHub:
Ep22|Spark job 變慢時,第一眼該看哪裡?從 Spark UI 建立診斷順序
🚀 spark-learning-lab 系列文章與實作:
https://github.com/jeffery5bai/spark-learning-lab
Apache Spark 3.4.4 — Web UI:
https://archive.apache.org/dist/spark/docs/3.4.4/web-ui.html

 jeffery5bai

 iThome鐵人賽
 看影片追技術