
第二十天,我們要進入現代機器學習中最實用且強悍的技術——集成學習。,昨天學到的單一決策樹雖然直觀好懂,但容易受到極端值干擾且極易過擬合。為了解決這個缺點,隨機森林透過 Bagging策略同時訓練幾十甚至幾百棵決策樹,最後透過投票表決決定分類結果。今天我們建立純 Python 腳本 day20_random_forest.py,掌握隨機森林建模,並透過特徵重要性長條圖找出影響預測結果的關鍵變數。
第一部分
新建 day20_random_forest.py。首先載入經典的乳癌檢測資料集,選取多項生理特徵,切分訓練集與測試集,並建立隨機森林分類器: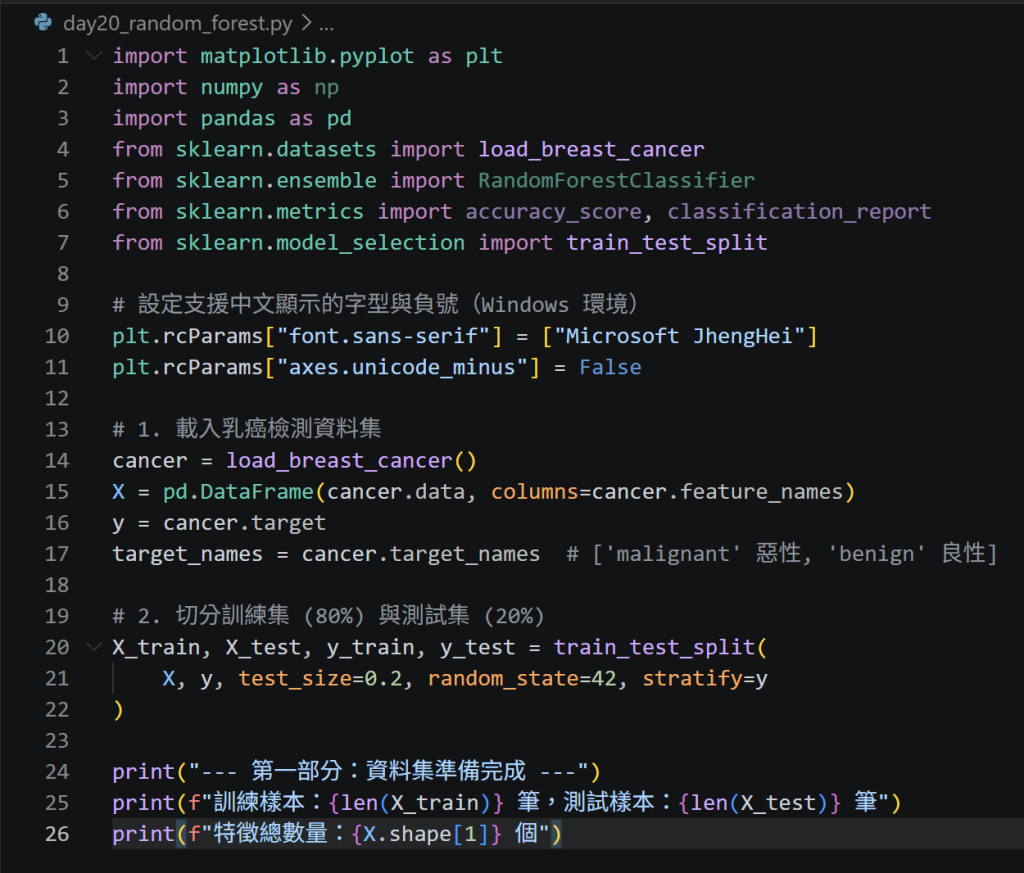
第二部分
初始化 RandomForestClassifier。我們設定 n_estimators=100(建立 100 棵決策樹進行投票集成),並限制 max_depth=5 保持適當複雜度,接著進行模型訓練與預測成效評估: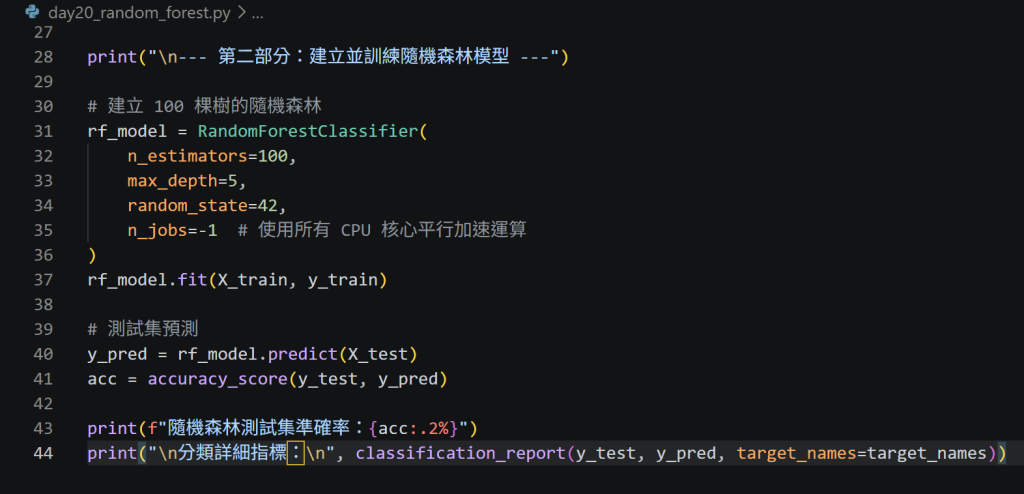
第三部分
隨機森林能夠評估每個特徵在所有樹中降低不純度(Gini Impurity)的總貢獻度,即 feature_importances_。我們擷取貢獻度最高的前 10 個核心特徵,並使用 Matplotlib 繪製水平長條圖: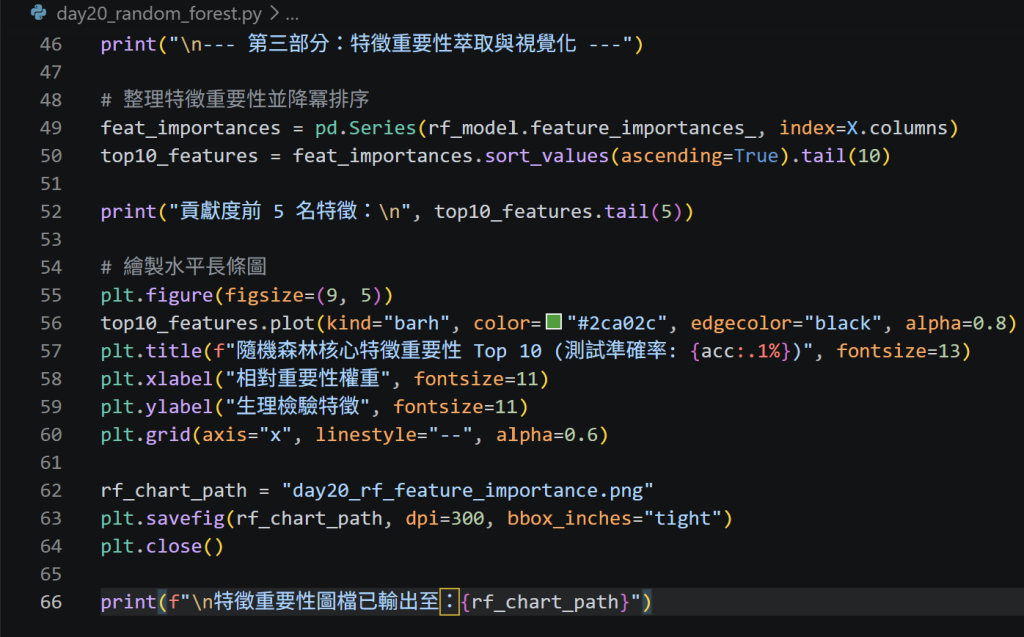
第四部分
在終端機輸入 python day20_random_forest.py 執行驗證,確認模型準確率(通常可達 95% 以上)、Top 10 特徵權重正常輸出,且圖片 day20_rf_feature_importance.png 順利產出。按 Ctrl + S 儲存後推送到 GitHub 進行版本控制: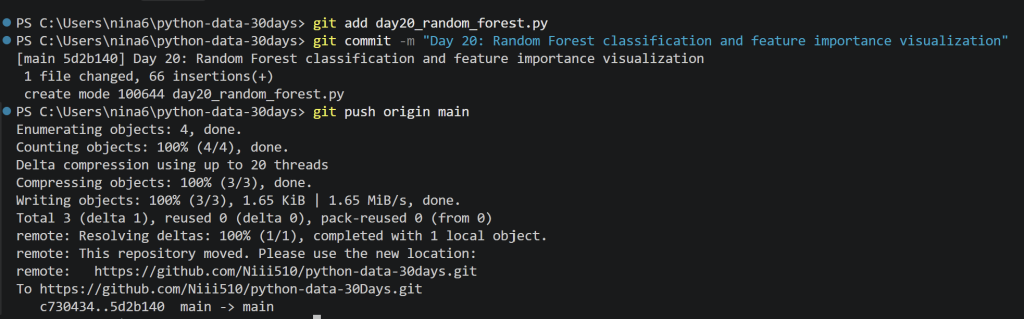
今日心得/遇到的問題
今天體驗了集成學習「隨機森林」的穩定與強大。相較於單一決策樹容易受噪訊影響,隨機森林透過兩層隨機性(隨機抽取樣本資料 + 隨機挑選特徵子集)大幅降低了模型的方差(Variance),在幾乎不調參的情況下就能取得極高準確率。此外,利用 feature_importances_ 可以快速對高維度資料進行特徵篩選(Feature Selection),在醫療檢驗或商業分析中能迅速辨識出「哪些指標才是主導判斷的關鍵因素」。

 niii

 iThome鐵人賽
 看影片追技術