
第二十一天,我們要邁向機器學習的全新板塊——非監督式學習!在前面幾天介紹的線性回歸、邏輯斯迴歸與隨機森林中,資料都附帶了明確的解答標籤,模型的工作是去預測答案。但在現實商業與醫學場景中,多數數據並沒有預設標籤(例如:客戶未被分群、未知的細胞亞型)。這時就需要讓演算法自行發掘數據間的內在相似度進行歸類。今天我們建立純 Python 腳本 day21_kmeans_clustering.py,掌握最經典的 K-Means 分群演算法,並透過Elbow Method找出資料的最佳分群數量。
第一部分
新建 day21_kmeans_clustering.py。模擬電商平台的客戶行為數據(年度總消費金額與消費頻率),並在進行距離計算前先使用 StandardScaler 將數值特徵標準化,避免特徵尺度的差異主導歐幾里得距離: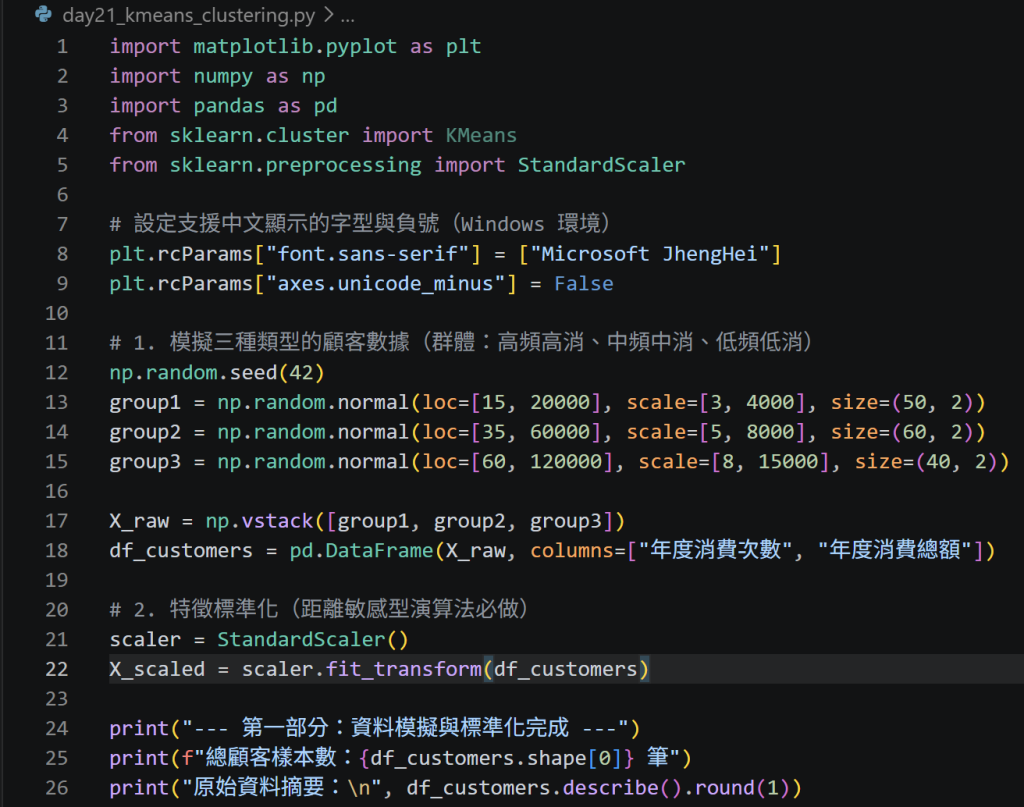
第二部分
K-Means 分群最關鍵的問題是「到底要分幾群(K = ?)」。我們透過測試不同的群數(K 從 1 到 8),計算每一組 K 對應的群內平方和(Inertia / WCSS),並繪製成折線圖。折線轉折劇烈趨緩的轉折點(手肘處),就是最佳分群數的判斷依據: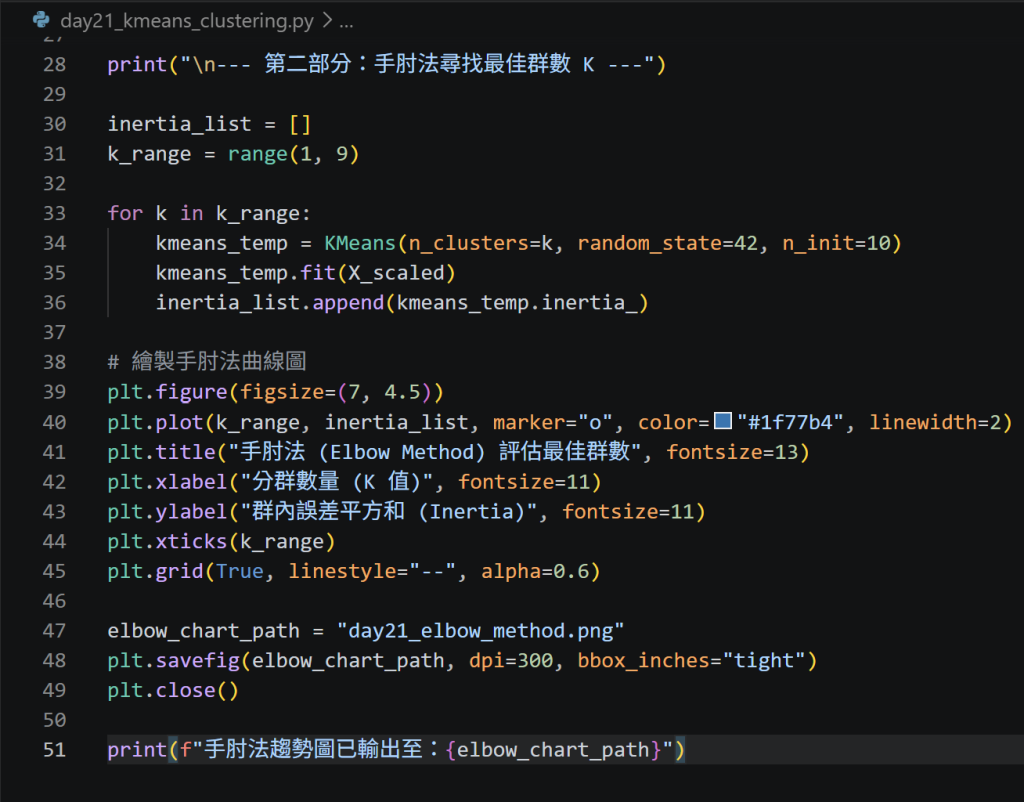
第三部分
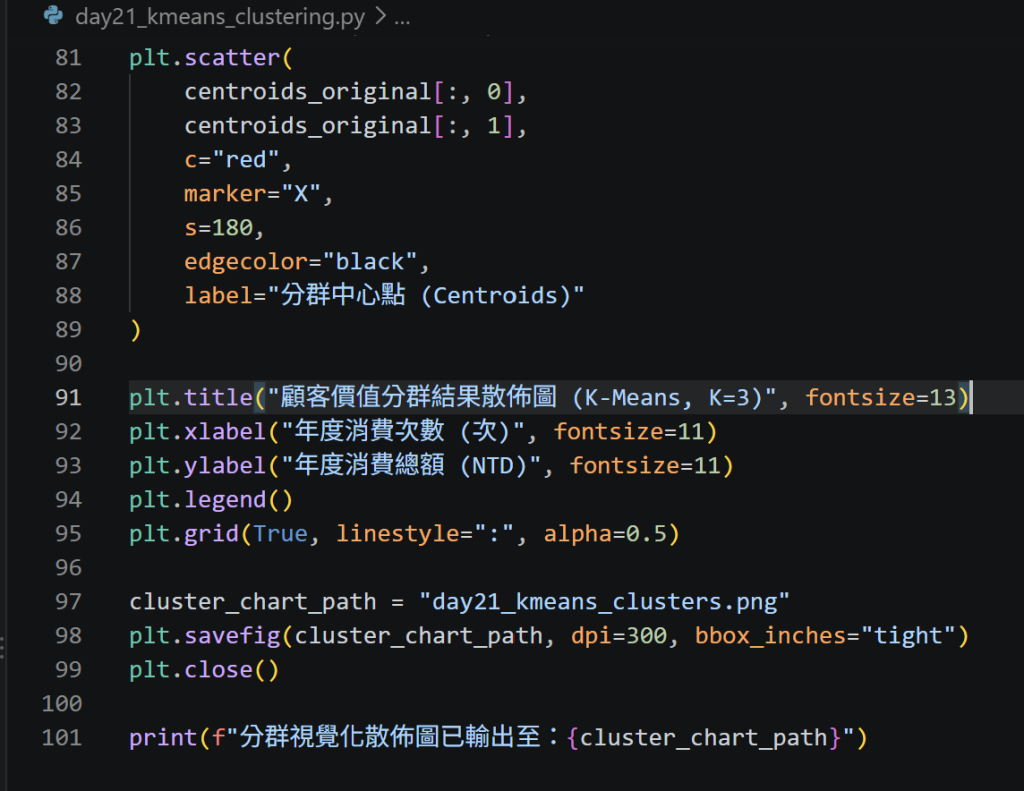
根據手肘法觀察(明顯轉折點出現在 K=3),我們固定 n_clusters=3 擬合模型,將分群標籤回填到原始資料表中,並繪製帶有分群質心(Centroids)的散佈圖: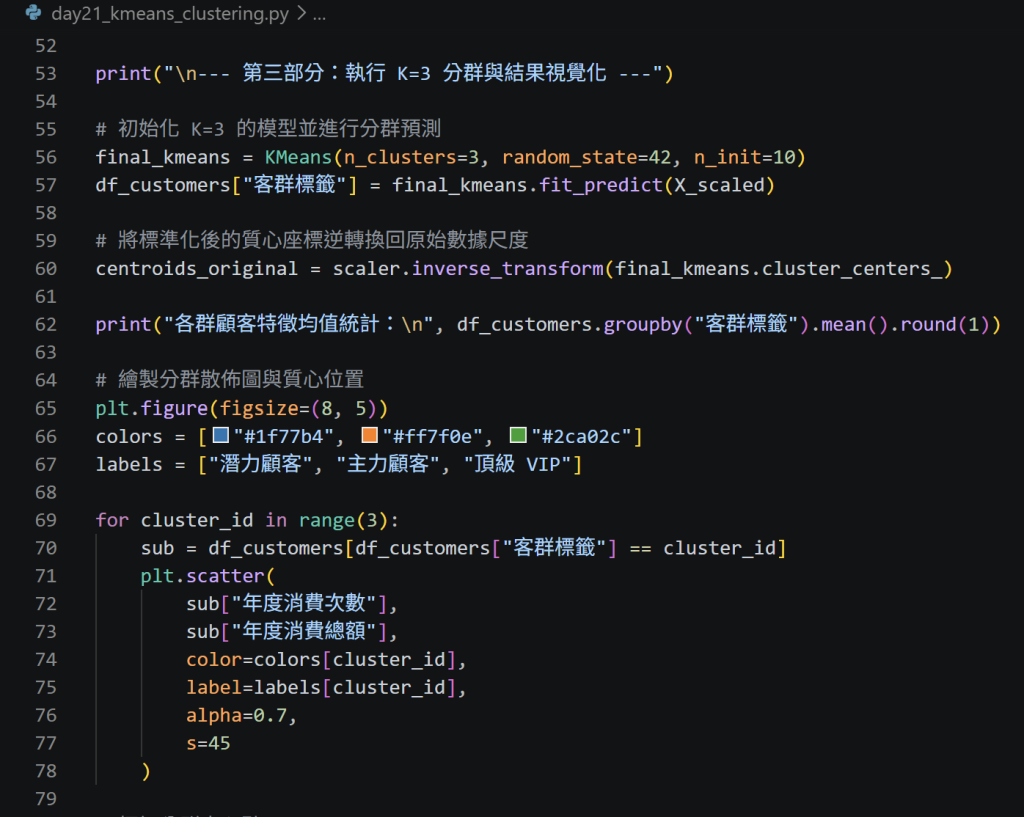
第四部分
在終端機輸入 python day21_kmeans_clustering.py 執行驗證,確認 Inertia 數值、分群統計均值順利輸出,且兩張圖表(手肘曲線圖與分群散佈圖)生成完畢。按 Ctrl + S 儲存後推送到遠端儲存庫: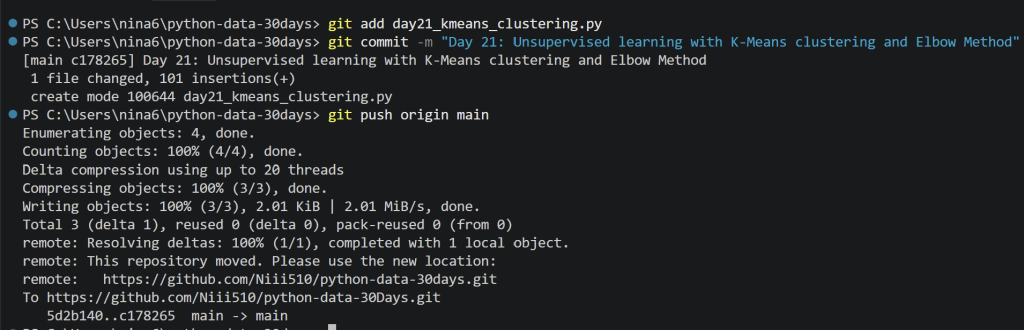
今日心得/遇到的問題
今天體驗了非監督式學習在探索未知資料結構時的強大能力。K-Means 的計算是基於點與質心之間的幾何距離,因此特徵標準化是絕對不能跳過的前置作業;如果消費總額動輒十幾萬而次數只有幾十次,演算法就會完全忽視次數欄位。此外,手肘法提供了一個科學且可視化的依據來協助判斷最佳的 K 值,在會員分群、市場區隔與異常檢測等業務場景中非常實用。

 niii

 iThome鐵人賽
 看影片追技術