
選擇一個模型接進程式,最麻煩的往往不是第一個請求,而是回答看起來正常,卻少了一個不能漏的條件。
DeepSeek V4 Flash值得關注的地方,是長上下文、結構化輸出與工具呼叫這組能力。不過,導入前至少要分清三件事:實際呼叫到哪個版本、如何判斷任務完成,以及失敗後誰來處理。這三件事會直接影響能不能把人工操作交給程式。
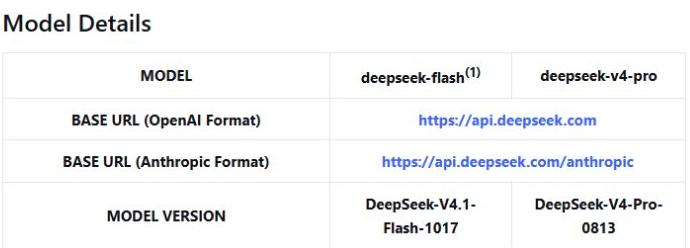
DeepSeek的10月17日官方更新說明介紹的是V4.1 Flash 1017,文件列出的API呼叫名稱為deepseek-flash。查詢V4 Flash時,也可能遇到第三方平台沿用的舊名稱。
2026年10月21日的既有呼叫紀錄中,透過Crazyrouter送出deepseek-v4-flash,回傳的模型欄位是deepseek-v4-flash-0731。它不能直接拿來證明1017新版的表現;回傳名稱本身也不是後端權重版本的獨立驗證。
如果要評估升級效果,至少要一起記錄供應管道、請求名稱、回傳名稱與思考模式。只留下「用了Flash」四個字,之後很難分辨結果變化來自模型、設定,還是服務端更新。
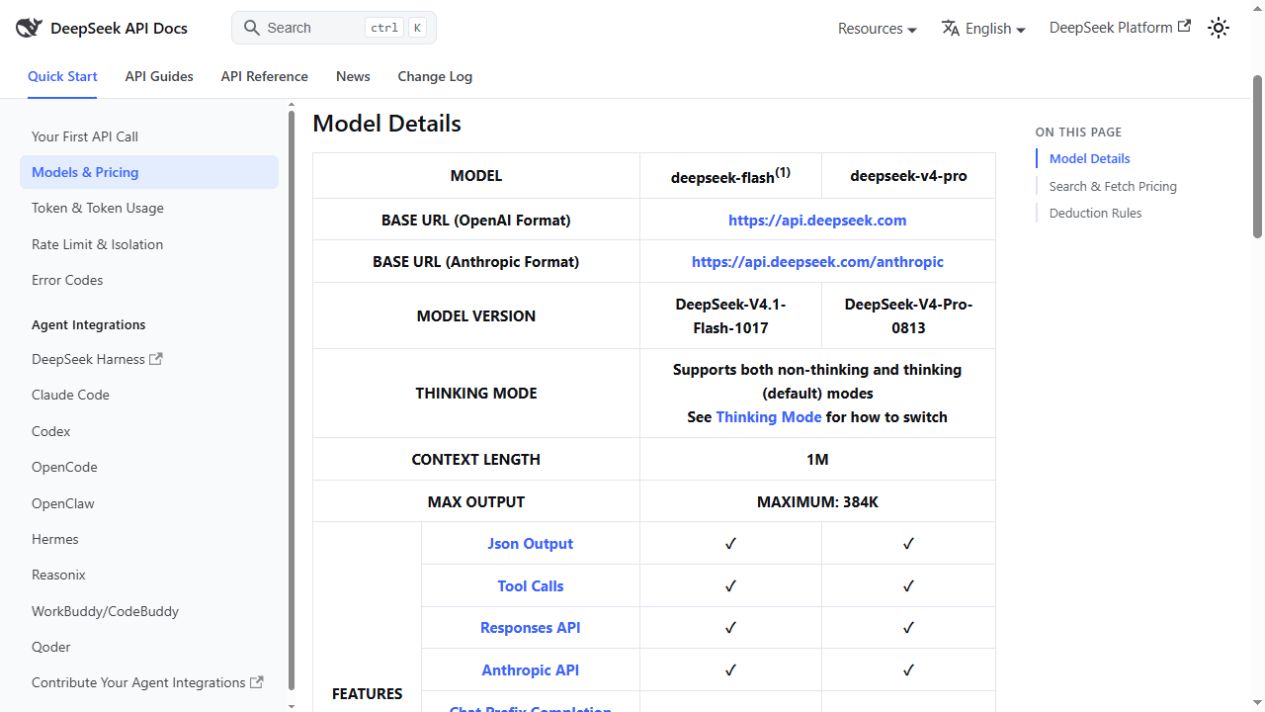
官方文件列出Flash的實際版本、1M上下文與最高384K輸出。這些是規格上限,不是任務正確率。
1M上下文讓一次提供較多資料成為可能,JSON輸出與工具呼叫則方便串接程式。不過,資料放得進去,不等於每個例外都找得出來;欄位能解析,也不代表值正確。驗收仍需要回到任務本身。
這批0731版本的小樣本紀錄,剛好呈現兩種不同結果。
在方案選擇題中,模型正確算出每月72美元的方案年費為864美元,也指出另一個方案既超過年度預算,又缺少回應時間承諾。對於明確列出的條件,它完成了逐項比對。
但在排程題中,一份需要2小時的報告只獲得11:00至12:00的時段,回答卻標示已完成2小時。15:00至17:00沒有安排任務,結尾又說沒有空閒時間。
如果程式只檢查「有沒有產出一份日程」,這個錯誤就會進入下一步。
比較實用的驗收方式,是把規則拆成應用程式能判斷的條件:每個任務的實際時長、截止時間、前後依賴,以及時段是否重疊。模型負責提出安排,程式負責確認安排成立。
內容改寫也有類似問題。原規則要求「收貨後7天內可提出退貨申請,檢查後決定是否批准」,壓縮後的回答保留了申請與批准的差別,卻漏掉「收貨後」。這類錯誤很難只靠檢查字數或輸出格式發現,政策內容仍適合交由人員覆核。
這幾筆結果不足以推論整體能力,也沒有驗證長文件檢索或程式碼修改,但足以幫助設計驗收:越重要的條件,越不該只相信模型自行宣告已滿足。
對個人開發者,適合從輸入與輸出都清楚的小任務開始。例如把客服留言整理成固定欄位,再由程式檢查必填值;或把技術文件整理成附來源的摘要,由使用者確認後採用。這些是建議的試用方向,並非這批測試已證明穩定可用。
對知識庫團隊,應先確認回答能否對應到來源。找不到資料時轉人工,通常比讓模型補出完整答案更容易管理。若涉及日期、資格或費用,抽查不能只看語氣是否自然。
對需要自動排程、修改正式政策或執行外部操作的系統,應先建立可驗證的規則與人工確認點。支援工具呼叫,只代表模型能提出工具請求;權限、實際執行與失敗復原仍是應用程式的責任。
用API做批次工作,費用取決於輸入與輸出用量,也會受到快取、重試及工具計費影響。聊天產品的訂閱費用不能直接代入API帳單。
以輸入每百萬token 0.45美元、輸出每百萬token 1.34美元的費率估算,一份資料輸入8000、輸出1500 token,處理1000份約為5.61美元。這個數字未計快取、重試與額外工具費,也不包含人工覆核。
若要核對接入管道,可先查看Crazyrouter的DeepSeek V4 Flash模型資訊,確認名稱與計費;官方管道則查DeepSeek文件。不同管道的密鑰與介面網址不能混用。
真正值得比較的,是同一批工作有多少能一次通過驗收、失敗需要重跑幾次,以及多少仍要人工修改。單次請求費用低,不能保證整項工作的成本低。
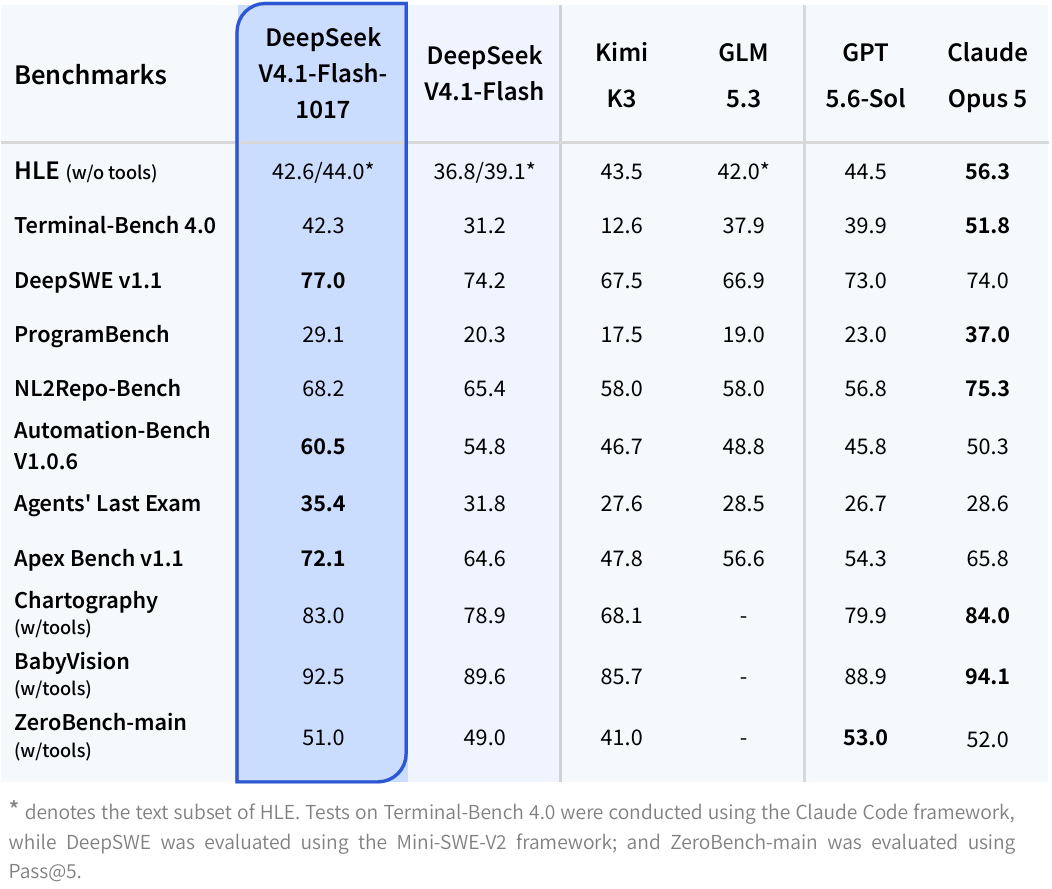
官方基準可以作為挑選候選模型的線索;不同任務與工具設定下,仍需自行確認完成率。圖中1017新版與前述0731呼叫紀錄應分開看。
DeepSeek V4 Flash適合列入文件整理、明確欄位擷取與受控文字加工的候選名單。它是否值得留下,取決於實際版本能否在你的資料上穩定完成工作。
開始時選一項容易檢查、出錯能退回的任務,保留一批固定樣本,再記錄通過率、人工修正時間與費用。簡單任務通過後再擴大用途,比一次接管整套流程更容易找出問題,也更容易判斷是否真的省下時間。
資料來源:DeepSeek模型規格與價格、V4.1 Flash 1017更新說明。官方資料與小樣本呼叫紀錄分開引用;插圖採官方頁面真實截圖與官方基準原圖。文字由AI輔助整理。

 17802032796

 iThome鐵人賽
 看影片追技術