
封面為主題示意,非產品介面截圖。
結論先講:DeepSeek V4-Pro、Qwen3.8 Max、GLM-5、Gemini 3.8 Flash這四款,在「能不能把程式碼寫對」這件事上,我沒有測出穩定高下。真正決定我隔天用哪一款的,是三個跟模型強弱無關的訊號:輸出能不能被程式直接接住、一件事要跑幾回合、失敗的時候是安靜還是吵鬧。
以下是我改掉原本判斷的過程,包含一個我算錯過的數字。
一開始我的想法很簡單:找一份公開排行榜,挑分數高的用就好。
試了一個月之後我放棄這條路。不是榜單造假,是它答不了我真正要問的問題:在我的呼叫方式下它多久回一次、跑完一件事要花多少錢、輸出能不能直接餵給下游程式。這三個問題全都跟接入方式綁在一起——同一個模型換一家服務商,延遲、限流和計費方式都會變。榜單上的差距搬進我的場景經常不成立,我這裡出現的差距榜單上也從來不顯示。
我沒有另外架一套評測環境,就用日常的專案下去試。四款全部掛在Crazyrouter這一個相容OpenAI的入口,換模型只改一個字串,不必為每一款重接一次。
每一筆呼叫我固定記四個欄位:回合數、正文實際字元數、結束原因、推理token數。缺一欄就會漏掉一整類問題。
我遇過一件事:要求模型「只輸出一個JSON物件,不要解釋」,回傳的JSON欄位齊全、值也正確,但JSON前面還有一大段推理文字。程式從第一個字元開始讀,讀到的是思考不是JSON,當場報錯。內容沒錯,程式用不了。
四款在這件事上的表現不一樣:有的把推理單獨放在另一個欄位,正文裡只有答案;有的把推理直接寫進正文,外面套一層標記。
我原本的解析器寫法是「取閉合標記之間的內容」。這個寫法遇到只有開頭、沒有結尾的回覆時,會把整段都當成正文,答案和推理混得比原本更死。我用了很久才發現,有一次它把整段思考當答案存進了資料庫。
判斷方法不複雜,拿幾筆真實呼叫看四件事就夠:有沒有獨立的推理欄位、正文裡有沒有標記、標記有沒有正常閉合、去掉推理之後正文還剩多少字。第三種最容易漏。
我最早判斷「這款貴不貴」,是用一道題試的,算出來比對手貴10.6倍。後來把題量加上去,同樣的對比變成只差21%。
一道題算出來的倍數不是倍數,是那一道題的運氣。 現在我的規矩是:單題結果只能用來發現問題,不能用來下結論。
這一條我一開始完全沒在意,直到被咬了一次。
有一道在400行日誌裡找線索的題,DeepSeek V4-Pro跑了六回合、吃進去42766個輸入token,最後回傳一個空字串。介面狀態是正常完成——沒有報錯、沒有異常、沒有觸發重試、沒有任何告警,只有帳單上多了那一筆。
答錯會產生一個事件、有人會看見。什麼都不回傳卻回報成功,不產生任何事件,只產生帳單。 所以我現在把「成功但正文長度為零」單獨告警,不混進「失敗」一起統計——混進去會被平均掉,看報表只覺得準確率普通,看不出它在悄悄空轉。
以下是我在Crazyrouter上付的單價,每百萬token,按量計費、沒有方案:
| 模型 | 輸入 | 輸出 | 快取 |
|---|---|---|---|
| DeepSeek V4-Pro | $0.67 | $2.00 | — |
| GLM-5 | $1.00 | $3.20 | — |
| Gemini 3.8 Flash | $0.75 | $3.75 | 快取輸入$0.075 |
| Qwen3.8 Max | $2.00 | $6.00 | 快取讀取$0.25 |
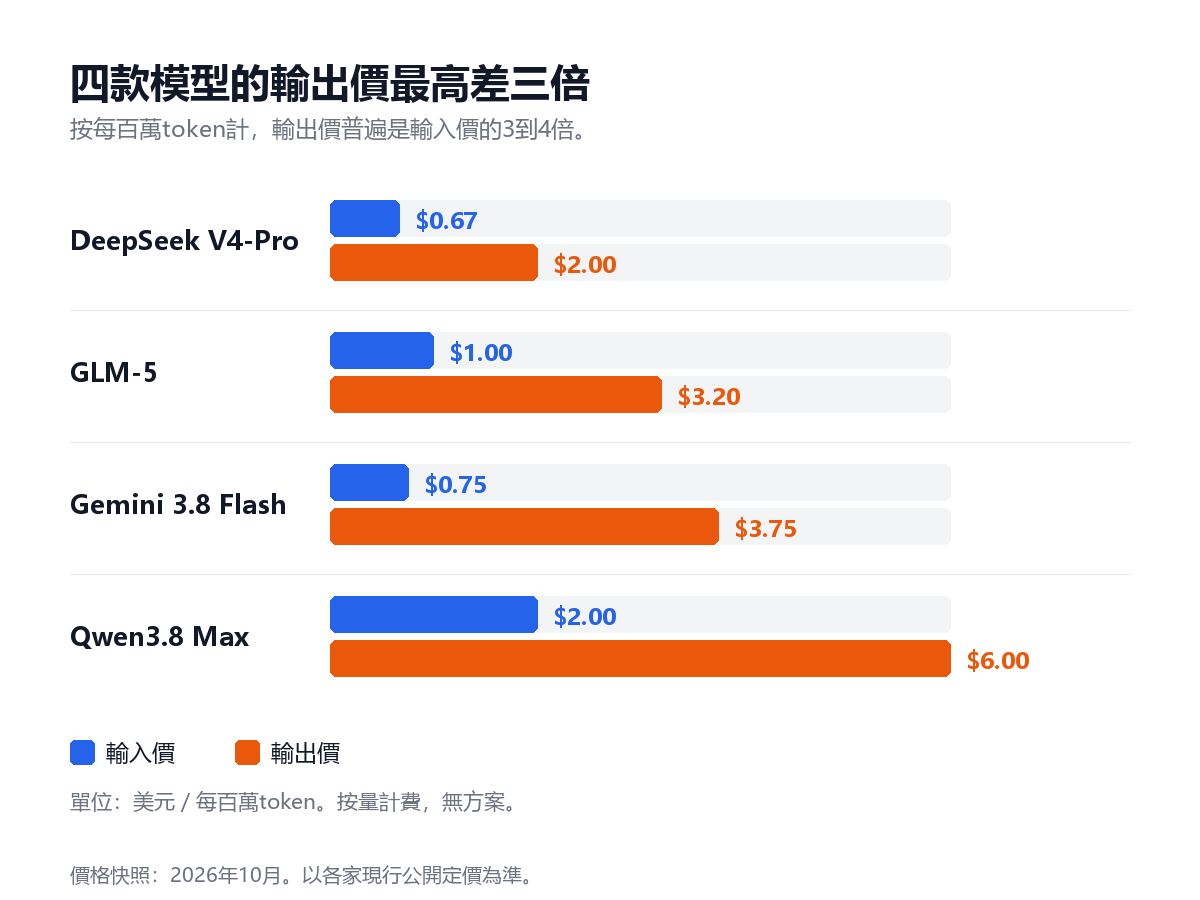
四款的單價放在一起看。輸出價普遍是輸入價的3到4倍,這個比例決定了帳單結構。
其中DeepSeek V4-Pro這一列比官方定價低49%——官方是$1.32和$3.96。
看起來很清楚:Qwen3.8 Max最貴,DeepSeek V4-Pro最便宜。 但這張表本身會騙人,兩個原因。
第一,昂貴的模型可能花得更少。 輸入單價最低的那一款,輸出單價不一定低;多數工作是輸入多、輸出少,帳單結構跟直覺相反。
第二,快取能把帳翻過來。 Gemini 3.8 Flash的快取輸入是$0.075,只有原價的十分之一。同一份長文件反覆問,快取命中不命中,比選哪一款影響大得多。
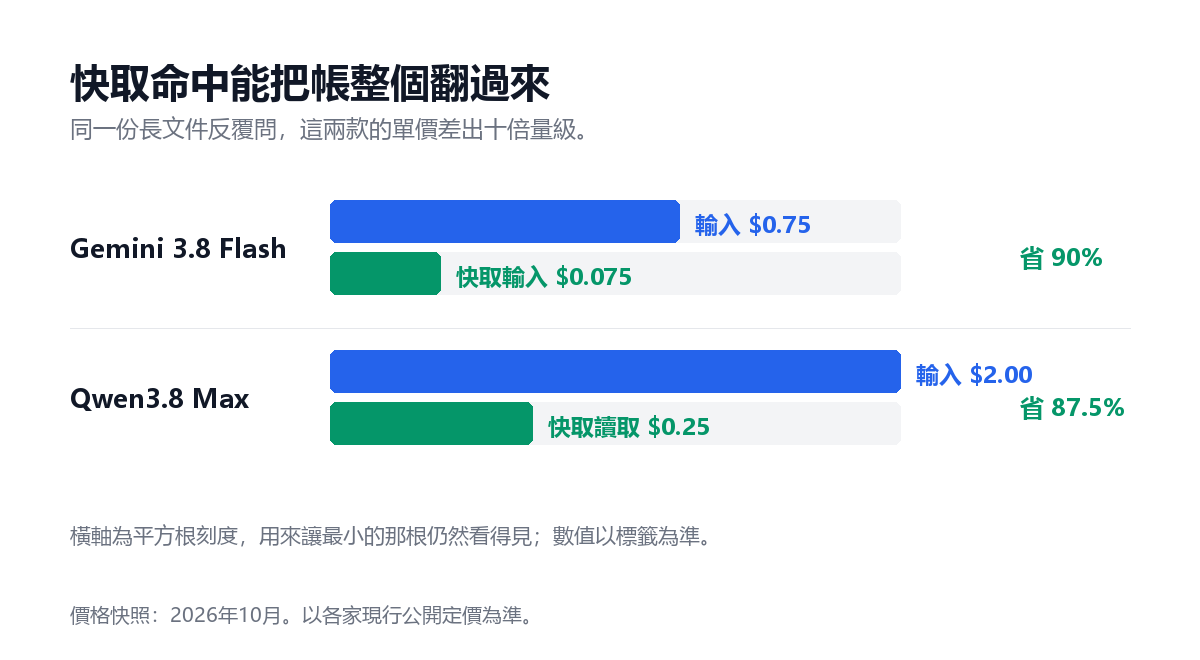
同一份文件反覆問的場景下,命中快取和沒命中,單價差出一個量級。
| 場景 | 我用哪一款 | 為什麼 |
|---|---|---|
| 改程式碼、寫函式、批次跑 | DeepSeek V4-Pro | 回合數最少,速度和成本一起省 |
| 翻長文件、長日誌 | Gemini 3.8 Flash | 上下文給到100萬,不用切檔 |
| 中文寫作、中文語感 | Qwen3.8 Max或GLM-5 | 沒有穩定偏好,先試便宜的 |
| 輸出要直接餵給程式 | 先看輸出通道,再看模型 | 接不住的話強也沒用 |
| 不確定的時候 | 兩款都跑一遍 | 不猜,直接比 |
最後一列是我現在用得最多的。四款都接在Crazyrouter這一個入口,不想寫程式也行,同一個題目丟給不同模型看結果,Model Arena就是做這件事的。價格頁與橫向對照也在同一站:DeepSeek V4-Pro有一張即時價格頁,全部38個對話模型的對照在價格總覽。
這不是四款的通用能力排名。 只有DeepSeek V4-Pro是在同一套腳本、同一批題目上真跑過的,那筆42766token的案例來自那次實測;另外三款的判斷來自日常觀察,不是受控實驗。價格也是2026年10月的數字,以頁面為準。
用了一個月,我最確定的結論反而是反方向的:這四款沒有誰全面壓過誰,只有誰更適合你手上這件事。 先看清自己的工作長什麼形狀,再去對模型,比看分數快得多。

 17802032796

 iThome鐵人賽
 看影片追技術