
一、前言
在前幾天的學習中,我已經完成健康紀錄的新增、查詢、修改與刪除,也學會計算平均喝水量、平均睡眠時間,以及每週運動總時間。
然而,當健康紀錄逐漸增加時,只透過表格與數字查看資料,可能不容易發現長期的變化。例如,睡眠時間是否逐漸增加、喝水量是否每天都差不多,以及最近幾週的運動時間是否有所改變。
因此,今天將學習如何使用圖表呈現健康資料,並透過 Streamlit 內建的圖表功能,將每日紀錄與每週運動統計轉換成更容易閱讀的視覺化資訊。
二、學習目標
了解資料視覺化的目的與常見圖表類型。
使用 Pandas 整理適合繪圖的健康資料。
使用 Streamlit 的 st.line_chart() 呈現每日健康趨勢。
使用 st.bar_chart() 比較每週運動時間。
將圖表整合到個人健康習慣追蹤系統。
測試沒有資料、資料缺失及日期不完整時的呈現情況。
三、認識資料視覺化
資料視覺化是將原本的數字或表格轉換成圖形,讓使用者更容易理解資料的分布、差異與變化趨勢。
在健康習慣追蹤系統中,可以依照不同的分析目的選擇適合的圖表。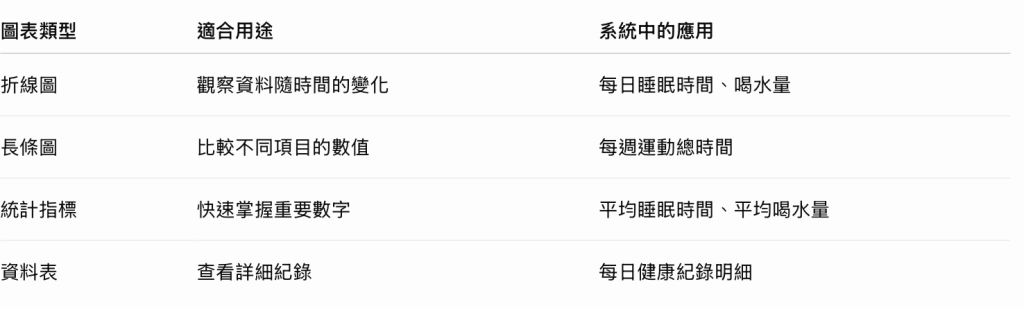
例如,若想知道最近七天的睡眠時間是否穩定,折線圖通常比單純閱讀七個數字更容易辨認變化。
若想比較不同週的運動總時間,長條圖則能清楚呈現各週之間的差異。
因此,圖表的選擇應該依照想回答的問題決定,而不是單純將所有資料都畫成圖。
四、使用 Streamlit 建立第一張圖表
Streamlit 提供了簡單的圖表函式,不需要先建立複雜的圖形物件,就能將 Pandas 資料呈現在網頁中。
例如,先建立一組測試資料:
import pandas as pd
import streamlit as st
data = pd.DataFrame({
"日期": [
"10/19",
"10/20",
"10/21",
"10/22",
"10/23"
],
"喝水量": [1500, 1800, 2000, 1700, 2200]
})
st.title("每日喝水量趨勢")
st.line_chart(
data.set_index("日期")["喝水量"]
)
這段程式會建立一張折線圖,橫軸代表日期,縱軸代表喝水量。
其中:
pd.DataFrame():建立表格形式的資料。
set_index("日期"):將日期設定為圖表的索引。
st.line_chart():將資料繪製成折線圖。
透過這種方式,就能將原本的數字轉換成容易閱讀的趨勢圖。
五、讀取健康紀錄並整理資料
在正式系統中,不需要每次手動輸入測試資料,而是應該直接讀取先前保存的 health_records.csv。
目前系統使用的主要欄位如下:
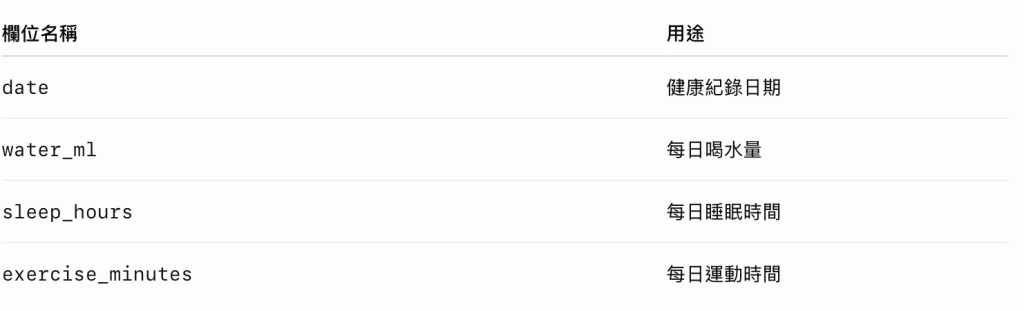
在繪製圖表之前,需要先將日期轉換成日期格式,並將喝水量、睡眠時間與運動時間轉換成數值。
import pandas as pd
from pathlib import Path
FILE_PATH = Path("health_records.csv")
if FILE_PATH.exists():
records = pd.read_csv(FILE_PATH)
records["date"] = pd.to_datetime(
    records["date"],
    errors="coerce"
)

for column in [
    "water_ml",
    "sleep_hours",
    "exercise_minutes"
]:
    records[column] = pd.to_numeric(
        records[column],
        errors="coerce"
    )

records = records.dropna(subset=["date"])
records = records.sort_values("date")

print(records)
else:
print("目前尚無健康紀錄。")
這個步驟的重點是讓資料具有一致的格式,避免因為日期或數值格式不正確,造成圖表無法正常顯示。
如果 CSV 檔案缺少必要欄位,實際系統還需要先檢查欄位是否存在,再執行轉換與繪圖。
六、實作:建立健康資料視覺化儀表板
接下來,將每日喝水量、睡眠時間與每週運動時間整合成一個視覺化頁面。
請先備份目前的 app.py,再將以下完整程式碼放入檔案中。此版本會讀取既有 CSV,不會覆寫原本的健康紀錄。
from pathlib import Path
import pandas as pd
import streamlit as st
FILE_PATH = Path("health_records.csv")
st.set_page_config(
page_title="個人健康習慣追蹤系統",
page_icon="🌱",
layout="wide"
)
st.title("🌱 個人健康習慣追蹤系統")
st.subheader("健康資料視覺化")
if not FILE_PATH.exists():
st.info("目前尚無健康紀錄,請先新增每日健康資料。")
st.stop()
try:
records = pd.read_csv(FILE_PATH)
except (OSError, pd.errors.ParserError, UnicodeDecodeError):
st.error("讀取健康紀錄失敗,請檢查 CSV 檔案。")
st.stop()
if records.empty:
st.info("目前沒有可供分析的健康紀錄。")
st.stop()
required_columns = [
"date",
"water_ml",
"sleep_hours",
"exercise_minutes"
]
missing_columns = [
column
for column in required_columns
if column not in records.columns
]
if missing_columns:
st.error(
"健康紀錄缺少必要欄位:" + ", ".join(missing_columns)
)
st.stop()
records["date"] = pd.to_datetime(
records["date"],
errors="coerce"
)
for column in [
"water_ml",
"sleep_hours",
"exercise_minutes"
]:
records[column] = pd.to_numeric(
records[column],
errors="coerce"
)
records = records.dropna(subset=["date"]).copy()
if records.empty:
st.info("目前沒有有效的日期資料。")
st.stop()
for column in [
"water_ml",
"sleep_hours",
"exercise_minutes"
]:
records.loc[records[column] < 0, column] = float("nan")
daily = records.groupby(
records["date"].dt.normalize()
).agg(
water_ml=("water_ml", "mean"),
sleep_hours=("sleep_hours", "mean"),
exercise_minutes=("exercise_minutes", "sum")
).sort_index()
st.write("以下圖表根據目前已保存的健康紀錄產生。")
st.subheader("每日喝水量趨勢")
water_chart = daily[["water_ml"]].dropna()
if water_chart.empty:
st.info("目前沒有有效的喝水量資料。")
else:
st.line_chart(
water_chart,
y="water_ml",
x_label="日期",
y_label="喝水量(毫升)"
)
st.subheader("每日睡眠時間趨勢")
sleep_chart = daily[["sleep_hours"]].dropna()
if sleep_chart.empty:
st.info("目前沒有有效的睡眠時間資料。")
else:
st.line_chart(
sleep_chart,
y="sleep_hours",
x_label="日期",
y_label="睡眠時間(小時)"
)
st.subheader("每週運動總時間")
exercise_data = daily[
["exercise_minutes"]
].dropna().copy()
if exercise_data.empty:
st.info("目前沒有有效的運動時間資料。")
else:
exercise_data["week"] = (
exercise_data.index
.to_period("W-SUN")
.astype(str)
)
weekly = exercise_data.groupby("week").agg(
    total_exercise_minutes=("exercise_minutes", "sum")
)

st.bar_chart(
    weekly,
    y="total_exercise_minutes",
    x_label="週次",
    y_label="運動總時間(分鐘)"
)
st.divider()
st.subheader("每日健康紀錄明細")
display_records = daily.reset_index(names="date")
st.dataframe(
display_records.sort_values("date", ascending=False),
use_container_width=True,
hide_index=True
)
st.caption(
"同一天的多筆喝水量與睡眠紀錄會取平均,"
"運動時間則會加總。未記錄的日期不代表沒有相關活動。"
)
程式碼重點說明
daily = records.groupby(
records["date"].dt.normalize()
).agg(
water_ml=("water_ml", "mean"),
sleep_hours=("sleep_hours", "mean"),
exercise_minutes=("exercise_minutes", "sum")
)
如果同一天有多筆紀錄,這個版本會將喝水量與睡眠時間取平均,並將運動時間加總。
這是一種簡化的處理方式。實際使用時,必須先確認喝水量是「全天總量」還是「單次喝水量」,以及睡眠時間是否為不同睡眠時段,避免把不同意義的數據直接合併。
water_chart = daily[["water_ml"]].dropna()
dropna() 可以排除沒有有效喝水量的日期,避免無效數值影響圖表。
不過,這不代表所有沒有紀錄的日期都能被補成零。若使用者當天沒有填寫資料,系統並不知道他實際喝了多少水,因此應保留資料缺失的意義。
st.line_chart(
sleep_chart,
y="sleep_hours",
x_label="日期",
y_label="睡眠時間(小時)"
)
折線圖可以呈現睡眠時間隨日期的變化,幫助使用者觀察數值是否有明顯起伏。
st.bar_chart(
weekly,
y="total_exercise_minutes",
x_label="週次",
y_label="運動總時間(分鐘)"
)
長條圖可以將每週運動總時間並列比較,讓不同週之間的差異更加明顯。
七、實際執行與測試
完成程式碼後,開啟終端機,進入專案資料夾,執行:
python -m streamlit run app.py
接著,確認網頁中的圖表是否能正確呈現。
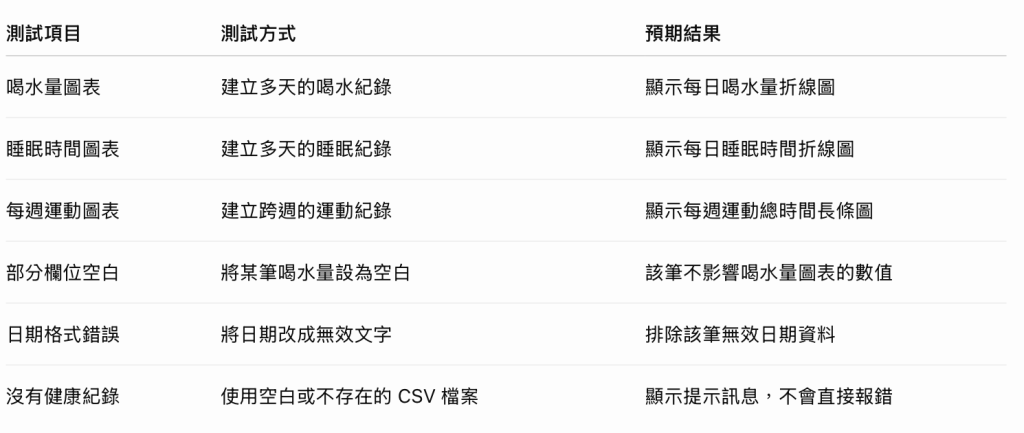
測試時,可以先建立至少五至七天的測試紀錄,讓圖表有足夠的資料點。如果所有日期的數值都相同,折線圖仍然可以正常顯示,但不容易看出變化。
另外,若同一天存在多筆紀錄,應確認彙整方式是否符合資料的實際意義。若每天只會保存一筆完整的健康紀錄,就不需要特別處理同日多筆資料。
八、今日成果與學習心得
今天完成了健康習慣追蹤系統的基礎資料視覺化功能,學習如何利用 Pandas 整理日期與數值,再透過 Streamlit 將資料呈現為折線圖及長條圖。
透過這次實作,我了解到資料分析不只是計算平均值或總和,也可以透過視覺化方式,讓使用者更直觀地理解資料中的變化。
例如,平均睡眠時間可以提供整體概況,但無法完整呈現每天的差異;折線圖則能讓使用者觀察哪些日期的睡眠時間比較長或比較短。同樣地,每週運動總時間的長條圖也可以幫助使用者比較不同週的活動情況。
此外,我也學到圖表的正確性取決於資料品質。如果資料有缺失、日期格式錯誤或重複紀錄,就可能影響圖表的解讀。因此,在建立圖表之前,必須先進行資料清理與彙整。
九、下一步學習方向
第二十二天的主題是「習慣完成率計算——追蹤個人目標的達成情況」。
下一階段將學習如何設定個人的健康習慣目標,例如每日喝水量、每週運動次數等,再根據實際紀錄計算目標完成率。
透過完成率與目前的統計圖表結合,系統就能從單純呈現健康資料,進一步發展成協助使用者追蹤個人習慣目標的工具。

 corn0414

 iThome鐵人賽
 看影片追技術