
今天處理一個很實際的問題:怎麼知道自己「走完了」?
先講一個很多人踩過的坑。如果你打開一個專案,跟 AI 說「幫我分析這個專案」,它會做什麼?
它會從資料夾裡第一個檔案開始讀。
這就是為什麼你會漏掉半個系統。
目錄結構反映的是「檔案怎麼擺」,不是「系統怎麼跑」。而在十五年的系統裡,這兩件事差距大到不可思議。
更關鍵的是:讀完所有檔案,不等於走過所有流程。
你可以把每支程式都讀一遍,然後對每支分別產出說明。但那樣得到的是一堆零件說明書,不是「系統怎麼運作」。使用者從按下按鈕到資料進資料庫,中間可能跨了八支程式、兩支預存程序、一個觸發器。這條路徑不會出現在任何單一檔案的說明裡。
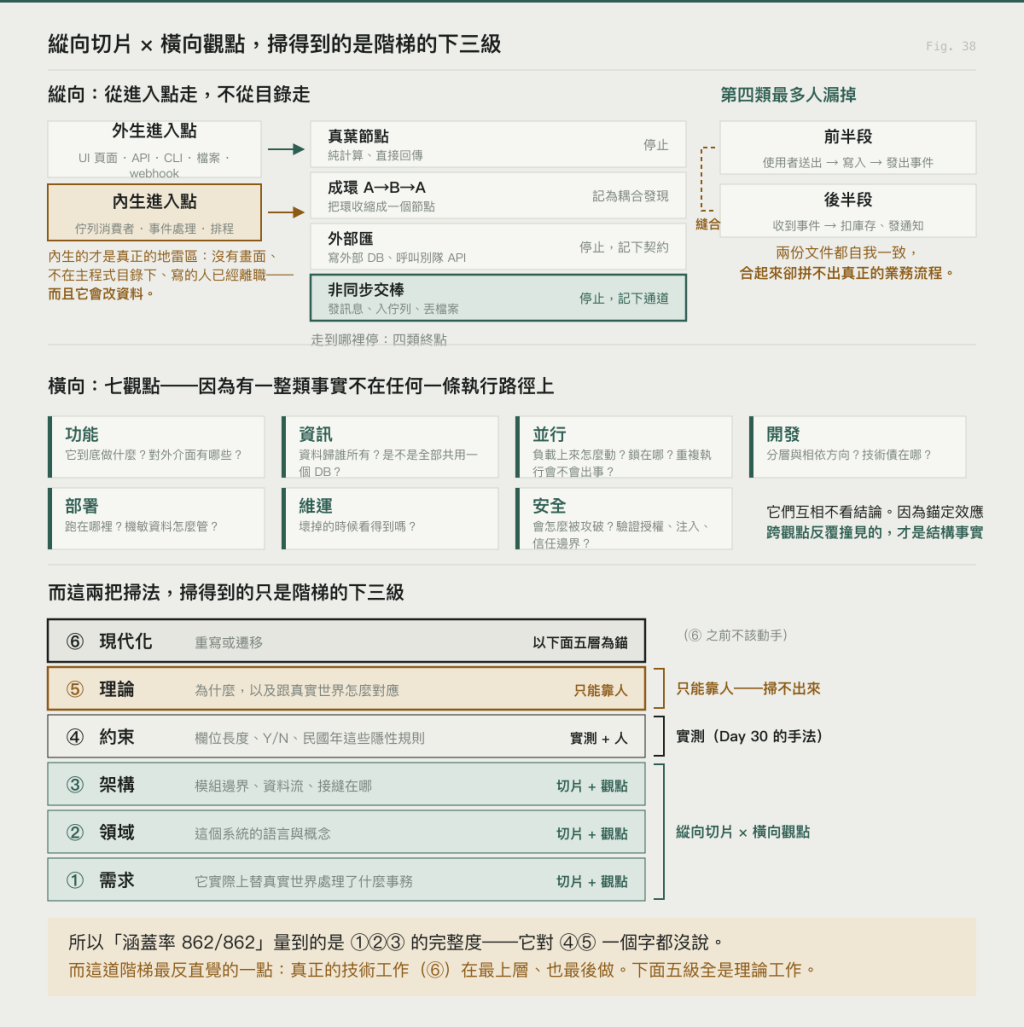
所以要從進入點走。而進入點有兩類,大部分人只想到一半:外生進入點(外部訊號觸發):UI 頁面、API 端點、CLI、檔案輸入、webhook。內生進入點(系統自己的非同步訊號觸發):訊息佇列的消費者、事件處理器、檔案監看、排程作業。
外生的看得見——有畫面、有網址、有人會去點。內生的才是舊系統真正的地雷區:沒有畫面、不在主要程式目錄下、可能是個獨立的排程專案、寫的人已經離職,而且它會改資料。我看過的遷移案裡,上線後爆掉的原因有相當比例是「有一個沒人記得的排程,在新系統裡沒有對應的東西」。
從進入點往下遞迴,走到四類終點之一:
| 終點 | 例子 | 處理 |
|---|---|---|
| 真葉節點 | 純計算、直接回傳 | 停止 |
| 成環 | A→B→A | 把環收縮成一個節點,環本身記為耦合發現 |
| 外部匯 | 寫外部資料庫、呼叫別隊的 API | 停止,記下契約 |
| 非同步交棒 | 發訊息、入佇列、發事件、丟檔案 | 停止這條流,記下通道 |
兩條規則要強調。
一、只遞迴進「自己的程式」。 外部相依當黑箱,記下契約就好。不然你會花三天讀 ORM 的原始碼,而那對理解業務毫無幫助。
二、要含動態邊。 依賴注入、反射、事件、HTTP、訊息。這些「類別 A 依賴類別 B」的靜態分析看不到的邊,都要納入。舊系統裡透過設定檔決定要呼叫哪個實作的情況非常常見,靜態工具會直接斷在那裡。
第四類終點是最關鍵、也最多人漏掉的。
當一條流程走到「發出一則訊息」的時候,這條流結束了。但系統的流程沒有結束。一定有某個接收端把它接回去繼續處理。
所以每一個「發訊息」的終點,都要去比對通道的身分(topic 名、佇列名、事件型別、檔案命名規則),把它連到對應的內生進入點。
不做會怎樣?
你會還原出兩個半個 use case。
前半段是「使用者送出,系統寫入,發出一則事件」。看起來完整,其實斷在半路。後半段是「收到事件,扣庫存、發通知、更新報表」。看起來也完整,但你不知道它從哪裡來。兩份文件都自我一致,合起來卻拼不出真正的業務流程。 而且很難察覺,因為兩邊看起來都沒問題。縫合的過程還會順便撈到兩種發現:
這兩種孤兒通常都很有價值,而且只有做了縫合才會浮出來。
縱向走完,還是不夠。
因為有一整類的事實,它不在任何一條執行路徑上:
你把每支程式都讀完、每條切片都走完,也不會有任何一個時刻讓你「發現」這些事。因為它們不是某段程式在做的事,而是整個系統呈現出來的性質。補這一塊的方法是換一組問法。不問「這支程式在做什麼」,改問「這個系統在某個面向上是什麼樣子」。
我用 Rozanski & Woods 的七觀點,每個配一句白話提問:
| 觀點 | 一句話提問 |
|---|---|
| 功能 | 它到底做什麼?對外介面有哪些? |
| 資訊 | 它知道什麼?資料歸誰所有?是不是全部共用一個資料庫? |
| 並行 | 負載上來怎麼動?鎖在哪?重複執行會不會出事? |
| 開發 | 它怎麼被修改?分層與相依方向?技術債在哪? |
| 部署 | 跑在哪裡?環境、拓樸、機敏資料怎麼管? |
| 維運 | 壞掉的時候看得到嗎?日誌、健康檢查、可觀測性? |
| 安全 | 會怎麼被攻破?驗證授權、注入、信任邊界? |
實務上我會為每個觀點派一個獨立的分析,各自帶著精確的範圍和該找的證據。
而且它們互相不看結論。因為錨定效應。如果第一份報告寫了「這個系統的權限模型是 RBAC」,後面六個會傾向用那個框架去解釋自己看到的東西,即使證據不太支持。
(我看過一個案子實際用這七個觀點做了一份完整的舊系統理解報告,作為後續回顧的判準來源。那份報告的價值不在於它多完整,在於它讓「我們對這個系統的理解」變成一份可以被檢驗的東西。)
七份報告拿到手,最有價值的動作不是把它們串起來,而是找出同一件事被幾個不同觀點各自撞見。舉例:
三個觀點各自獨立分析,用不同的語言、從不同角度,講的是同一件事:**這兩個模組其實沒有分開。**當一件事被三個觀點各自撞見,它就不是某份報告的過度解讀,而是系統真正的結構事實。
反過來說,只有一個觀點提到、其他六個都沒撞到的發現,我會給比較低的權重。
最後講記帳,這是我後來才加、但覺得應該一開始就要有的東西。做法很簡單:開工前先清點所有檔案數和函式數,當作分母。
然後每走完一條切片,把涉及的檔案和函式標記為「已入案」。整個流程跑完,每一個都必須是兩種狀態之一:
沒有第三種。 不能有「還沒看」的東西默默留在那裡。為什麼要這麼囉唆?因為沒有分母的話,「我分析完了」這句話沒有任何意義。它只是一種感覺。有了分母,它就變成一個可以被檢查的數字:目前入案 847 個函式,總共 862 個,還有 15 個沒著落,這 15 個是哪些。
這一段是我認為整個 Part 5 最反直覺的部分。
「每個檔案都被分派給某個人分析過」,不等於「每個危險的行為都被查過」。
一個檔案可以完整地入案了。某份報告盤點過它、寫進了結論、算進了涵蓋率。但從頭到尾,沒有任何人查過它的權限設定、沒有人查過它會不會把敏感資料寫進日誌、沒有人查過它的狀態機是不是漏了某個分支。
因為那些人的任務是「分析這個檔案在做什麼」,不是「檢查這個檔案的授權」。一句話:
危險的東西是行為性的,不是結構性的。
而結構涵蓋只量結構。
所以要另外立一份清單,用屬性提問而不是檔案清點的方式查:
| 維度 | 要檢查每一個⋯ |
|---|---|
| 授權面 | 對外端點 → 它的驗證授權是什麼?有沒有沒保護的? |
| 外部匯契約 | 外部呼叫 → 契約是什麼,以及誰可以呼叫它 |
| 狀態完整性 | 狀態機/分派 → 每個狀態都有分支嗎? |
| 資料曝露 | 把物件丟進日誌的地方 → 會不會洩漏個資或憑證? |
| 設定生效 | 承重的設定值 → 缺了會怎樣?設錯會怎樣? |
| 併發安全 | 共享狀態 → 初始化和存取有沒有競態? |
這些問題不會在「每個檔案有沒有人看」裡出現。 它們只會在「每個對外端點的授權我查了嗎」這種逐屬性提問裡出現。
而這剛好呼應 Day 30 講的:任何單一聚合指標都會騙你。 檔案涵蓋率就是一個聚合指標,而它丟掉的資訊,正是最危險的那一塊。
上面那張屬性清單能補「行為性」的缺口。但把整件事拉高一層看,會發現漏的東西還更多。
我後來用一道階梯來檢查自己走到哪裡了。它不是流程——不必照順序走,實務上高度交錯。而是一組必須被涵蓋的層次:
| 層 | 復原什麼 | 靠什麼 |
|---|---|---|
| ⑥ | 現代化——重寫或遷移 | 以下面五層為錨 |
| ⑤ | 理論——為什麼,以及跟真實世界怎麼對應 | 只能靠人 |
| ④ | 約束——欄位長度、Y/N、民國年這些隱性規則 | 實測 + 人 |
| ③ | 架構——模組邊界、資料流、接縫在哪 | 切片 + 觀點 |
| ② | 領域——這個系統的語言與概念 | 切片 + 觀點 |
| ① | 需求——它實際上替真實世界處理了什麼事務 | 切片 + 觀點 |
現在把前面那個涵蓋率記帳放進來對照,問題就很清楚了:
縱向切片 × 橫向觀點 —— 掃得到 ①②③
實測(Day 32 那些手法)—— 補得到 ④
而 ⑤ 只能靠人,掃不出來。
**所以「涵蓋率 862/862」量到的是 ①②③ 的完整度,它對 ④⑤ 一個字都沒說。**這就是「假的 100%」真正的形狀。不只是「行為性 vs 結構性」,是整整兩層根本不在那個分母裡。
而這道階梯最反直覺的一點是:
真正的技術工作(⑥)在最上層、也最後做。下面五級全是理論工作。
把預算和時程幾乎全砸在 ⑥、把 ①~⑤ 當成「開發過程中順便就懂了」的專案。那就是 Day 01 那個案子。它花了四個月,最後終於把 ①②③ 做出來了(那 149 份 Use Case),然後就沒有專案可以用它了。
(這道階梯也順帶回答了 Day 36 留下的那個問題:Naur 說「僅憑文件重建理論嚴格不可能」。他說的是 ⑤。而 ①②③ 可以逆向,④ 可以實測,只有 ⑤ 需要那個「與持有理論的人密切接觸」。分清楚這件事,才知道逆向工程到底能買到什麼、買不到什麼。)
明天用一篇講完五個地雷。



 iThome鐵人賽
 看影片追技術