
在下載模型到本機執行之前,要先確認它放不放得進記憶體。估算方式是把三個項目加起來,再跟這台電腦實際能分給模型的記憶體比較:
need = weights + KV cache + overhead
fits if need <= 0.8 × usable memory
以下的數字依照桌面應用程式 osFoundry 的本機模型瀏覽器所用的估算方式,並對照它在一台 16GB M3 MacBook 上顯示的數值。
權重的大小是參數數量乘上每個權重的位元組數,而每個權重的位元組數取決於量化方式:
| 量化 | 每個權重的位元組數 |
|---|---|
| FP16 / BF16 | 2.0 |
| Q8_0 | 1.0 |
| Q6_K | 0.82 |
| Q5_K_M | 0.69 |
| Q4_K_M | 0.56 |
| Q3_K_M | 0.44 |
| Q2_K | 0.31 |
Q4_K_M 是 0.56 而不是 0.5,因為 K-quant 會替每一小塊權重額外存一個縮放係數,換算下來每個權重大約 4.5 位元。
以 Q4_K_M 的 14B 模型來說:14 × 10⁹ × 0.56 = 7.84 × 10⁹ 位元組,大約 7.3 GiB。
如果看不懂量化名稱,就先當成 FP16。這是最保守的假設,不會把其實放不下的模型誤判成放得下。
生成的過程中,模型會為上下文裡的每個 token 保留 key 和 value。大小是:
2 × layers × kv_heads × head_dim × context_tokens × bytes_per_element
Qwen2.5 14B 有 48 層、8 個 KV head(使用 grouped-query attention),head 維度是 128。快取用 FP16 的話:
快取會隨上下文長度線性成長,所以在 4K 輕鬆放得下的模型,到了 32K 可能就放不下。沒有標明上下文長度的估算值參考價值不大;截圖裡的估算是以 4K 為前提。
llama.cpp 還需要運算緩衝區和暫存空間。粗略抓權重的 10% 再加上約 200 MB。14B 模型大約是 0.9 GB。
權重、快取和額外開銷加起來,Q4_K_M 的 14B 模型落在 8 到 9 GB 之間。應用程式顯示的是 8.4 GB。
這是最常算錯的地方。
接著比較:
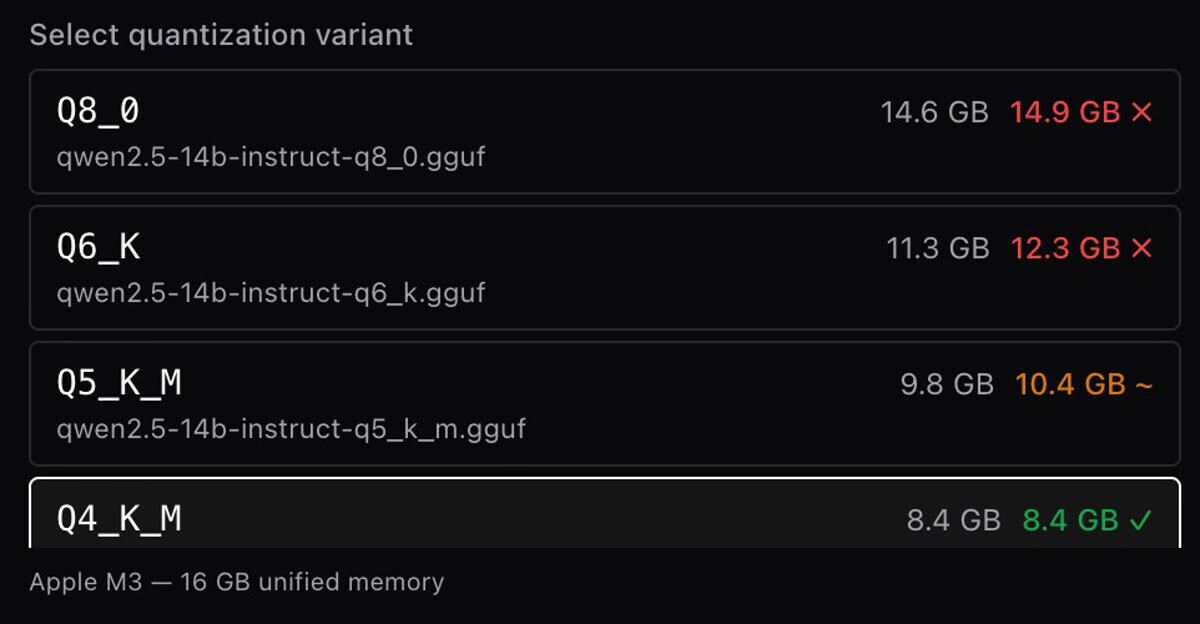
在這台 16GB Mac 上的結果:Q4_K_M 8.4 GB(70%,放得下)、Q5_K_M 10.4 GB(87%,很緊)、Q6_K 12.3 GB 和 Q8_0 14.9 GB(超過)。
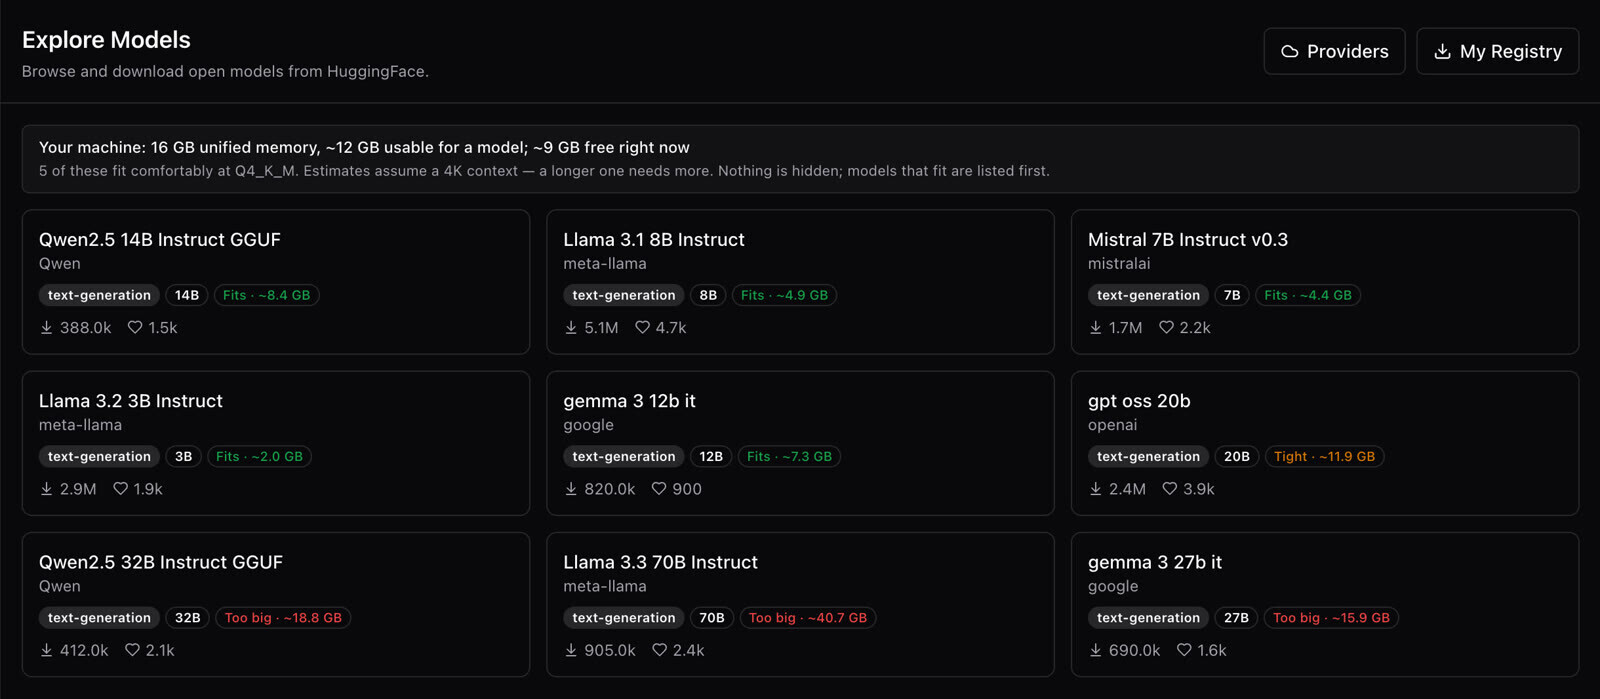
把各個模型都用 Q4_K_M 來算,這台電腦的分界點落在 20B(11.9 GB,很緊)和 27B(15.9 GB,太大)之間。
每生成一個 token,都要把所有權重從記憶體讀一遍,所以生成速度的上限大約是記憶體頻寬除以模型大小。基本款 M3 大約有 100 GB/s,所以 8.4 GB 的模型上限約每秒 12 個 token,4.9 GB 的 8B 模型大約 20 個。實際數字會比這低,但模型之間的比例大致不變。
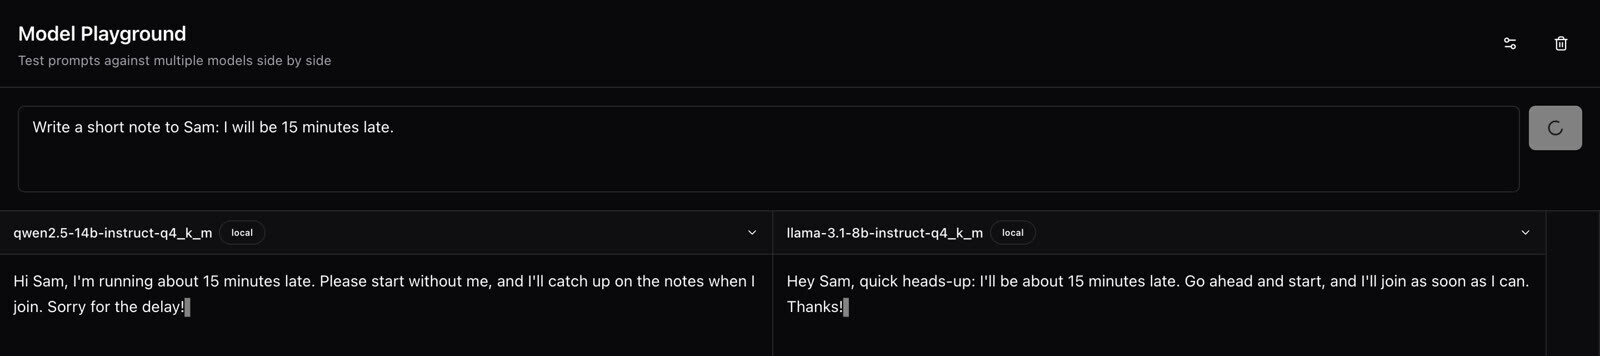
所以這個大小估算一次回答了兩個問題:模型載不載得進去,以及載入之後大概會跑多快。

 hana555

 iThome鐵人賽
 看影片追技術