
「LoRA 只訓練模型的 1% 左右」是最常見的一句話解釋。這沒有錯,但它把真正決定「能不能在你的電腦上跑、要跑多久」的部分都藏起來了:哪些層會加上 adapter、rank 怎麼影響參數量、凍結的權重用什麼精度、小資料集實際上能換到幾次 optimizer 更新。
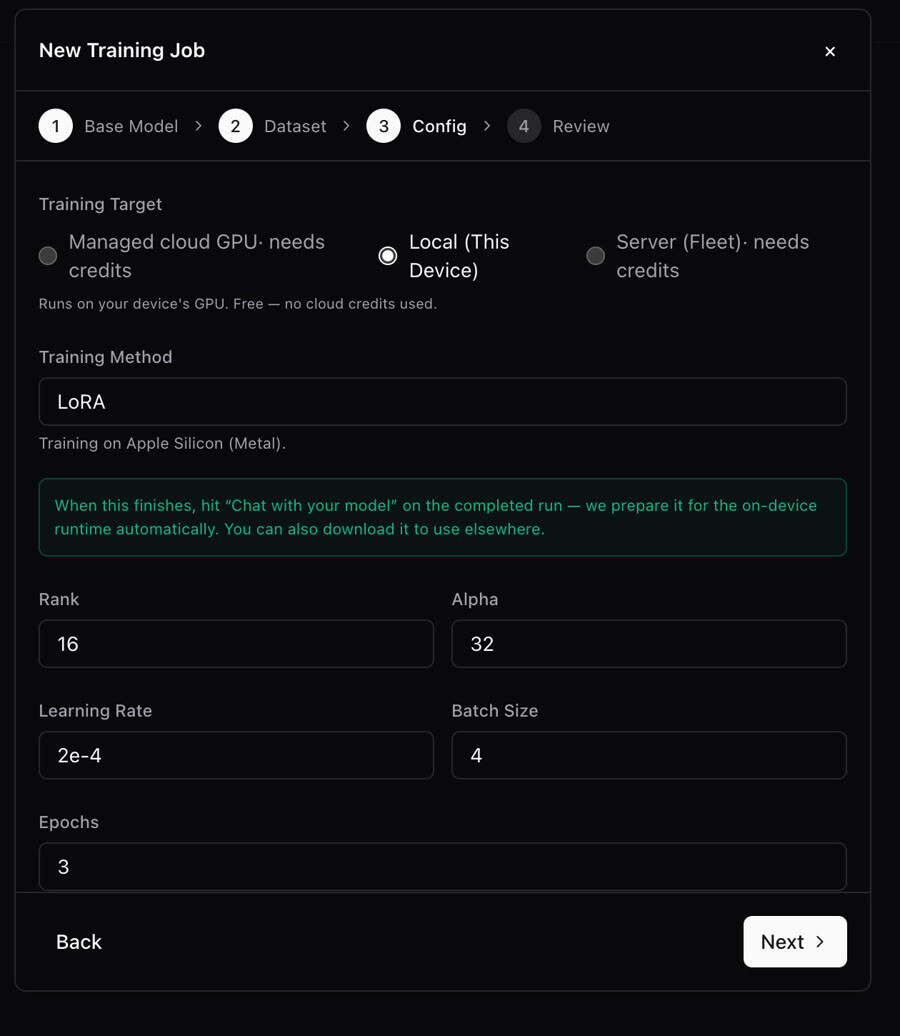
以下用一個具體的訓練來算這些數字:Qwen2.5-1.5B-Instruct、rank 16、在 16GB 的 Apple Silicon Mac 上。設定值是桌面應用程式 osFoundry 內建本機訓練器的預設值,它就是一支單純的 transformers + PEFT + TRL 腳本,所以這些計算也適用於其他類似的環境。(應用程式的 LoRA 微調頁面有周邊的介面畫面。)
對一個形狀為 d_out × d_in 的權重矩陣 W,LoRA 會凍結 W,改為學習兩個矩陣 A(r × d_in)和 B(d_out × r)。這一層的輸出變成 W·x + (α/r)·B·A·x。B 的初始值是零,所以訓練會從原本的基礎模型開始。
這一層可訓練的參數量是 r × (d_in + d_out)。它跟 rank 和這一層的寬度成線性關係,而不是跟這一層的面積成正比。
訓練器會在每個 transformer block 的全部七個線性投影上加 adapter:
target_modules=["q_proj", "k_proj", "v_proj", "o_proj",
                "gate_proj", "up_proj", "down_proj"]
Qwen2.5-1.5B 有 28 個 block、hidden size 1536、MLP size 8960,並使用 grouped-query attention,有 2 個 128 維的 KV head,所以 k 和 v 會投影到 256。在 r = 16 時,每個 block:
| 層 | d_in → d_out | 可訓練參數 |
|---|---|---|
| q_proj | 1536 → 1536 | 49,152 |
| k_proj | 1536 → 256 | 28,672 |
| v_proj | 1536 → 256 | 28,672 |
| o_proj | 1536 → 1536 | 49,152 |
| gate_proj | 1536 → 8960 | 167,936 |
| up_proj | 1536 → 8960 | 167,936 |
| down_proj | 8960 → 1536 | 167,936 |
每個 block 是 659,456,28 個 block 共 18,464,768:可訓練的 18.5M 對上總共 1.54B,也就是 1.2%。
有兩點值得注意。MLP 的投影佔了 adapter 權重的四分之三,所以如果把它們排除(有些舊的做法只對 q 和 v 加 adapter),參數量會降到約 2.2M,只剩八分之一的容量。另外因為 GQA 讓 k 和 v 變窄,它們的 adapter 很便宜。
在 Apple 的 GPU 上,訓練器用 float32 載入模型:
torch_dtype = torch.float16 if device == "cuda" else torch.float32
在 MPS 上用半精度很容易讓 loss 變成 NaN,所以在那裡用 32 位元比較保險。這樣凍結的基礎模型就是 1.54B × 4 位元組 ≈ 6.2 GB。
相比之下,可訓練的部分很小。18.5M 個 fp32 權重是 74 MB,梯度再 74 MB,AdamW 對每個權重保留兩個動量估計值,又是 148 MB。全部加起來約 0.3 GB。剩下的預算給 activation,它會隨 batch size 和序列長度變大(訓練器把序列上限設在 2048 個 token;簡短的聊天回覆遠低於這個值)。
16 GB 的 Mac 大約有 12 GB 可以給 GPU 使用,fp32 的 1.5B 還有餘裕。fp32 的 7B 基礎模型在開始訓練前就要約 30 GB,這就是為什麼在 Mac 上基礎模型要選小的,也是 QLoRA(4 位元的凍結權重)存在的原因。不過 bitsandbytes 的 4 位元路徑需要 NVIDIA GPU,所以在 Mac 上就是一般的 LoRA。
訓練器使用 batch size 4,加上 4 步的梯度累積,所以每次 optimizer 更新會看到 16 筆資料。200 組資料的話:
學習率 2e-4、線性衰減下的 39 次更新,足以改變語氣,但不足以教會新的知識。這跟大家實際看到的情況一致:兩百筆左右的回覆會改變模型的寫法,而不是它知道的東西。
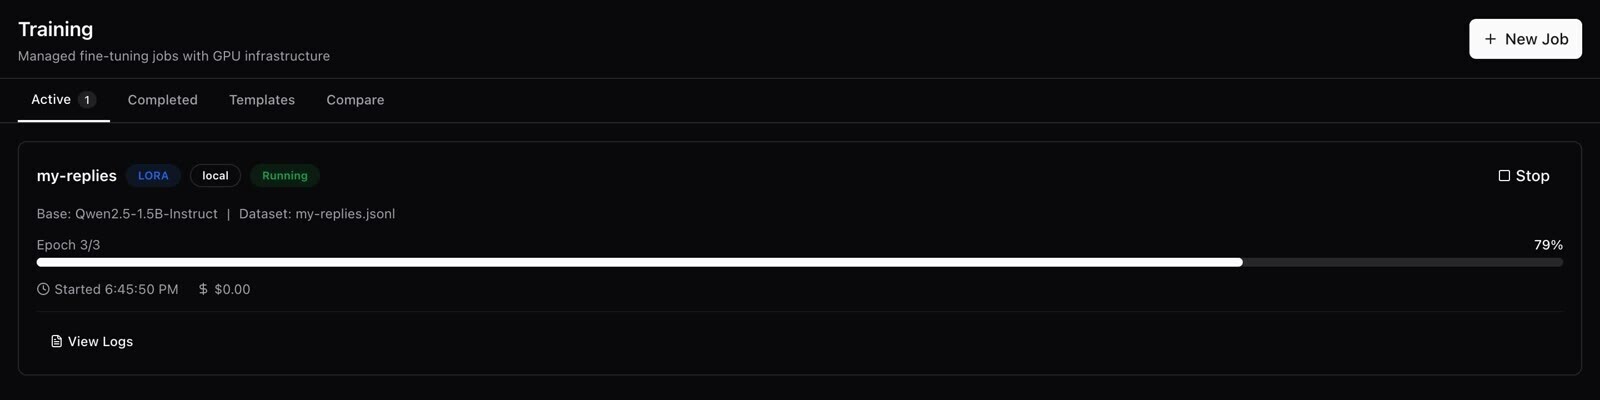
訓練結束後只會儲存 adapter:196 個加了 adapter 的層各自的 A 和 B,總共幾十 MB。推論時,應用程式會把它轉成 GGUF 格式的 LoRA 檔案,由 llama.cpp 套用在量化過的基礎模型上,這裡是 Q4_K_M 的 qwen2.5-1.5b-instruct。基礎模型是共用的,所以多個 adapter(每種語氣或任務各一個)每個只要幾十 MB。
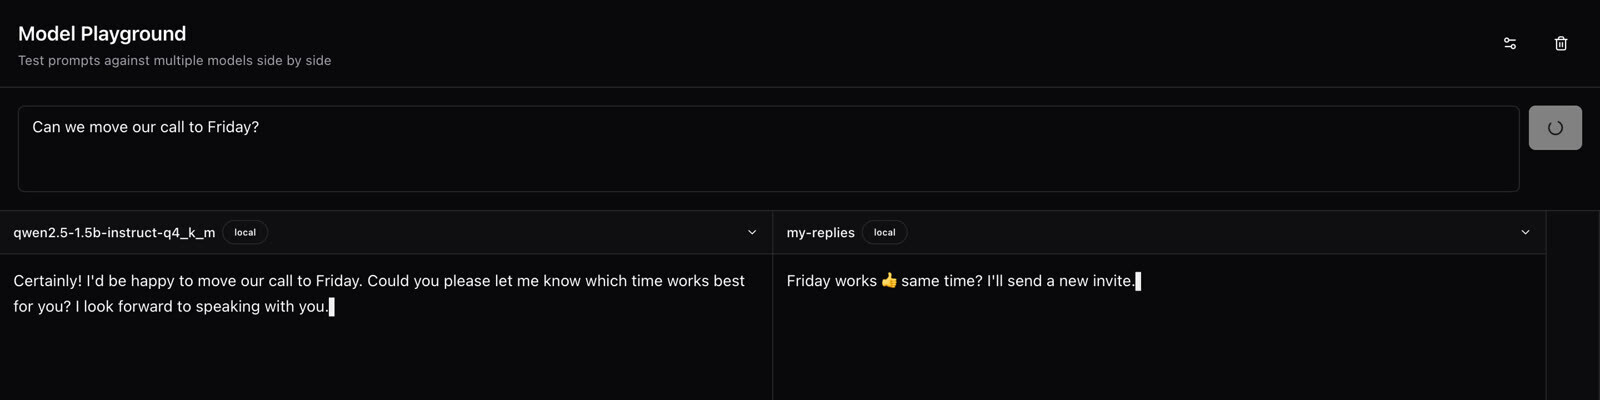
要注意精度不一致:adapter 是對著 fp32 的基礎權重訓練的,執行時卻是套在 4 位元的權重上。對小型的風格 adapter 來說,差異通常感覺不出來,但這也是合併後再重新量化的模型,和執行時才套用同一個 adapter,行為可能略有不同的原因之一。

 hana555

 iThome鐵人賽
 看影片追技術