
前情提要:在上一篇(#1)中,我們透過
deng-cell-audit的四階段白箱算子追蹤,證明了單細胞整數化(Integerization)雖然讓高達 82%~99% 的微弱浮點調整量歸零,但整體的 L2 訊號能量依然保留了 0.93 ~ 1.01。然而,當我們進一步把「逐靶點(Target-level)的整數化歸零率」與「模型預測誤差變化 ΔMSE」拉出來看時,卻在 Jurkat 細胞背景中看到了一個高達 ρ = 0.853 的強相關。這篇將分享我們如何忍住「立刻魔改取整算子」的衝動,利用 無母數秩殘差回歸(Rank-Residual Association) 找出幕後的共同驅動因子(Common Driver),完成一次拯救團隊時間的高品質「負結果(Negative Result)」診斷。
🔗 開源專案連結:silver131-dev/deng-cell-audit (DENG Cell Audit — by ARiN)
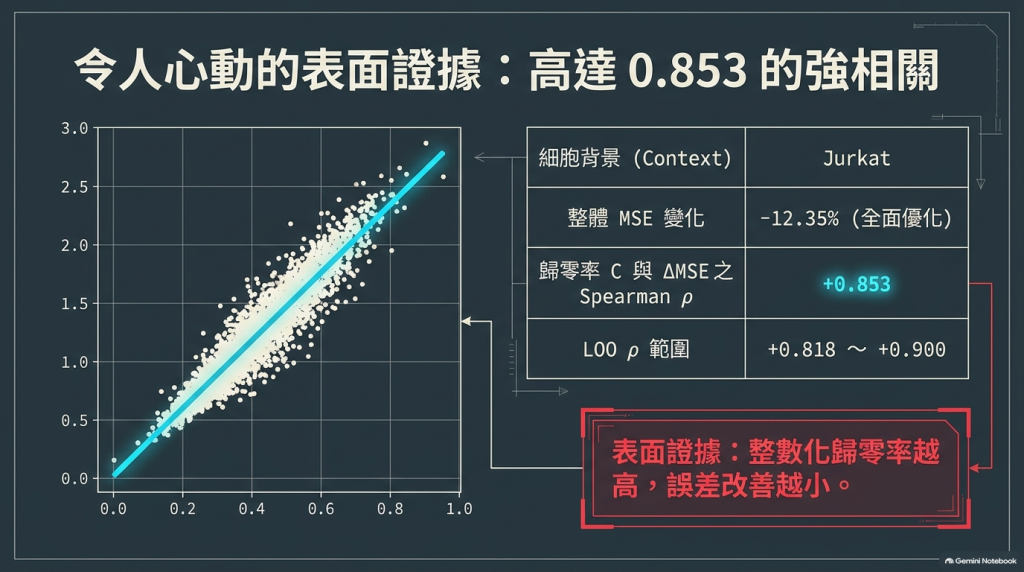
在比較效應縮放因子 α = 0.50 相對於 α = 0.25 的訓練集表現時(12 個固定靶點 × 2 種細胞背景 HepG2 與 Jurkat,共 24 個組合),我們首先觀察到一個好消息:全部 24 個靶點×背景組合的 ΔMSE 貢獻值皆為負數(代表在該訓練面板上,α = 0.50 的 MSE 全面優於 α = 0.25,整體 HepG2 改善 -4.87%、Jurkat 改善 -12.35%)。
但緊接著,一個核心問題浮上檯面:為什麼有些靶點的 MSE 改善幅度很大(ΔMSE 更負),有些靶點的改善幅度卻幾乎停滯(ΔMSE 接近 0)?
當我們將每個靶點在 α = 0.50 下的「區塊級整數化歸零率(C,C_integer_block_collapse_a050)」與「MSE 貢獻變化量(Y,Y_delta_MSE_contribution)」計算 Spearman 秩相關係數 ρ 時,得到了以下結果:
| 細胞背景 (Context) | 靶點數 (n) | 整體 MSE 變化 (α=0.50 vs 0.25) | 歸零率 C 與 ΔMSE (Y) 之 Spearman ρ | Leave-One-Target-Out (LOO) ρ 範圍 |
|---|---|---|---|---|
| HepG2 | 12 | -4.87% | +0.259 | +0.036 ~ +0.491 |
| Jurkat | 12 | -12.35% | +0.853 | +0.818 ~ +0.900 |
在 Jurkat 背景中,ρ = +0.853(即使經過 20 項比較的 Holm 多重檢定校正,置換參考 p 值仍達 0.0129),而且逐一移除任一靶點(Leave-One-Out),相關係數依然穩居 0.818 ~ 0.900!
因為 ΔMSE < 0 代表改善,所以正相關(+0.853)意味著:「整數化歸零率 C 越高的靶點,ΔMSE 越接近 0(改善幅度越小)。」
看到這張表,99% 的工程直覺會立刻跳出一個看似完美的因果故事:
「抓到了!在 Jurkat 背景中,整數化算子把太多微弱效應歸零了,所以限制了這些靶點的 MSE 改善幅度!我們應該立刻去改 rounding 規則、換成隨機取整(Stochastic Rounding),或是調整軟門檻(Soft Threshold)!」
但在啟動任何算子改動之前,我們的內部審查(Red Team Review)踩下了煞車,並提出了一個致命的質疑:「歸零率高的靶點,會不會只是因為它的『上游來源訊號強度(S)』本來就很弱?一個原本就沒什麼訊號的靶點,既容易在整數化時歸零,也自然無法從放大 α 中獲得 MSE 改善!」
為了檢驗這個替代解釋,我們在不讀取任何新測試集真值的前提下,針對同一個 12-target 面板建立了四個無洩漏的核心變量:
S_source_mean_abs):遮罩允許範圍內,未乘上 α 的來源效應(common + specific)平均絕對值——代表上游來源訊號的固有強度。E_R40_low_expression_fraction):目標背景控制組細胞(R40)中,平均正規化表達量(CP10K)低於基準地板值 0.25 的活躍基因比例——代表目標背景的低表達稀疏度。C_integer_block_collapse_a050):算子在 α = 0.50 下的整數化歸零率——代表下游算子的形態截斷程度。Y_delta_MSE_contribution):α = 0.50 相對於 α = 0.25 的單靶點 MSE 改善貢獻量——代表最終誤差結果。來源強度 S
↓
┌───┴────┐
↓ ↓
歸零率 C ΔMSE(Y)
控制組低表達 E
↓
Y
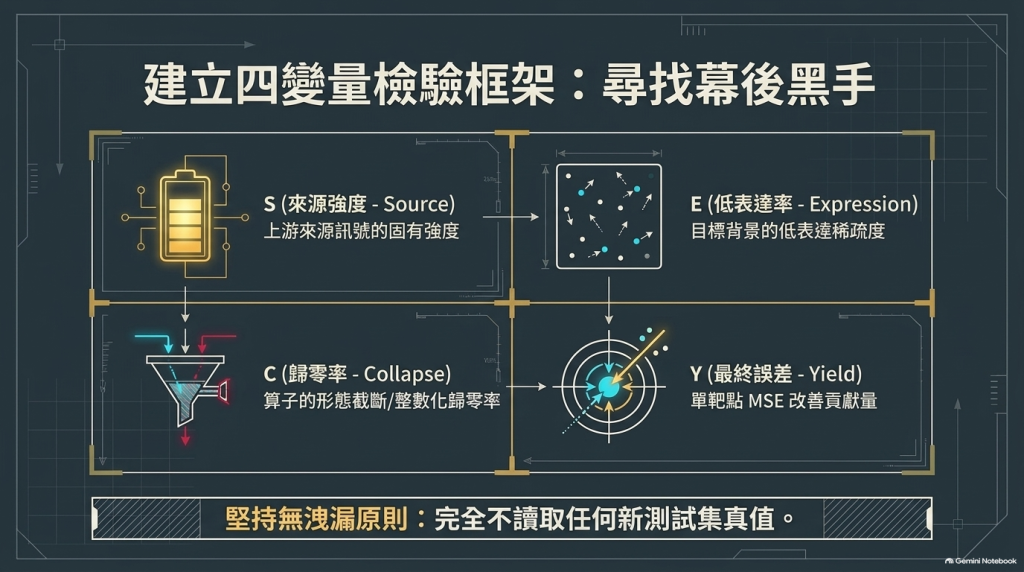
當我們把這四個變量的成對 Spearman 相關係數矩陣印出來時,真相瞬間浮現:
| 變量配對 (Variable Pair) | HepG2 Spearman ρ | Jurkat Spearman ρ | 結構意義解讀 |
|---|---|---|---|
| S(來源強度)vs C(歸零率) | -0.965 | -0.958 | 極端共線性:來源訊號越弱,整數化歸零率必然越高 |
| S(來源強度)vs Y(ΔMSE) | -0.168 | -0.818 | 在 Jurkat 中,來源越強的靶點,MSE 改善幅度越大 |
| E(低表達率)vs Y(ΔMSE) | -0.203 | -0.671 | 控制組稀疏度同樣與 Jurkat 的誤差變化高度共變 |
| C(歸零率)vs Y(ΔMSE) | +0.259 | +0.853 | 我們原本看到的「表面強相關」 |
請看第一列:來源強度 S 與歸零率 C 的 Spearman 相關在 HepG2 是 -0.965,在 Jurkat 是 -0.958!
這說明「整數化歸零率 C」在跨靶點的排序上,幾乎就是「來源強度 S 倒過來排」的影子指標。
association.py)為了嚴格量化「扣除掉 S 與 E 的共同變動後,C 與 Y 之間還剩下多少獨立關聯」,我們在 deng_cell_audit/association.py 中實作了無母數秩殘差相關(Rank-Residual Association):
D = [1, R(z₁), R(z₂), ...],以最小平方法求出 R(x) 與 R(y) 對 D 的線性投影殘差 e_x 與 e_y。e_x 與 e_y 的 Pearson 相關係數(當無共變數時,此數值在數學上完全等價於標準 Spearman ρ)。R(x) 與 R(y) 在扣除共變數後的剩餘秩變異比例(Remaining Rank Variance Fraction,RSS / TSS)。若設計矩陣秩虧(Rank-deficient)或剩餘變異趨近於零(≤ 10⁻¹²),強制回傳 defined: False 與 None,拒絕輸出虛假的數值。以下是 deng-cell-audit 中的完整實作程式碼:
"""Exploratory rank-residual association; no causal or predictive claim."""
import numpy as np
from .checks import require, vector


def average_ranks(values):
    x = vector(values, "rank data")
    order = np.argsort(x, kind="stable")
    ranks = np.empty(len(x), dtype=float)
    start = 0
    while start < len(x):
        stop = start + 1
        while stop < len(x) and x[order[stop]] == x[order[start]]:
            stop += 1
        ranks[order[start:stop]] = (start + stop + 1) / 2
        start = stop
    return ranks


def residual_rank_association(x, y, covariates=()):
    x, y = vector(x, "x"), vector(y, "y")
    require(x.shape == y.shape, "association axis mismatch")
    ranks = []
    for covariate in covariates:
        c = vector(covariate, "covariate")
        require(c.shape == x.shape, "covariate shape mismatch")
        ranks.append(average_ranks(c))
    rx, ry = average_ranks(x), average_ranks(y)
    design = np.column_stack([np.ones(len(x)), *ranks])
    response = np.column_stack([rx, ry])
    beta, _, rank, _ = np.linalg.lstsq(design, response, rcond=1e-12)
    residuals = response - design @ beta
    rss = np.sum(residuals**2, axis=0)
    tss = np.sum((response - response.mean(axis=0))**2, axis=0)
    defined = rank == design.shape[1] and len(x) > design.shape[1] + 1 and bool(np.all((tss > 0) & (rss > 1e-12 * tss)))
    coefficient = None
    if defined:
        a, b = residuals[:, 0], residuals[:, 1]
        a, b = a - a.mean(), b - b.mean()
        coefficient = float(np.clip(np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b)), -1, 1))
    return {"rank_residual_correlation": coefficient, "defined": bool(defined),
            "design_rank": int(rank), "design_columns": int(design.shape[1]),
            "residual_dimension": int(len(x) - rank),
            "x_rank_variance_fraction_remaining": float(rss[0] / tss[0]) if tss[0] > 0 else None,
            "y_rank_variance_fraction_remaining": float(rss[1] / tss[1]) if tss[1] > 0 else None}
將 12 個靶點的資料送入 residual_rank_association 逐步控制共變數後,我們得到了整輪研究最關鍵的一張診斷表:
| 調整模型 (Adjustment Spec) | HepG2 相關係數 | HepG2 C 剩餘秩變異 | Jurkat 相關係數 | Jurkat C 剩餘秩變異 | Jurkat LOO 範圍 |
|---|---|---|---|---|---|
| 1. 未調整 (Unadjusted Spearman) | +0.259 | 100.0% | +0.853 | 100.0% | +0.818 ~ +0.900 |
| 2. 僅調整低表達比例 (E) | +0.238 | 98.0% | +0.768 | 66.3% | +0.388 ~ +0.854 |
| 3. 僅調整來源強度 (S) | +0.375 | 6.9% | +0.420 | 8.2% | +0.241 ~ +0.583 |
| 4. 同時調整兩者 (S + E) | +0.481 | 5.9% | +0.238 | 6.6% | -0.009 ~ +0.459 |
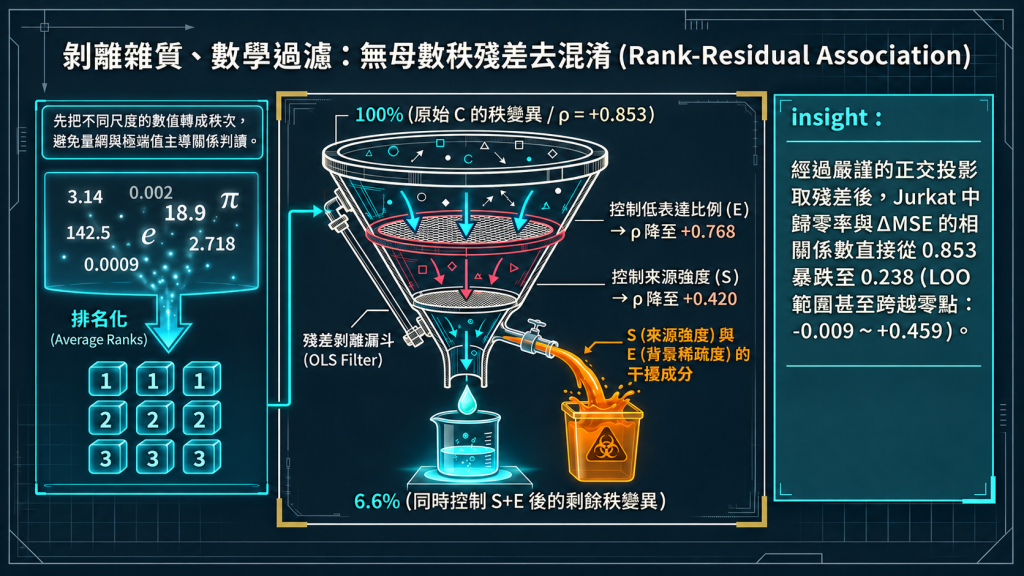
這組數據告訴我們三個極為重要的事實:
C_rank_variance_fraction_remaining)」這一欄——當控制了 S 與 E 後,歸零率 C 的排名變異在 HepG2 只剩下 5.9%,在 Jurkat 只剩下 6.6%(超過 93% 的排名變異都與上游的 S 重疊)。在工程與競賽的時間壓力下,「什麼都不改」往往比「隨便改點東西」需要更大的勇氣與更強的證據支撐。
透過這次的 Common Driver 去混淆分析,我們證明了:手頭並沒有任何實證證據支持「修改整數化算子或放寬軟門檻能改善預測」。 這幫團隊在最後衝刺階段果斷砍掉了:
相反地,我們的問題意識成功從下游的「算子失真」往上游推進了一層:既然來源效應強度 S 與下游行為高度綁定,那麼為什麼某些靶點的儲存效應 S 本來就特別弱?
當我們把目光轉向上游的來源效應庫(SourceBank),準備回答「弱 S 從何而來」以及「我們能不能為每個基因靶點算出一個可靠性分數(Reliability Score)」時,我們撞上了單細胞資料治理中最經典的陷阱:把「同一次實驗裡的幾百顆細胞」當成「獨立生物重複」!

 ARiN

 iThome鐵人賽
 看影片追技術