
前情提要:在上一篇(#2)中,我們透過無母數秩殘差回歸(Rank-Residual Association),成功將 Jurkat 背景中看似高達 ρ = 0.853 的「歸零率與預測誤差關聯」,拆解並修正為受上游來源強度 S 驅動的共變現象(控制後相關降至 0.238,剩餘秩變異僅剩 6.6%),避免了盲目修改取整算子的陷阱。
當我們把目光往上游推進,準備替每個基因靶點建立可靠性評分(Reliability Score)時,我們卻在數據結構中撞上了單細胞生醫 AI 最常犯的盲點:把「同一次實驗中的幾百顆細胞」當成「獨立生物重複(Biological Replicates)」。這篇將分享我們如何用 L1 向量代數分解打開來源黑盒,並建立一套誠實說出
MODEL_USE = HOLD的證據守門機制。
🔗 開源專案連結:silver131-dev/deng-cell-audit (DENG Cell Audit — by ARiN)
在前兩篇中,我們多次提到 S(Source Strength,來源效應強度)。在初步分析裡,S 表現得像是一個萬靈丹:它跟下游整數化歸零率高度共變(Spearman ρ ≈ -0.96),也能解釋大部分的誤差變化。
但身為 Red Team,我們的第一反應往往是:「當一個指標能解釋一切時,代表我們對它一無所知。」
如果 S 只是一個黑盒數值,我們就無法回答:
common 與 specific 座標互相抵銷了?抑或是被既有的 genomic mask 給硬生生遮罩掉了?為了徹底打開這個黑盒,我們在 deng_cell_audit/decomposition.py 中實作了一套基於 L1 範數的儲存向量代數分解(Stored-Vector Algebraic Decomposition)。
在已凍結的 SourceBank 中,每個靶點儲存的向量狀態是經歷過 cis 區域歸零與特定遮罩處理後的 post-specific-cis 儲存向量。令 c 為共用成分(Common vector)、s_t 為特定成分(Specific vector),其合成未遮罩向量為 u_t = c + s_t,而 M_k 為特定細胞背景(如 HepG2 或 Jurkat)的二元基因遮罩。
我們在同一基因軸上定義了四個純代數會計量(Accounting Metrics):
1. B_t(總絕對量,Total Absolute Mass):
   B_t = ‖c‖₁ + ‖s_t‖₁

2. C_t(代數抵銷量,Algebraic Cancellation):
   C_t = B_t - ‖u_t‖₁ = (‖c‖₁ + ‖s_t‖₁) - ‖c + s_t‖₁
   (代表正負訊號在相加合成 u_t 時,互相抵銷掉的 L1 質量)

3. E_mask,t,k(遮罩排除量,Mask Exclusion Mass):
   E_mask,t,k = ‖u_t‖₁ - ‖M_k · u_t‖₁
   (代表既有背景遮罩 M_k 過濾掉的絕對量)

4. S_t,k(背景別儲存效應強度):
   S_t,k = (B_t - C_t - E_mask,t,k) / D_k = ‖M_k · u_t‖₁ / D_k
   (其中 D_k 為背景專屬分母:HepG2 為 6,730,Jurkat 為 6,635)
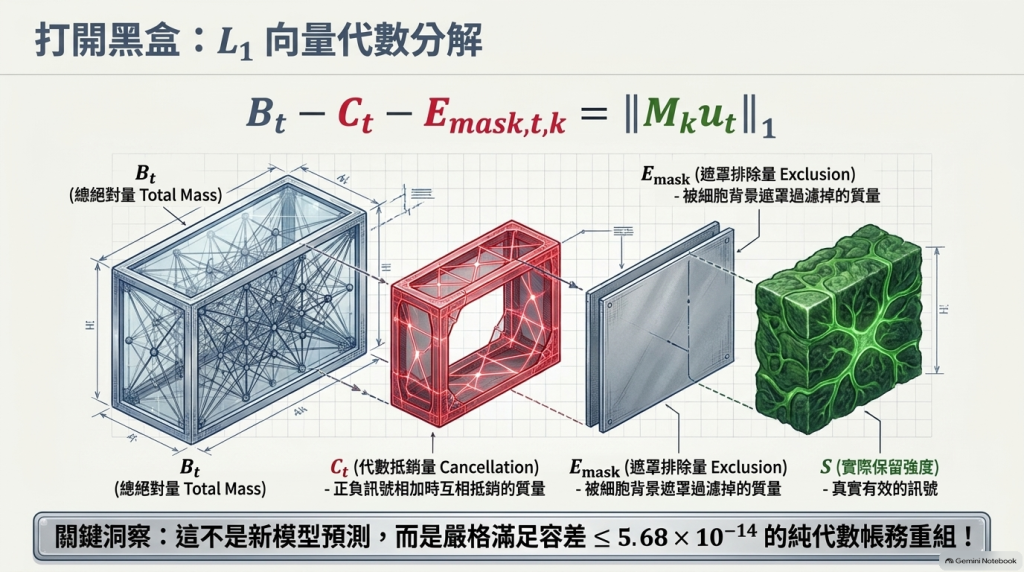
為了確保這套分解只是對既有資料的「重新表述(Reformulation)」,而不是偷偷創造新公式,我們在 decomposition.py 與測試套件中加入了雙重斷言:
B_t - C_t - E_mask,t,k = ‖M_k · u_t‖₁(實際最大絕對誤差僅 5.68 × 10⁻¹⁴,遠小於容差 10⁻¹²)。S_t,k 必須與 Phase 1 原始封存值完全一致(最大絕對誤差為 0.0)。以下是 deng-cell-audit 中的核心代數分解實作:
"""L1 partition of supplied stored vectors. Not a reliability estimator."""
import numpy as np
from .checks import require, vector


def decompose(common, specific, mask):
    c, s = vector(common, "common"), vector(specific, "specific")
    m = np.asarray(mask)
    require(c.shape == s.shape == m.shape and m.dtype == np.dtype(bool), "shape or boolean mask mismatch")
    u = c + s
    with np.errstate(over="ignore", invalid="ignore"):
        common_l1, specific_l1 = float(np.abs(c).sum()), float(np.abs(s).sum())
        b = common_l1 + specific_l1
        cancellation = float((np.abs(c) + np.abs(s) - np.abs(u)).sum())
        excluded, kept = float(np.abs(u[~m]).sum()), float(np.abs(u[m]).sum())
    require(np.isfinite([b, cancellation, excluded, kept]).all(), "decomposition overflow")
    return {"common_L1": common_l1, "specific_post_cis_L1": specific_l1,
            "B_total_L1": b, "C_cancel_L1": cancellation,
            "u_sum_L1": float(np.abs(u).sum()), "E_mask_L1": excluded, "Mu_kept_L1": kept,
            "C_over_B": cancellation / b if b > 0 else None,
            "E_mask_over_B": excluded / b if b > 0 else None,
            "kept_over_B": kept / b if b > 0 else None,
            "ratio_status": "DEFINED" if b > 0 else "UNDEFINED_B_ZERO"}
將 12 個訓練靶點帶入上述代數模型後(共 24 列組合),我們得到了各個成分佔總量 B_t 的實際比例分佈:
| 靶點目標 (Target) | 總絕對量 B_t | 代數抵銷比例 C_t / B_t | 遮罩排除比例 E_mask / B_t (HepG2 / Jurkat) | 實際保留比例 K / B_t (HepG2 / Jurkat) | 最終 S_t,k (HepG2 / Jurkat) |
|---|---|---|---|---|---|
| CPSF6 | 738.46 | 5.96% | 12.71% / 13.33% | 81.33% / 80.71% | 0.0892 / 0.0898 |
| EXOSC4 | 661.29 | 5.57% | 13.32% / 13.77% | 81.11% / 80.66% | 0.0797 / 0.0804 |
| RPAP1 | 585.21 | 8.53% | 10.89% / 12.08% | 80.58% / 79.39% | 0.0701 / 0.0700 |
| LSM4 | 574.99 | 11.98% | 10.28% / 11.36% | 77.74% / 76.66% | 0.0664 / 0.0664 |
| MED20 | 528.90 | 7.98% | 12.17% / 13.45% | 79.85% / 78.56% | 0.0628 / 0.0626 |
| CSTF3 | 528.38 | 11.59% | 11.06% / 12.01% | 77.35% / 76.40% | 0.0607 / 0.0608 |
| EBNA1BP2 | 485.73 | 11.36% | 10.99% / 12.12% | 77.65% / 76.52% | 0.0560 / 0.0560 |
| GNL2 | 472.70 | 9.70% | 10.80% / 12.00% | 79.49% / 78.30% | 0.0558 / 0.0558 |
| MPHOSPH6 | 420.11 | 15.68% | 10.53% / 11.44% | 73.79% / 72.88% | 0.0461 / 0.0461 |
| NOP9 | 363.96 | 25.05% | 9.12% / 9.96% | 65.83% / 64.99% | 0.0356 / 0.0357 |
| USP14 | 346.43 | 21.94% | 10.98% / 11.66% | 67.08% / 66.41% | 0.0345 / 0.0347 |
| NUP107 | 343.68 | 19.96% | 10.70% / 11.94% | 69.33% / 68.09% | 0.0354 / 0.0353 |
從上表我們能看出非常清楚的數學組成差異:
NOP9、USP14、NUP107),同時呈現較小的總絕對量 B_t(343.68 ~ 363.96)以及較高的代數抵銷比例 C_t / B_t(高達 19.96% ~ 25.05%);CPSF6、EXOSC4)的代數抵銷比例僅有約 5.57% ~ 5.96%。但我們必須再次啟動 Red Team 的紅線警告:這些比例全部都只是數學帳務上的「描述性組成(Descriptive Accounting)」,絕對不能直接跳躍推論為生物學解釋!
NOP9 的 S 低是因為它具有嚴重的生物學拮抗作用(Biological Antagonism)。」B_t 與較高的 common / specific 代數抵銷比例 C_t / B_t。」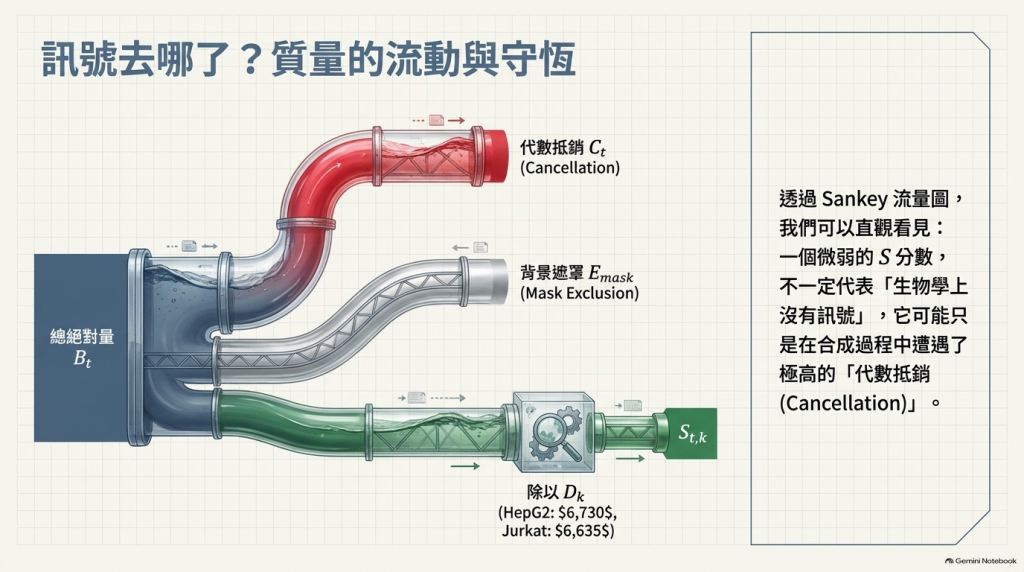
當我們把目光從代數分解轉向「來源可靠性(Source Reliability)」時,我們對 SourceBank 進行了系統性的資料可行性盤點(Feasibility Checklist,涵蓋 C01 至 C24 共 24 項檢核),結果發現了一個關鍵的工程事實:
在現有的 1,213 個唯一靶點中,1,160 個靶點只有 1 列聚合資料,其餘 53 個非 TRAIN 靶點也僅有 2 列;而 12 個 TRAIN 靶點全部都只有「單一聚合列(Single Aggregate Row)」。
這在生物資訊工程中代表什麼?
這代表我們完全缺乏足以評估「跨 guide 一致性」或「跨生物重複(Biological Replicates)」的底層獨立分組資料。
多數人在面對這種情況時,往往會鋌而走險——把同一次實驗中幾百顆單細胞(Cells)透過 Bootstrap 或切分子樣本(Sub-sampling),算出一組信賴區間或標準差,然後包裝成「具有統計顯著性的生物重複可靠性評分」(這在統計學上稱為 Pseudoreplication,偽重複)。
但在我們的 deng-cell-audit 架構中(如 evidence.py 與治理台帳),我們選擇了最誠實的做法:拒絕偽造獨立性。
如果資料中沒有真正的獨立生物重複與可追溯的實驗批次分層,系統就會在 reliability_tier 欄位強制標記為 Missing,並在策略簽核台帳中將 model_use 鎖定在 HOLD 狀態。
透過 DENG v03 Phase 1 與 Phase 2A 的洗禮,我們確立了一套適用於所有生醫 AI 專案的 MLOps 鐵律:
HOLD,也絕不為了好看的圖表用細胞抽樣偽造生物重複。在下一篇, 我們將帶大家看看如何把這套研究級專案打包成一個「零外部資料依賴、3 秒跑完 49 項測試、具備密碼學發布防禦」的無塵室開源 Python 套件!

 ARiN

 iThome鐵人賽
 看影片追技術