
前情提要:在前三篇中,我們完整復盤了單細胞基因擾動預測背後的三大白箱審計技術:
#1 「四階段計數算子」:證明整數化造成 90% 位置歸零的同時,仍保留了 0.93 ~ 1.01 的 L2 總訊號能量。#2 「秩殘差去混淆」:找出上游來源強度 S 與控制組表達 E 的共同驅動效應,拆穿 Jurkat 背景中 ρ = 0.853 → 0.238 的假性強相關。
#3 「L1 向量代數分解與證據守門」:以
B = C_cancel + E_mask + K打開來源黑盒,並在缺乏獨立生物重複時強制鎖定MODEL_USE = HOLD。>這篇要解決生醫 AI 與資料科學團隊在賽後開源時最頭痛的工程難題:當官方競賽資料與醫院臨床數據受限於嚴格的「禁止重散布條款(No Redistribution)」,我們如何在「不公開任何一筆真實生物數據」的前提下,把研究程式碼打包成全世界都能在 3 秒內一鍵重播驗證的開源套件?
🔗 開源專案連結:silver131-dev/deng-cell-audit (DENG Cell Audit — by ARiN)
在大多數的生物資訊研究或資料科學挑戰賽中,官方提供的單細胞轉錄組數據(.h5ad)動輒數十 GB,且使用條款(Terms of Use)通常明確規定:參賽者即使下載了資料,也不得將原始數據或未經審查的衍生統計表重新上傳、散布至公開平台。
這導致許多研究型 GitHub 倉庫淪為「死庫(Dead Repo)」:
/home/user/data/official_train.h5ad)的腳本;FileNotFoundError;git add . 時不小心把實驗過程的 .npz、.xlsx、甚至含有私人 Token 或未公開數據的 log 一起推上 GitHub,直接踩中合規地雷。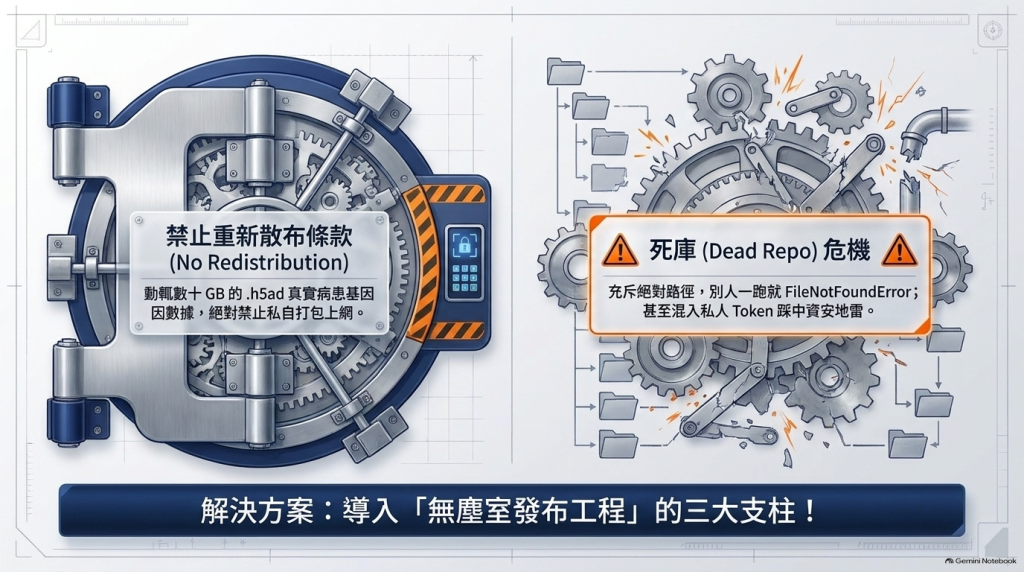
為了徹底根除這些問題,我們在設計 deng-cell-audit(v0.1.0-rc3)時,導入了「無塵室發布工程(Clean-Room Release Engineering)」,核心由三大支柱組成:
h5ad.py & replay.py)
demo.py)
verify_release.py & build_release.py)
單細胞的 AnnData(.h5ad)底層是 HDF5 格式,矩陣 X 可能是稠密矩陣(Dense)或壓縮稀疏列矩陣(CSR,indptr / indices / data)。若在擁有 18,533 個基因、數十萬顆細胞的規模下直接呼叫 X[:] 轉成 float64,瞬間就會吃掉數十 GB 記憶體並觸發 OOM(Out Of Memory,記憶體耗盡)。
在 deng_cell_audit/h5ad.py 與 ntc.py 中,我們實作了嚴格的 CountAccumulator(固定 256 列分塊累加器):
256 × 18,533 的 float64 區塊僅佔約 36.2 MiB 記憶體。L_i 並乘上 10,000,再跨細胞取平均」,絕不與「先加總再相除(Pooled normalization)」混淆。indptr 單調遞增、欄位索引不越界、且每一列內的非零索引嚴格遞增無重複(拒絕損壞的稀疏矩陣或未預期的 CSC 格式)。class CountAccumulator:
def __init__(self, n_genes):
require(isinstance(n_genes, int) and 0 < n_genes <= 1_000_000, "invalid gene count")
self.n_genes = n_genes
self.raw_sum = np.zeros(n_genes, dtype=np.int64)
self.detected = np.zeros(n_genes, dtype=np.int64)
self.cp10k_sum = np.zeros(n_genes, dtype=np.float64)
self.n = 0
self.total_umis = 0
self.min_library = None
self.max_library = None
def add(self, block):
a = counts(block)
require(a.shape[1] == self.n_genes and a.shape[0] <= CHUNK_ROWS, "block shape or chunk limit")
library = a.sum(axis=1, dtype=np.int64)
require(np.all(library > 0), "zero-library cell")
addition = a.sum(axis=0, dtype=np.int64)
require(np.all(self.raw_sum <= np.iinfo(np.int64).max - addition), "gene sum overflow")
self.raw_sum += addition
self.detected += np.count_nonzero(a, axis=0)
normalized = a.astype(np.float64)
normalized *= 10000.0
normalized /= library[:, None]
self.cp10k_sum += normalized.sum(axis=0, dtype=np.float64)
self.n += len(a)
self.total_umis += int(library.sum(dtype=np.int64))
此外,replay.py 強制要求使用者提供一份 JSON 資料契約(DENG_NTC_CONTRACT_V1),在掃描 H5AD 之前與之後各算一次檔案的 SHA-256(防止掃描中途檔案被改動 Time-of-check to time-of-use),同時核對細胞順序雜湊(obs_ids_sha256)與 Guide 平衡數。只要有一項不符,程式立刻中止並在 receipt.json 寫入 FAILED,絕不產出半成品的 CSV。
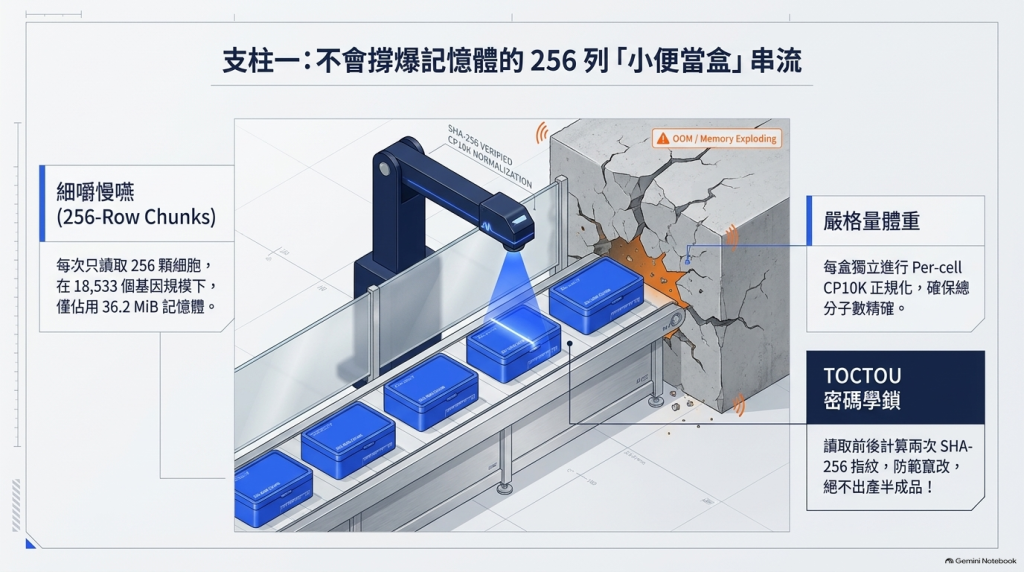
※TOCTOU(Time of Check To Time of Use,檢查與使用之間的檔案竄改風險)
為了讓任何下載 deng-cell-audit 的工程師不需要申請帳號、不需要下載數十 GB 的真實數據,就能完整體驗並驗證整個管線,我們在 demo.py 中用純程式碼動態生成微型合成資料:
完全人工合成:包含 2 個虛擬背景(SYN_A 使用 Dense 編碼、SYN_B 使用 CSR 稀疏編碼)、各 4 顆虛擬細胞(SYN_CELL_0000~0003)、5 個虛擬基因(SYN_G001~0005)與 3 個面板基因。
端到端一次走完:當你執行 python -m deng_cell_audit demo --out results/demo,它會在本地動態寫入這兩個微型 .h5ad 與 contract.json,接著依序跑完:
fingerprint.csv 與 6 列 panel_context.csv);B = 10, C_cancel = 6, E_mask = 3, K = 1);validate_evidence)。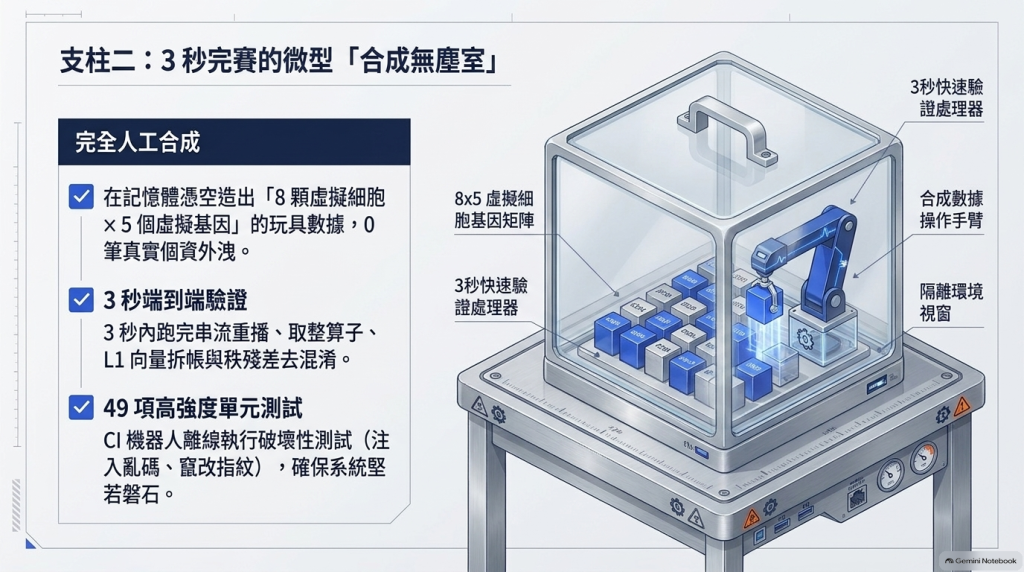
這讓我們的 GitHub Actions CI(同時測試 Python 3.12 與 3.13)可以在完全離線、零外部資料依賴的環境下,幾秒內跑完 49 項高強度單元測試(包含刻意注入 NaN、負數、溢位、順序錯亂、損壞的 CSR 指標與竄改 SHA-256 等破壞性測試)。
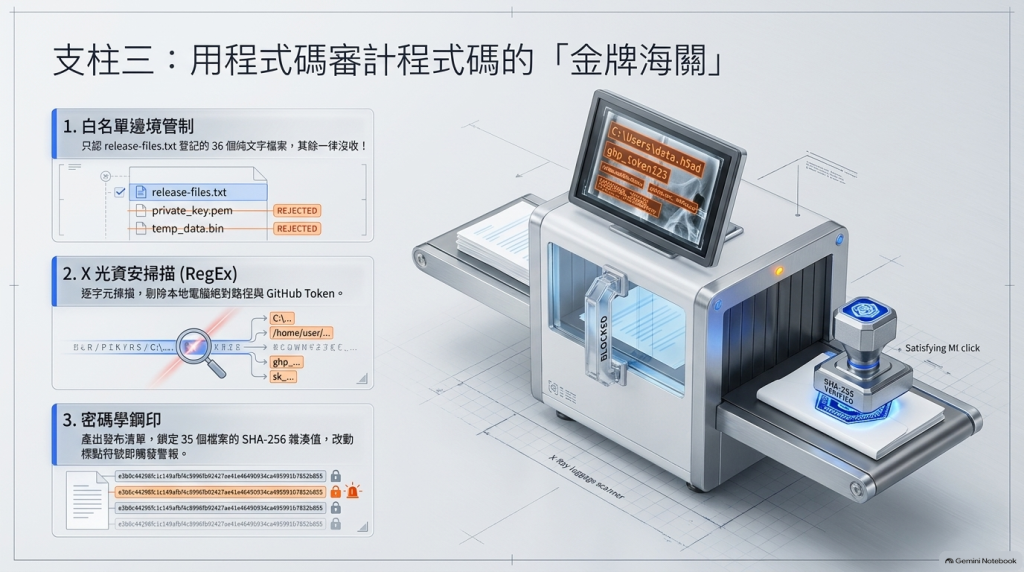
verify_release.py)在將專案推上 GitHub 之前,我們要如何 100% 確定壓縮包裡沒有夾帶任何一筆研究資料或個人隱私路徑?
我們不依賴人工肉眼檢查,而是寫了 tools/verify_release.py 與 tools/build_release.py,建立三道自動化閘門:
打包工具絕不遞迴複製工作目錄,而是只讀取 release-files.txt 中明確列出的 36 個純文字檔案,並強制拒絕任何非文字檔或資料檔副檔名(如 .h5ad、.npz、.xlsx、.vcc)以及任何符號連結(Symlinks)或路徑穿越(..)。
每一個入選檔案的位元組都會經過 inspect_text() 的掃描,只要匹配到以下任一模式,打包立刻失敗:
PATTERNS = {
    "private_account_link": r"chatgpt[.]com/(?:library|space)",
    "private_file_id": r"libfile_[a-z0-9]{16,}",
    "personal_absolute_path": r"/(?:home|Users|workspace)/[^\s\"']+|[A-Za-z]:[\\/](?:Users|Documents)[\\/]",
    "access_token": r"gh[pousr]_[A-Za-z0-9]{30,}|github_pat_[A-Za-z0-9_]{30,}",
    "private_key": r"-----BEGIN (?:RSA |EC |OPENSSH )?PRIVATE KEY-----",
    "email_address": r"[A-Za-z0-9._%+-]+@[A-Za-z0-9.-]+\.[A-Za-z]{2,}",
    "embedded_payload": r"[A-Za-z0-9+/]{300,}={0,2}",
}
這套規則確保了專案中不會殘留任何開發機器的 /home/... 絕對路徑、GitHub Personal Access Token、Email,或是把二進位資料偷轉成 Base64 長字串塞在程式碼裡。同時,所有 .py 檔案都必須通過 ast.parse() 語法樹檢查。
release_manifest.json)最後,其餘 35 個檔案的位元組長度與 SHA-256 雜湊值,連同 pyproject.toml 中的版本號(0.1.0rc3)與授權標記(MIT),全部寫入 release_manifest.json 並納為第 49 項單元測試。只要任何人在審閱後偷改了 README.md 的一個字元或抽換了 LICENSE,verify_release.py 與 CI 就會立刻攔截報錯!
回顧前四篇文章,我們從最初面對單細胞基因擾動挑戰賽的高維度計數矩陣,一路走到了最終開源釋出 deng-cell-audit:
| 階段 | 傳統刷分思維 (Score-Chasing) | DENG 白箱審計思維 (White-Box Auditing) | 對應開源模組 |
|---|---|---|---|
| 算子轉換 | 把浮點數直接 np.round(),忽略 UMI 漂移與零值膨脹 |
強制零支援集鎖定、Active-Pool UMI 守恆,分離位置歸零率與 L2 能量 | operator.py |
| 相關性分析 | 看到 ρ = 0.853 就宣布找到瓶頸,立刻魔改取整參數 | 引入上游 S 與 E 做秩殘差回歸,揭露 -0.958 共線性與 6.6% 剩餘變異 | association.py |
| 來源評估 | 把 S 當成品質分數,用單次實驗的細胞 Bootstrap 偽造顯著性 | L1 嚴格代數分解(B = C + E + K),無獨立生物重複一律鎖定 HOLD |
decomposition.py, evidence.py |
| 專案開源 | 丟出充滿本地路徑的 Notebook,或誤傳受限比賽資料 | 256-row 串流契約 + 8×5 合成無塵室 Demo + 36 檔 SHA-256 白名單防禦 | h5ad.py, replay.py, verify_release.py |
在最後一篇中,我們將結合賽後社群大復盤、63-Target 外部盲測(E150)的六指標拉鋸戰數據(解答為什麼大型 Foundation Model 容易在未知細胞背景中輸給簡單的 Baseline)。

 ARiN

 iThome鐵人賽
 看影片追技術