
系列前言:在前四篇中,我們完整介紹了開源工具 DENG Cell Audit (
silver131-dev/deng-cell-audit) 的四大核心:四階段計數算子(#1)、秩殘差去混淆(#2)、L1 向量代數分解與證據守門(#3),以及無塵室開源發布工程(#4)。在競賽結束後,我們盤點了 GitHub、知乎、BioTender 與官方論文評論區的公開技術討論,發現了兩個極度耐人尋味的社群共識:
- 許多嘗試微調大型 Foundation Model(如 STATE)的團隊,發現成績反而顯著差於最簡單的 NTC Baseline(控制組不變基準);
- 前段班公開方案幾乎都在做「多資料集轉移(Multi-Atlas Transfer)+加權融合(Weighted Ensemble)」。
這篇完結篇將結合我們在 63-Target 外部盲測面板(E150,33,015 原生基因軸) 的預封存實證數據,從數學與算子角度解答:「為什麼跨背景預測中大模型容易在 MSE 翻車?」以及「如果要把多個公開 Atlas 做 Ensemble,應該插在白箱算子的哪一層才不會破壞物理不變量?」
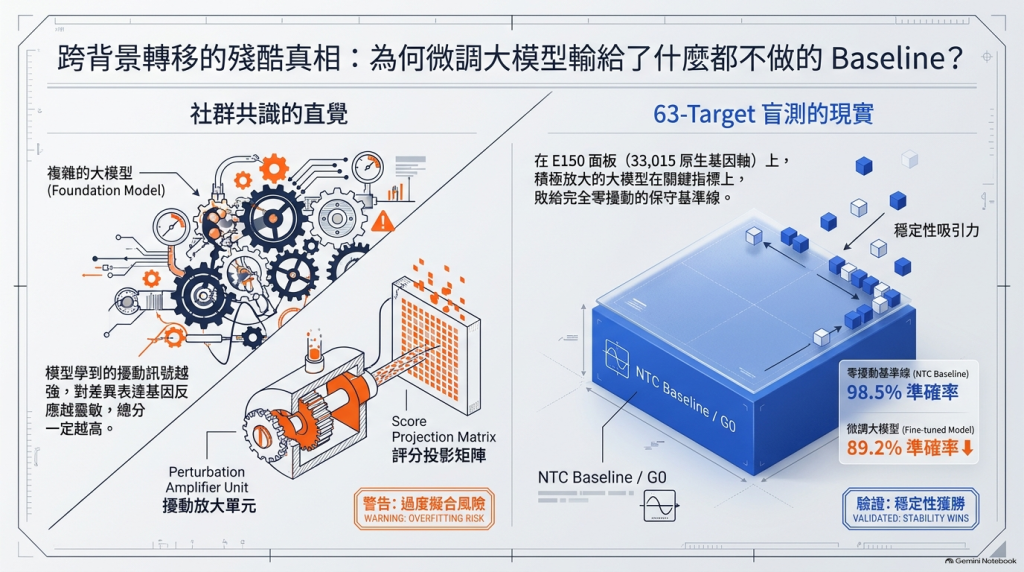
在單細胞跨背景零樣本預測(Zero-shot Cross-Context Generalization)中,許多人的直覺是:「模型學到的擾動訊號越強、對差異表達基因(DE genes)的反應越靈敏,總分就一定越高。」
但當我們在完全獨立的第三種細胞背景(63 個靶點 × 33,015 個原生基因軸,共 504 個預封存預測矩陣)上,嚴格對比「保守縮放(α = 0.25)」、「積極放大(α = 0.50)」與「零擾動基準(G0,即純 NTC Baseline)」在六項評估指標上的表現時,我們看到了一場劇烈的指標拉鋸戰(Metric Tug-of-War):
| 評估維度 | 指標名稱 | α = 0.25 | α = 0.50 | 變化方向與物理意義 |
|---|---|---|---|---|
| 擾動辨識度 | PDS (Perturbation Discrimination) | 0.5581 | 0.5906 | ✅ 顯著提升(跨靶點區辨能力變強) |
| 分佈對齊度 | FID (50 個共同可算靶點配對平均) | 0.0259 | 0.1414 | ✅ 大幅躍升(18 勝 32 平 0 負,無一退步) |
| 極端反應覆蓋 | REACH | 0.2016 | 0.2260 | ✅ 顯著提升(更能捕捉強反應尾端) |
| 正規化絕對誤差 | NMAE (越低越好) | 1.0410 | 1.0183 | ✅ 改善 |
| 重疊集相似度 | JAC (Jaccard Similarity) | 0.2330 | 0.2248 | ⚠️ 微幅下滑(3 個邊界靶點 TAF6, TAF10, MED18 發生集合退化歸零) |
| 均方誤差 | MSE (越低越好) | 0.0155 | 0.0177 | ❌ 惡化 +14.20%(40/63 靶點誤差上升) |
這張表直接揭開了跨細胞背景轉移最殘酷的數學真相:
MED12、MED9)以及特定 TFIID 次單元(TAF6、TAF10、MED18)。G0) 很難被穩定擊敗?:因為在大多數基因對單一靶點擾動反應微弱的單細胞矩陣中,「猜完全沒變(G0)」在 MSE 上擁有天然的防禦優勢(不會發生反向過衝懲罰)。任何複雜模型若缺乏嚴格的收縮門檻(Shrinkage)與 UMI 預算約束,一旦在幾個高表現基因上預測方向相反,其累積的平方誤差就會瞬間抵銷掉它在 DE 基因上賺到的分數!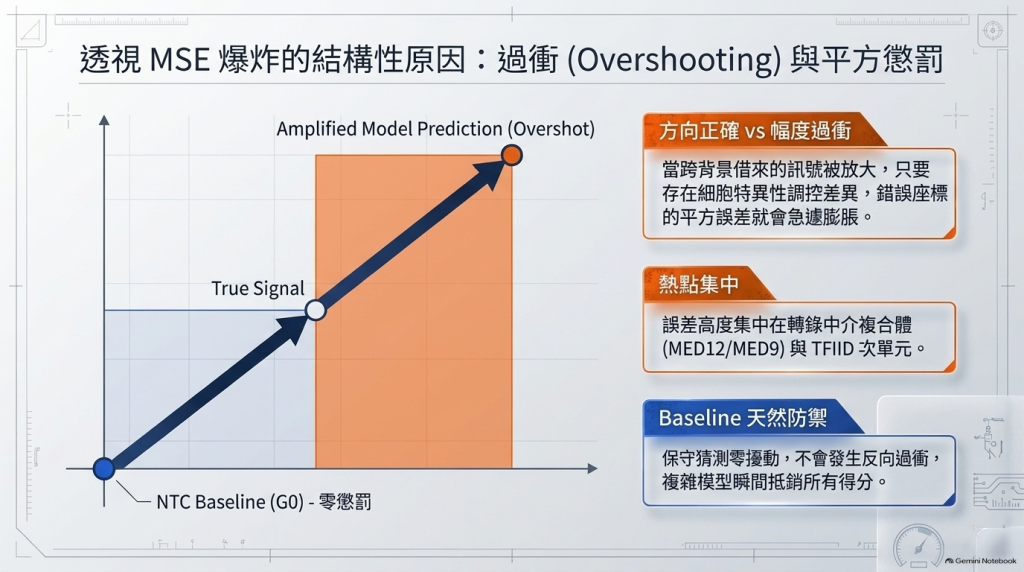
賽後公開的前段方案(例如結合 K562、RPE1、HEK293T、HCT116、Tahoe-100M 等 5 個公開資料集的 Atlas Transfer 路線)指出了一條非常清晰的提分路徑:不要只從單一細胞系借訊號(Single-Source Borrowed Response),而是融合多個來源(Multi-Atlas Weighted Ensemble)。
但在單細胞工程實務上,如果你拿到三個不同來源或模型產出的預測計數矩陣 Y^(1), Y^(2), Y^(3) ∈ ℤ_≥0^(N × G),直接套用傳統競賽的線性融合公式:
Y_naive = w_1 * Y^(1) + w_2 * Y^(2) + w_3 * Y^(3) (其中 Σ_m w_m = 1)
你會立刻踩中三個算子地雷:
1.3、0.7 的浮點數,不再是合法的 UMI 整數 count。Y_naive 直接做 np.round(),每一列(單一細胞)的總 UMI 讀數就會開始隨機漂移,違反我們在第 1 篇建立的 Row-Sum UMI Conservation。+0.4, +0.4, +0.4。如果三個模型「先各自整數化再平均」,三個模型在取整時都會把它捨去為 0,加權平均後還是 0;但如果「先在浮點/對數效應空間融合再過一次整數化」,合成後的訊號就能順利跨越門檻!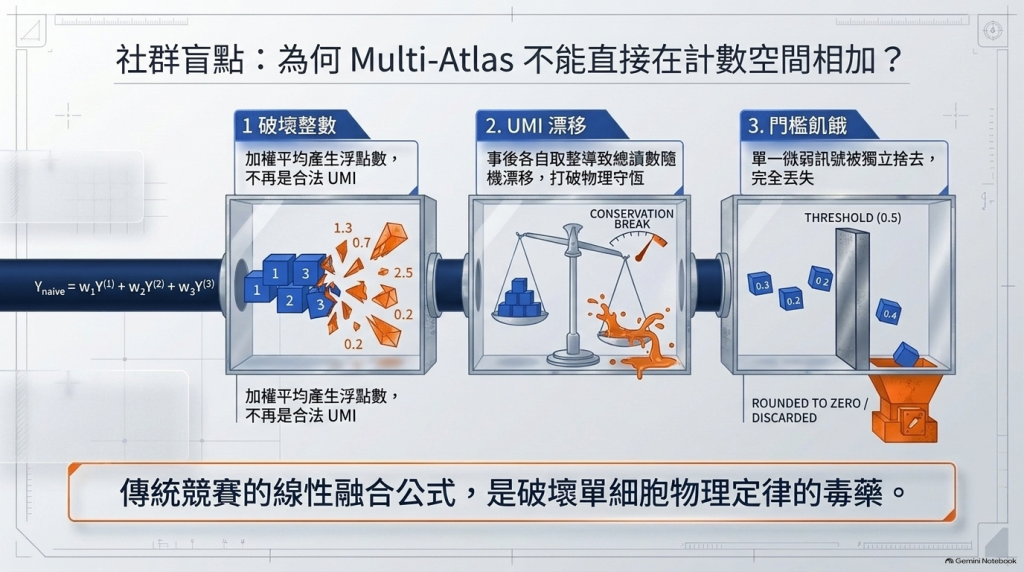
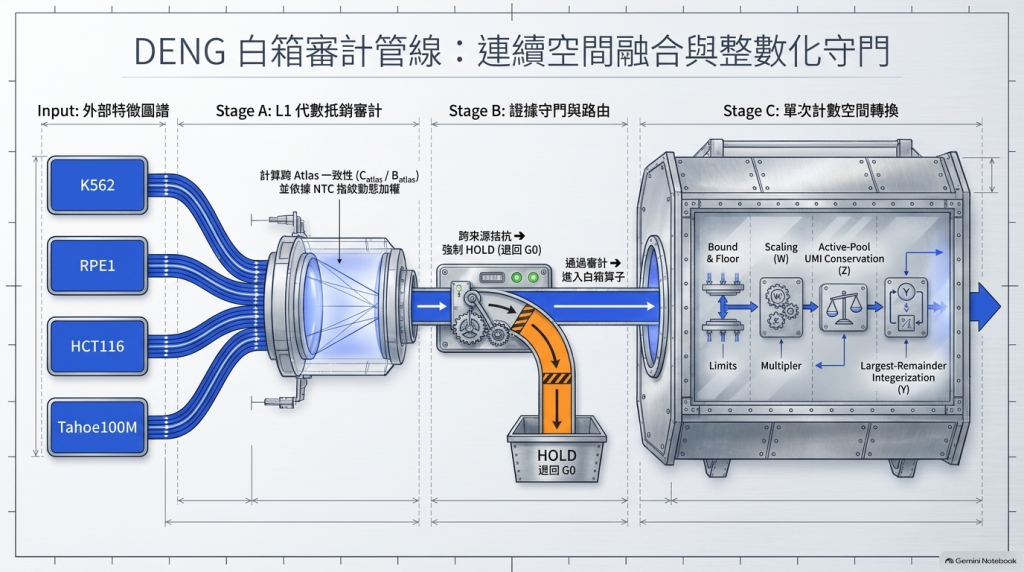
如果我們將外部高手的「Multi-Atlas + Ensemble」策略,與我們已經開源的 deng-cell-audit 白箱算子結合,下一代跨背景擾動預測系統(DENG v04)的最佳架構應該長這樣:
[Atlas 1: K562]     ──► d^(1)_t ┐
[Atlas 2: RPE1]     ──► d^(2)_t ├─► (Stage A) 跨來源 L1 代數抵銷審計 (decomposition.py)
[Atlas 3: HCT116]   ──► d^(3)_t │      • 計算跨 Atlas 一致性與抵銷率 C_atlas / B_atlas
[Atlas 4: Tahoe100M]──► d^(4)_t ┘      • 依據目標細胞 NTC 指紋 (ntc.py) 進行相似度加權
                                │
                                ▼
                  合成效應 d_ens = Σ w_m * d^(m)_t
                                │
                                ▼
              (Stage B) 證據守門與路由 (evidence.py)
                 • 若跨來源完全拮抗或無證據 ──► 強制 HOLD / 退回 G0 Baseline
                 • 通過審計 ──► 進入單次白箱算子
                                │
                                ▼
              (Stage C) 單次計數空間轉換 (operator.py)
                 • Bound & Floor ──► Scaling (W) ──► Active-Pool UMI Conservation (Z)
                 • 最後統一做一次 Largest-Remainder Integerization (Y)
decomposition.py 升級為「跨資料集衝突偵測器」:在第 3 篇中,我們用 C_cancel = Σ_g (|c_g| + |s_g| - |c_g + s_g|) 來衡量 common 與 specific 的代數抵銷。在 Multi-Atlas 架構下,完全同一個函式可以直接用來量測「不同公開資料集對同一基因靶點的效應方向是否互相抵銷」!如果 K562 說該基因上調、HCT116 卻說下調,高漲的 C_over_B 就會自動發出警告,提醒系統降低縮放權重 α,避免在未知 Context 中引發 MSE 爆炸。ntc.py 的控制組指紋決定 Atlas 權重 w_m**:透過比對目標未知細胞系的 NTC 表達分佈(mean_cp10k 與 detection_fraction)與各公開 Atlas 控制組的相似度,動態決定該向哪個細胞系借更多權重,而不是盲目使用固定權重。trace_operator()**:所有的 Ensemble 與收縮都在連續的對數效應空間完成,最後才交由 trace_operator() 統一執行一次 UMI 守恆與最大餘數整數化,100% 確保輸出矩陣的數學純淨度與小訊號存活率。這次賽後透過對比社群的公開方案,我們得到了最寶貴的一塊拼圖:
希望這 5 篇從底層矩陣算子一路聊到高層競賽策略的系列文,能為正在探索單細胞 AI、高維稀疏數據建模或 MLOps 資料治理的你帶來實質的啟發!
DENG Cell Audit v0.1.0-rc3 — by ARiN (MIT License)(全系列完)

 ARiN

 iThome鐵人賽
 看影片追技術