

上一篇我們談到檢索增強生成(RAG)的能力邊界。RAG 可以讓 AI 從企業文件中找到知識,但如果我們希望它取得即時數字、查詢專案狀態,甚至進一步執行某個動作,就需要讓模型具備使用外部系統的能力。
這就是 Tool Use(工具使用)。對大型語言模型來說,Tool 可以先理解成一組「我可以使用的方法」。每一項工具都有清楚的名稱、用途、輸入參數與回傳結果,模型本身不需要知道底層 API、SQL 或 Python 到底怎麼實作,只需要判斷:現在這個問題需要使用哪個工具,以及應該提供哪些參數。
例如 Data Machi 未來可能提供幾項不同的工具:
| Tool | 用途 |
|---|---|
search_documents |
從 PDF 或企業文件中搜尋相關內容 |
query_google_sheets |
查詢結構化數據並進行計算 |
get_trello_cards |
取得專案任務與目前狀態 |
get_current_inventory |
查詢目前庫存 |
create_project_task |
在專案系統中建立新任務 |
當使用者詢問不同問題時,模型就不需要靠自己「猜答案」,而是決定應該呼叫哪一個外部能力取得資訊。
這個系列為了好讀,會一直使用上面這類簡化過的工具名稱。如果你同時在看 Data Machi 的開源程式碼,可以用下表對照實際的工具:
| 文章裡的名稱 | 專案實際的工具 |
|---|---|
query_google_sheets |
query_worksheet_data、query_request_tickets_structured,另有 list_worksheets、get_worksheet_structure |
search_documents |
search_document_base |
search_confluence |
search_confluence_pages、search_confluence_knowledge_base |
get_project_status |
get_project_status(查整個 Trello 看板)、get_card_details、get_card_details_by_name |
get_current_inventory 與 create_project_task 則是為了說明概念舉的例子,專案目前沒有這兩個工具。
沒有 Tool Use 的大型語言模型,主要工作是根據目前收到的 Prompt 與 Context 產生下一段文字。就算你問它「昨天的實際銷售額是多少」,如果這個數字沒有出現在 Context 裡,它並沒有辦法自己跑去公司的資料庫查詢。加入 Tool Use 之後,流程就不一樣了。
使用者問題 → LLM 理解需求 → 判斷是否需要工具 → 選擇 Tool
→ 程式實際執行 → 取得結果 → 結果交回 LLM → 整理成使用者看得懂的回答
假設使用者問「昨天台灣的總銷售額是多少?」,模型看到這個問題之後,可以判斷這不是文件知識,而是需要查詢結構化資料,因此選擇 query_google_sheets,並準備相關參數:
date = yesterday
region = Taiwan
metric = sales
真正讀取 Google Sheets、篩選資料與計算 Sales 的工作則由程式負責。取得結果之後,再交給模型轉換成自然語言回答。因此 Tool Use 真正帶來的改變不是「讓 LLM 知道更多」,而是:
讓模型知道自己什麼時候不應該直接回答,而應該先去使用外部能力取得資訊。
Tool Use 中很常看到另一個名詞:Function Calling(函式呼叫),也常被稱為 Tool Calling。這個名字很容易讓人誤以為模型真的在執行程式,但實際上通常不是這樣。當模型支援 Function Calling 時,我們會先把目前可以使用的工具規格提供給模型,包括工具名稱、用途與需要的參數。例如有一個工具:
Name:
query_google_sheets

Description:
查詢指定日期與市場的銷售資料。

Parameters:
- date
- region
- metric
當使用者詢問「昨天香港的銷售額是多少?」,模型不一定直接回答數字,而可能先產生類似下面的決定:
Tool:
query_google_sheets

Arguments:
date = yesterday
region = Hong Kong
metric = sales
這時候真正執行 query_google_sheets 的不是模型,而是我們寫好的後端程式。程式收到參數之後查詢資料,再把結果回傳給模型。因此完整流程其實是:
使用者
  ↓
「昨天香港銷售多少?」
  ↓
LLM
  ↓
決定呼叫 query_google_sheets
  ↓
Backend 執行 Function
  ↓
取得 sales = 5,820,000
  ↓
結果送回 LLM
  ↓
「昨天香港銷售額為 HKD 5.82M。」
這裡有一個非常重要的分工,對企業 AI 特別重要:
模型負責理解意圖與選擇能力,程式負責執行事實。
假設使用者問「這個月平均訂單金額是多少?」,模型可以理解使用者想知道 Average Order Value,也可以知道應該取得 Sales 與 Orders。但最後的加總、除法與篩選邏輯,最好還是由 SQL、Pandas 或其他程式執行,而不是讓 LLM 自己根據大量數字計算。例如程式可以執行:
aov = total_sales / total_orders
或直接在 SQL 中完成:
SELECT
  SUM(net_sales) / COUNT(DISTINCT order_id) AS aov
FROM transactions
WHERE transaction_date BETWEEN start_date AND end_date
最後只把結果 AOV = 2,480 交回模型,整理成「本月平均訂單金額為 2,480 元。」
這樣做的原因不是模型完全不會算數,而是企業場景通常要求可重現、可驗證,而且每次使用相同條件都應該得到相同結果。如果一項工作本來就可以交給 SQL、Python 或既有系統精確完成,就不需要讓大型語言模型取代這些工具。可以把責任簡化成:
| 工作 | 比較適合誰負責 |
|---|---|
| 理解使用者想問什麼 | LLM |
| 判斷需要哪一個 Tool | LLM |
| 篩選資料 | SQL / Python / API |
| 數值計算 | SQL / Python |
| 權限檢查 | Backend / System |
| 整理成自然語言 | LLM |
這也是企業 AI 很重要的一個設計原則:讓模型處理模糊的語言問題,讓程式處理明確且需要精準執行的事情。
從程式角度來看,一個 Tool 最後可能只是某個 Python Function、API Wrapper 或資料查詢方法。例如我們可以有一個非常簡化的函式:
def get_project_status(project_id):
    # 呼叫專案系統 API
    # 取得目前專案資料
    return project_status
但單純有這個 Function 還不夠,因為模型必須知道它到底是做什麼的。如果系統裡同時有十幾個工具,而每個 Description 都只寫「查詢資料」,模型就很難判斷哪一個才適合目前的問題。因此,一個好的 Tool 至少需要說清楚四件事情:
| 工具要回答的問題 | 例子 |
|---|---|
| Name|它叫什麼? | get_project_status |
| Description|什麼情況使用? | 查詢專案目前進度、負責人與截止日期 |
| Parameters|需要什麼輸入? | Project ID |
| Return|會得到什麼? | 狀態、負責人、截止日期與資料來源 |
對非工程背景的讀者,不需要現在就先理解 JSON Schema 的完整寫法,可以先把 Tool 想成「交給 AI 使用的一項公司能力」。
假設工具 Description 只寫「查資料」,那麼當系統同時有 query_google_sheets、get_project_status 和 search_documents 時,模型很難知道三者的差異。如果改成「當使用者詢問專案目前進度、負責人、截止日期或未完成任務時使用。」,模型就更容易判斷這個工具適合什麼情境。
因此 Tool 的 Description 不是單純給工程師看的文件,它其實也是模型決策的一部分。
除了 Description,Parameters 的設計也會直接影響 Tool Use 是否穩定。假設我們設計一個銷售工具 query_sales,如果只有一個非常模糊的參數 query = "幫我找昨天台灣銷售",後端還需要重新理解一次自然語言,整個流程就多了一層不確定性。比較好的設計可能是:
region = Taiwan
start_date = 2026-08-23
end_date = 2026-08-23
metric = sales
也就是讓 LLM 負責把模糊的自然語言「昨天台灣賣多少?」轉換成比較明確的結構化參數,再讓程式根據這些參數執行。模型轉出來的參數也可能有錯,所以後端仍然要檢查格式與範圍,不能照單全收。整體可以理解成:
自然語言
「昨天台灣賣多少?」
        ↓
       LLM
        ↓
結構化參數
region = Taiwan
start_date = 2026-08-23
end_date = 2026-08-23
metric = sales
        ↓
      Tool
        ↓
精確查詢資料
這也是 Function Calling 很實用的一個地方:它讓自然語言和傳統程式之間多了一層可以互相銜接的介面。
做到這裡,我們已經有模型、有 Tool、有 Function Calling,很快就會開始遇到很多重複的整合工作:不同模型的 Tool Schema 怎麼定義、工具怎麼綁定到模型、Tool Call 執行結果要用什麼訊息格式送回去,以及對話歷史怎麼繼續保存。
LangChain 的價值,就是提供一組現成的抽象與介面,協助把這些元件串接起來。
可以把目前的架構想成:
使用者
   ↓
Prompt / Messages
   ↓
LangChain
   ↓
LLM
   ↓
Tool Calling
   ↓
Tools
   ↓
Tool Result
   ↓
LangChain
   ↓
LLM
   ↓
最終回答
LangChain 可以協助處理模型、Prompt、Messages、Tool Binding 與 Tool Result 之間的整合,讓開發者不需要每接一個模型或工具,就重新寫一套底層串接邏輯。
但這裡需要特別注意:LangChain 並不是 AI 的大腦。
如果把企業 AI 想成一間公司,LangChain 比較像幫各個部門統一接頭與溝通格式的基礎設施。它可以讓不同零件比較容易連接,但它不會自動知道公司的正確流程。例如 LangChain 不會替我們決定:
這些都不是框架本身能替產品團隊回答的問題。可以把責任簡單拆成兩邊:
| 負責什麼 | |
|---|---|
| LangChain | 模型整合、訊息格式、Tool Binding、Function Calling 整合、常見 Workflow 元件 |
| Business Logic | 資料定義、工具使用規則、權限、安全邊界、驗證方式、失敗處理 |
LangChain 可以幫我們少寫很多重複程式,但真正決定企業 AI 能不能可靠工作的,仍然是後面的系統設計。
框架最有價值的地方,是幫助開發者降低模型與工具的整合成本;最危險的地方,則是讓人誤以為只要套上一個 Agent Framework,系統就會自然理解企業流程。
假設公司規定:
「金額超過 100 萬的採購,需要取得兩層主管核准。」
這條規則如果非常重要,就不應該只寫在一段 Prompt 裡,期待模型永遠記得。更可靠的做法是把它放在明確的 Workflow 或 Backend Logic 中,例如:
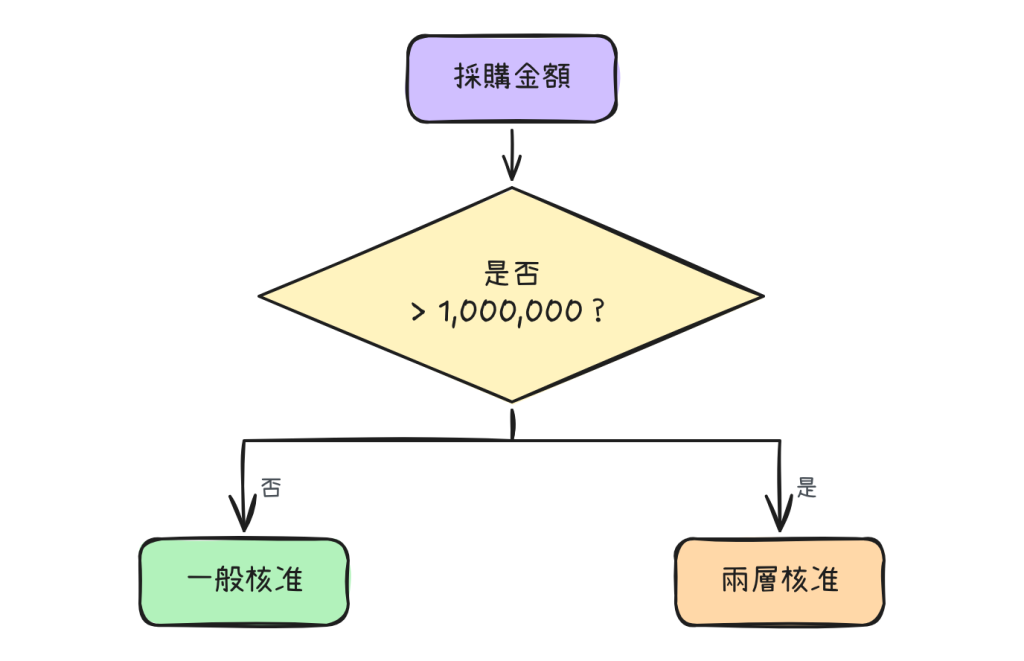
這樣即使未來從 Gemini 換成其他模型,或從 LangChain 換成其他 Framework,公司的核心規則仍然存在。
在 Data Machi 裡,我們會利用框架降低 Tool Integration 的成本,但關鍵的商業規則、資料邏輯與安全邊界仍然會清楚保留在程式與 Workflow 中。這樣技術元件可以替換,產品真正需要遵守的規則卻不會一起消失。
走到 Day 12,可以重新回頭看 AI 能力是怎麼逐步增加的。
最開始只有 LLM 時,模型主要依賴本身已有的知識回答;加入 RAG 之後,可以在回答前搜尋企業文件;加入 Tool Use 之後,則可以進一步取得即時資料、精確數字與外部系統狀態。
LLM
根據模型既有知識回答
        ↓

RAG
回答前先查企業文件
        ↓

Tool Use
向外部系統取得資訊
        ↓

Action Tool
進一步改變外部系統狀態
但能力越往下增加,風險也會跟著增加。查一個錯誤的銷售數字,和錯誤地刪除一筆資料,後果顯然不同。因此後面談到 Action、Agent 與 Workflow 時,我們還會持續加入權限、確認與驗證機制。
現階段最重要的是先建立正確的分工:LLM 不需要取代所有程式,而是負責理解人類的需求,再選擇適合的程式能力完成工作。
如果用一句比較容易記住的方式理解 LangChain,可以把它看成 AI 應用中的 Middleware(轉接層)。它幫助不同模型、Prompt、Messages 與 Tools 使用比較一致的方法連接,也降低不同 API 之間的整合成本。但產品要解決什麼問題、什麼資料才是正確的、哪些 Tool 可以使用,以及哪些動作不能讓 AI 自己決定,仍然需要由系統設計者負責。
因此,真正建立企業 AI 時,應該避免先問「我要使用哪個 Agent Framework?」,而要先問:
「我要讓 AI 完成什麼工作?它需要哪些能力?每一項能力的資料來源與安全邊界是什麼?」
當這些事情定義清楚之後,LangChain、LangGraph 或其他 Framework 才是協助我們實作架構的工具,而不是架構本身。
今天的重點:
Tool Use 的核心,是讓模型學會「選擇能力」,但真正的資料查詢、精確計算與系統操作仍然由程式執行。Function Calling 負責把模型的意圖轉換成工具呼叫,而 LangChain 則協助我們把模型、訊息與工具串接起來;它是一個整合工具箱,不是企業業務流程本身。
下一篇,我們會實際加入第一個結構化資料工具,讓 Data Machi 開始查詢 Google Sheets,並讓所有數字都由程式精確計算,而不是交給模型自己猜或運算。
我們下集見囉!


 iThome鐵人賽
 看影片追技術