
目标:用一套可落地的生产级电商案例,把大数据系统从“数据产生、采集、传输、存储、计算、数仓分层、实时分析、离线分析,到 BI/用户画像/推荐/风控”的全过程串起来,并且设计一套中等规模电商系统的大数据架构
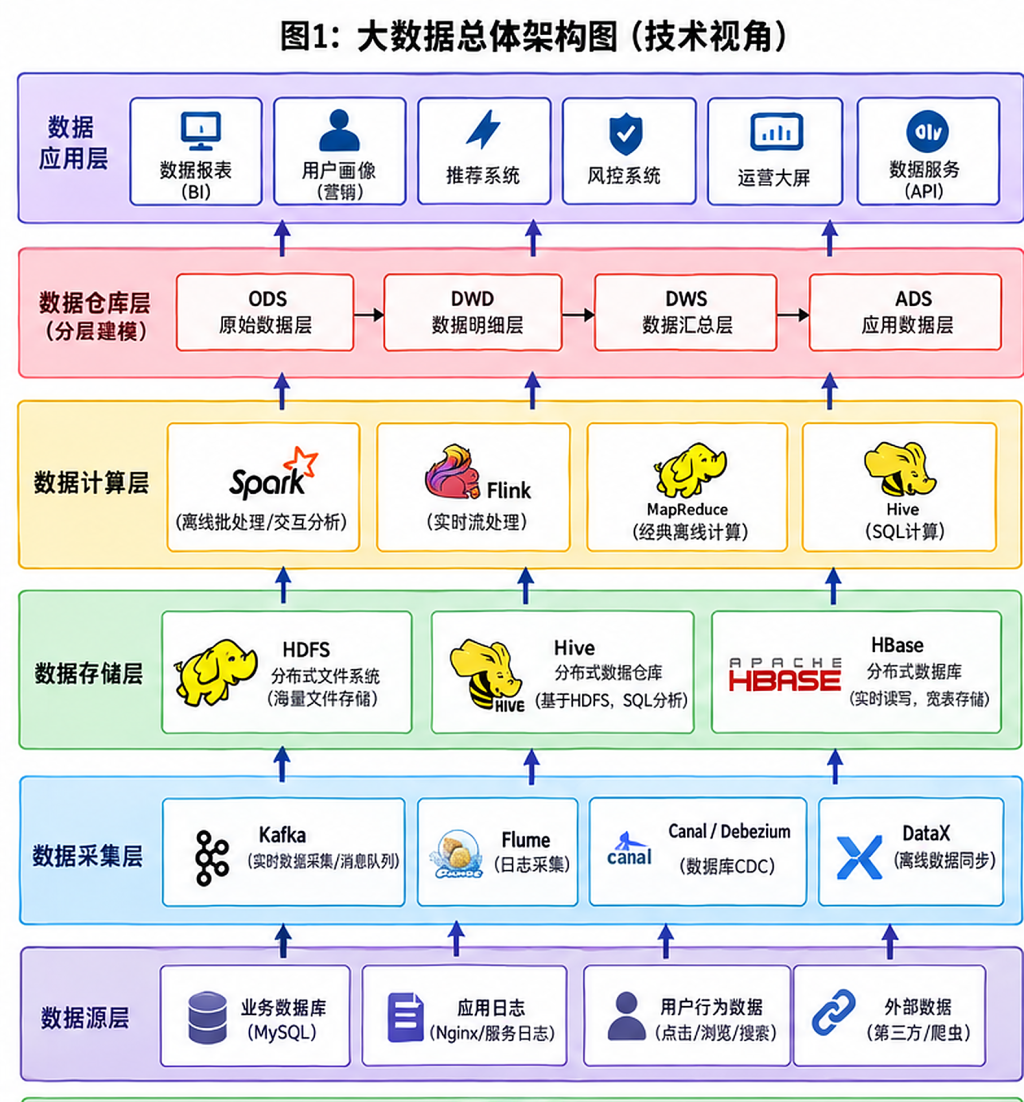
可以把一个完整的大数据系统理解为六层:
数据源
  ↓
数据采集
  ↓
数据存储
  ↓
数据计算
  ↓
数据仓库
  ↓
数据应用
一个典型架构是:
                    【数据源】
                       │
       ┌───────────────┼───────────────┐
       ↓               ↓               ↓
     MySQL           APP日志          用户行为
       │               │               │
       └───────────────┼───────────────┘
                       ↓
                  【数据采集】
             Kafka / Flume / CDC
                       │
                       ↓
                  【数据存储】
             HDFS / Hive / HBase
                       │
                       ↓
                  【数据计算】
       MapReduce / Spark / Flink / Hive SQL
                       │
                       ↓
                  【数据仓库】
             ODS → DWD → DWS → ADS
                       │
                       ↓
                  【数据应用】
          ┌────────────┼────────────┐
          ↓            ↓            ↓
       数据报表       用户画像       推荐系统
          ↓            ↓            ↓
         BI           营销          风控
这张图最重要的不是记住软件名字,而是理解数据生命周期:
数据源不是某个大数据组件,而是企业中所有产生业务数据的系统。
电商系统中 MySQL 通常保存最关键的交易数据,例如:
user          用户
product       商品
sku           商品规格
inventory     库存
cart          购物车
orders        订单
order_item    订单明细
payment       支付
refund        退款
address       收货地址
例如一条订单记录:
order_id   = 202609140001
user_id    = 10086
amount     = 6999.00
status     = PAID
create_time= 2026-09-14 01:20:11
MySQL 属于 OLTP(在线事务处理) 系统,它首先要保证用户下单、支付、库存扣减等交易正确完成。大数据系统应该是它的下游,而不是让用户下单依赖 Hadoop。
应用服务器、Nginx、网关会持续产生日志,例如:
/var/log/nginx/access.log
/var/log/app/order-service.log
/var/log/app/user-service.log
这些日志可用于:
用户行为比普通访问日志更有业务意义,例如:
view_product
search
add_cart
remove_cart
favorite
submit_order
pay_success
coupon_receive
share
一条事件可能长这样:
{
  "user_id": 10086,
  "event": "view_product",
  "product_id": 8888,
  "device": "ios",
  "ts": 1789348811000
}
这些数据是推荐系统、用户画像、营销分析的重要来源。
还可能包括:
采集层的目标不是“计算”,而是可靠地把不同来源的数据送到统一的数据平台。
Kafka 可以理解为整个数据平台的“高速数据总线”。
它负责:
典型 Topic:
order_event
payment_event
user_event
product_event
click_event
search_event
inventory_event
refund_event
数据流:
订单服务 ─┐
支付服务 ─┼──→ Kafka ──→ Flink
APP事件  ─┤          └──→ HDFS
CDC     ─┘          └──→ 风控/推荐
Kafka 不是长期数据仓库,它更像一个可靠的中转层。
Kafka 自己就是一个集群。现代 KRaft 模式通常使用少量 Controller 管元数据,Broker 负责真正的数据读写。关键生产环境常将 Controller 和 Broker 分离。Apache Kafka 官方文档指出 Controller quorum 常见为 3 或 5 个节点,以容忍控制节点故障。
本报告示例采用:
Kafka Controller:3 台
Kafka Broker:5 台
如果机器数量有限,也可以 Controller/Broker 共置,但生产关键系统更推荐分离。
Flume 适合持续读取服务器日志并转发:
Nginx access.log
        ↓
    Flume Agent
        ↓
      Kafka
它不是必须安装在 Hadoop 的每一个节点上,而应该安装在真正产生需要采集日志的节点附近。
例如 10 台业务应用服务器:
APP01:Java + Flume
APP02:Java + Flume
...
APP10:Java + Flume
如果企业采用集中日志 Agent,也可以用若干日志采集节点统一转发。
实际新项目也常使用 Fluent Bit、Vector、Filebeat 等替代日志 Agent;本报告保留 Flume 是为了对应经典 Hadoop 大数据技术栈。
对于 MySQL 订单数据,不建议大数据平台每分钟执行:
SELECT * FROM orders;
因为这会给生产数据库带来压力。
更典型的方式是 CDC(Change Data Capture):
MySQL
  ↓ Binlog
Flink CDC / Debezium
  ↓
Kafka
例如 MySQL 插入订单:
INSERT orders ...
CDC 读取 Binlog 后转换成事件并发送到 Kafka。
优势:
这三个组件看起来都和“存数据”有关,但解决的是不同问题。
HDFS 是 Hadoop 分布式文件系统,是 Hadoop 最核心的存储组件。
它解决的是:
一台机器放不下 PB 级数据怎么办?
HDFS 把文件切成 Block,然后分散到多个 DataNode:
orders.parquet
      │
      ├── Block A → DataNode01
      ├── Block B → DataNode02
      ├── Block C → DataNode03
      └── ...
HDFS 的核心进程:
NameNode
  ├── 管文件目录
  ├── 管文件到 Block 的映射
  └── 管 Block 在哪些 DataNode

DataNode
  └── 真正保存 Block 数据
HDFS 官方架构中,客户端先向 NameNode 查询元数据,真正的数据 I/O 则直接与 DataNode 进行。
HDFS 特点:
Hive 不是另一套磁盘系统。
更准确地说:
Hive 把 HDFS 中的文件映射成“表”,为大规模历史数据提供 SQL 查询和数据仓库能力。
HDFS 中:
/warehouse/dwd/order_detail/dt=2026-09-14/
  part-00001.parquet
  part-00002.parquet
Hive 中可以表现为:
dwd.dwd_order_detail
然后数据开发人员写:
SELECT product_id, SUM(amount)
FROM dwd.dwd_order_detail
WHERE dt='2026-09-14'
GROUP BY product_id;
Hive 主要包含:
底层真正的大数据文件仍然可以位于 HDFS。
因此可以记:
HDFS = 文件存储
Hive = 表结构 + 元数据 + SQL 访问
Hive 主要适合:
HBase 解决的是另一类问题:
我有数十亿/数百亿条记录,希望按 RowKey 快速随机读取和写入。
例如:
RowKey = user_10086
快速读取:
用户等级
画像标签
最近行为摘要
风险标记
HBase 的主要角色:
HMaster
  └── 管理 Region、RegionServer、表结构、负载均衡等

RegionServer
  └── 真正负责 Region 的读写

HDFS
  └── 底层持久化 StoreFile/HFile 等数据
Apache HBase 官方架构说明 RegionServer 负责 Region 的 Get/Put/Delete 等读写,并通常运行在 HDFS DataNode 节点附近,以利用数据本地性。
                    HDFS
        ┌────────────┴────────────┐
        ↓                         ↓
      Hive                       HBase
历史批量分析/SQL             随机实时读写
        │                         │
 Spark/Hive SQL           用户画像/在线查询等
简单记忆:
MapReduce 是 Hadoop 经典分布式计算模型。
流程:
HDFS 数据
   ↓
Map:分片并行处理
   ↓
Shuffle:按 Key 重分区/聚合
   ↓
Reduce:汇总
   ↓
HDFS 输出
例如统计商品销量:
Map:
(iPhone,2)
(iPhone,3)
(MacBook,1)

Shuffle:
iPhone → [2,3,...]

Reduce:
iPhone → 125893
它可靠、经典,但复杂任务通常磁盘 I/O 较多,因此现代离线计算更常使用 Spark。
YARN 负责:
典型角色:
ResourceManager
  └── 全局资源调度

NodeManager
  └── 每台 Worker 上的本地资源管理
Spark 可以运行在 YARN 上,因此 Spark 不一定需要独立的 Spark 物理服务器集群。
Spark 常用于:
数据流:
HDFS/Hive
   ↓
Spark SQL
   ↓
ODS → DWD → DWS → ADS
Spark 运行在 YARN 时:
Spark Job
   ↓
YARN ResourceManager
   ↓
在 30 台 Worker 中分配 Executor
所以 30 台 Hadoop Worker 同时可以是:
DataNode       → 提供 HDFS 磁盘
NodeManager    → 提供 YARN CPU/RAM
Spark Executor → 按任务临时启动
Flink 更典型的用途是:
Kafka 数据不断到达
        ↓
Flink 持续运行
        ↓
边到达边计算
        ↓
秒级甚至更低延迟结果
例如实时 GMV:
Kafka order_event
       ↓
Flink
       ↓
过滤支付成功订单
       ↓
SUM(amount)
       ↓
ClickHouse / Redis
       ↓
实时运营大屏
Flink 的核心进程:
JobManager
  ├── 调度任务
  ├── 协调 checkpoint
  └── 故障恢复

TaskManager
  └── 真正执行算子任务
Flink 官方文档说明其运行时由 JobManager 和一个或多个 TaskManager 构成;HA 模式可以由一个 Leader JobManager 和多个 Standby 组成,并从 checkpoint/持久状态恢复任务。
不要简单理解成:
Spark = 离线
Flink = 在线
两者能力都有重叠,但在典型生产分工中:
Spark → 大规模离线批计算
Flink → 长时间运行的实时流处理
ODS、DWD、DWS、ADS 不是四套服务器,也不是四个软件。
它们是数据仓库的四个逻辑加工层,通常表现为 Hive 数据库、表、目录或 Lakehouse 表。
目标:尽可能保留源数据原貌。
例如:
ods.ods_order
ods.ods_user
ods.ods_product
ods.ods_click_log
订单源数据进入 ODS 后,可以保持接近 MySQL 的字段结构。
作用:
对 ODS 数据做标准化和清洗:
例如:
ods_order
   ↓ Spark SQL
去重 + 状态标准化 + 字段清洗
   ↓
dwd_order_detail
DWD 是后续业务分析最重要的统一明细数据层。
把 DWD 按常用业务维度进行公共聚合。
例如:
dws_user_day
  每个用户每天:订单数/金额/活跃次数

dws_product_day
  每个商品每天:销量/GMV/访客数

dws_region_day
  每个地区每天:用户数/订单数/GMV
目的:避免每个下游报表都重复扫描明细数据。
ADS 是面向具体应用和指标的结果层。
例如:
ads_daily_gmv
ads_product_top100
ads_user_retention
ads_conversion_funnel
ads_region_sales
这些表已经非常接近 BI 或 API 所需要的数据。
可能全部在同一个 HDFS 集群:
/warehouse/ods/
/warehouse/dwd/
/warehouse/dws/
/warehouse/ads/
Hive 中:
ods.*
dwd.*
dws.*
ads.*
所以:
数据仓库分层 = 数据组织方法
不是四套服务器
展示:
生产环境通常不会让浏览器直接扫描 HDFS。
典型:
ADS
 ↓
ClickHouse / Doris
 ↓
报表 API
 ↓
BI / 管理后台
用户画像本质上是把大量行为加工成用户标签:
user_10086
  ├── 数码兴趣:高
  ├── 价格敏感:中
  ├── 最近30天订单:8
  ├── 客单价:¥3800
  ├── 高频访问时间:22:00
  └── 高价值用户:true
离线画像:Spark 根据 7/30/90 天历史数据加工。
实时画像:Flink 根据当前行为动态更新。
在线查询结果可进入 HBase / Redis / Elasticsearch 等服务层。
推荐系统通常消费:
架构:
离线 Spark:训练特征/候选集
实时 Flink:更新实时兴趣
         ↓
推荐服务 API
         ↓
商城首页/商品详情页
风控需要实时性更高:
支付请求
   ↓
设备/IP/账户/历史交易特征
   ↓
Flink / 在线特征服务
   ↓
风险模型
   ↓
放行 / 验证 / 拒绝 / 人工审核
以一条支付成功订单为例:
1. 用户支付成功
      ↓
2. 订单/支付系统写入 MySQL
      ↓
3. MySQL Binlog 记录变化
      ↓
4. CDC 捕获变化
      ↓
5. 写入 Kafka payment_event/order_event
      ↓
      ├───────────────实时链路──────────────┐
      │                                      │
      ↓                                      ↓
6A. Flink                               6B. HDFS 落盘
      ↓                                      ↓
7A. 秒级计算 GMV/订单量                  7B. ODS
      ↓                                      ↓
8A. ClickHouse/Redis                    8B. Spark 清洗 → DWD
      ↓                                      ↓
9A. 实时大屏                            9B. 聚合 → DWS
                                             ↓
                                        10B. ADS
                                             ↓
                                        11B. BI/画像/分析
实时链路解决“现在发生了什么”;离线链路解决“历史数据整体说明了什么”。
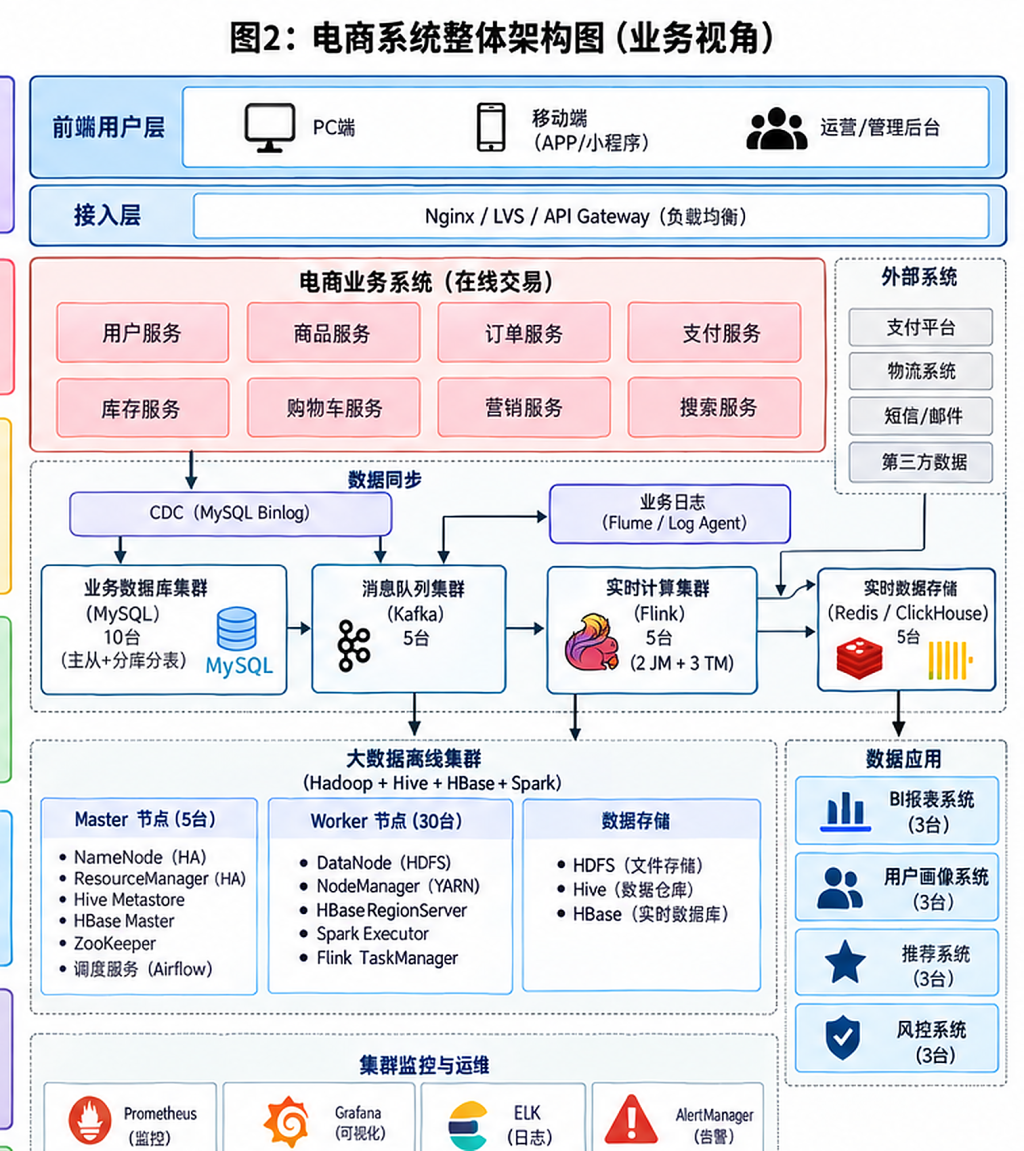
生产电商系统建议明确分成两部分:
A. 在线交易系统(OLTP)
B. 数据分析系统(Big Data / OLAP)
在线交易链路:
用户
 ↓
Nginx / API Gateway
 ↓
用户/商品/购物车/订单/支付/库存服务
 ↓
MySQL + Redis
数据分析链路:
MySQL/日志/行为
 ↓
CDC / Flume / Producer
 ↓
Kafka
 ├──→ Flink → 实时存储 → 实时 BI/风控
 └──→ HDFS → Hive/Spark → ODS/DWD/DWS/ADS → OLAP → BI
关键原则:
即使 Kafka、Flink、Spark、Hive 暂时发生故障,商城用户也应该尽可能仍可正常下单;大数据链路允许延迟恢复,而不能轻易阻断主交易链路。
下面给出一套“中大型电商 + 实时大数据 + 离线数仓”的示例。这不是唯一答案,这个模拟的部署方案:节点职责完整、角色清晰、可作为学习和规划模板。目的是在这个部署方案的基础上,从技术角度理解大数据的架构和工作过程.
| 节点范围 | 数量 | 主要角色 |
|---|---|---|
| srv001-srv002 | 2 | Nginx/LVS/API Gateway |
| srv003-srv012 | 10 | 电商业务服务 + Flume Agent |
| srv013-srv018 | 6 | MySQL 业务数据库(3 组主从/分片) |
| srv019-srv021 | 3 | Redis Cluster |
| srv022-srv024 | 3 | Kafka KRaft Controller |
| srv025-srv029 | 5 | Kafka Broker |
| srv030-srv031 | 2 | CDC 服务(Flink CDC/Debezium Connect) |
| srv032-srv033 | 2 | Flink JobManager HA |
| srv034-srv043 | 10 | Flink TaskManager |
| srv044-srv048 | 5 | Hadoop Master / Hive/HBase 管理角色 |
| srv049-srv078 | 30 | Hadoop Worker:DataNode + NodeManager;部分兼任 HBase RegionServer |
| srv079-srv081 | 3 | HiveServer2 + Metastore + SQL Gateway |
| srv082-srv086 | 5 | ClickHouse/Doris OLAP 集群 |
| srv087-srv089 | 3 | BI / 报表 API |
| srv090-srv092 | 3 | 用户画像服务 |
| srv093-srv095 | 3 | 推荐/风控在线服务 |
| srv096-srv098 | 3 | Prometheus/Grafana/日志平台 |
| srv099-srv100 | 2 | Airflow/DolphinScheduler + 运维/堡垒/发布 |
总计:100 台。
注意:这里 MySQL 使用 6 台,而不是机械使用 10 台。真实项目数据库节点数量应由分片数、QPS、容量和 HA 方案决定。如果确实需要 10 台,可将其扩为 5 个主从组,减少应用节点或增加总机器数即可。
安装:
HDFS NameNode Active
YARN ResourceManager Active
ZooKeeper 1
JournalNode 1
HBase HMaster Active
作用:主要控制节点。
安装:
HDFS NameNode Standby
YARN ResourceManager Standby
ZooKeeper 2
JournalNode 2
HBase HMaster Standby
作用:HA 故障接管。
安装:
ZooKeeper 3
JournalNode 3
Hadoop HistoryServer
HBase Backup Master(可选)
作用:仲裁、Journal、高可用支持、历史任务查看。
安装:
Hive Metastore 实例
Spark History Server
HDFS/YARN Client
Hive Client
安装:
Hive Metastore 备用实例
HBase 管理工具
数据质量服务
统一元数据/血缘服务(可选)
YARN 的 ResourceManager 通常是 Active/Standby HA,不是 5 台同时独立调度 30 台 Worker。
5 台 Master 是为了承载多种控制面角色,并让关键服务具备高可用。
节点:
srv049 ~ srv078
所有 30 台安装:
Java
Hadoop Client/Common
HDFS DataNode
YARN NodeManager
Spark Runtime/Client
监控 Agent
日志 Agent
即:
每台 Worker
├── DataNode      → 磁盘属于 HDFS
├── NodeManager   → CPU/RAM 属于 YARN
└── Spark Executor→ Spark Job 运行时动态启动
选其中 12 台,例如:
srv049 ~ srv060
额外安装:
HBase RegionServer
推荐这 12 台使用:
剩余 18 台:
srv061 ~ srv078
重点承担 HDFS + Spark/YARN 离线计算。
计算/存储平衡型:
CPU:32~64 Core
RAM:128~256 GB
数据盘:8~16 块 HDD
系统盘:SSD RAID1
网络:25GbE 起步较合理
HBase RegionServer 节点可以提高 RAM 和 SSD 配置。
Kafka KRaft Controller
只负责元数据和 Controller quorum。
Kafka Broker
建议:
示例分为 3 个主从组:
Group A:srv013 Primary + srv014 Replica
Group B:srv015 Primary + srv016 Replica
Group C:srv017 Primary + srv018 Replica
可以按业务拆分:
A:用户/商品
B:订单/支付
C:库存/营销
更大规模可做 Sharding、MGR/InnoDB Cluster、ProxySQL 等,但大数据平台只需要关心稳定获得 Binlog/CDC 数据。
Flink JobManager HA
Flink TaskManager
承担:
Checkpoint 建议放 HDFS 或可靠对象存储,不要只放 TaskManager 本地盘。
不专门建设 Spark 服务器。
运行模式:
Spark on YARN
Spark Driver/Executor 由 YARN 在 srv049-srv078 上按任务申请资源。
用途:
部署:
HiveServer2:至少 2 个实例
Hive Metastore:至少 2 个实例
SQL Gateway / Beeline 接入
Metastore 数据库可以使用独立 MySQL/PostgreSQL HA,也可以在 srv079-srv081 中运行独立小型元数据库,但生产最好不要与电商交易 MySQL 混用。
数据本身仍在:
HDFS srv049-srv078
不需要单独服务器。
它们是 Hive/HDFS 上的逻辑分层:
Hive database: ods
Hive database: dwd
Hive database: dws
Hive database: ads
数据目录:
/warehouse/ods
/warehouse/dwd
/warehouse/dws
/warehouse/ads
控制面:
HMaster:srv044/srv045
ZooKeeper:srv044/srv045/srv046
数据面:
RegionServer:srv049-srv060
HDFS:srv049-srv078
用途:
srv082-srv086
作用:
因为 Hive/HDFS 更适合大扫描,不适合后台每次点击都扫描 TB 级数据。
srv087-srv089
部署:
报表 API
BI Server
运营后台数据接口
查询 ClickHouse/Doris,而不是直接让浏览器访问 HDFS。
srv090-srv092
部署:
Profile Service API
画像查询服务
标签管理服务
底层可以读取:
HBase / Redis / ClickHouse
srv093-srv095
可运行:
Recommendation API
Risk API
模型推理服务
在线特征读取
真实大型系统通常会把推荐和风控进一步拆成独立集群,这里为了 100 台示例进行了合并。
现在从一个真实用户开始。
用户购买一台 6999 元手机。
① 用户打开商品页面
       ↓
② Nginx/API Gateway
       ↓
③ 商品服务查询商品与库存
       ↓
④ Redis/MySQL 返回商品信息
       ↓
⑤ 用户加入购物车
       ↓
⑥ 购物车服务
       ↓
⑦ 用户提交订单
       ↓
⑧ 订单服务校验价格/优惠
       ↓
⑨ 库存服务锁定库存
       ↓
⑩ MySQL 创建订单
       ↓
⑪ 支付服务调用支付平台
       ↓
⑫ 支付成功
       ↓
⑬ MySQL 更新订单 = PAID
       ↓
⑭ 返回用户:“支付成功”
这条主链路不应依赖 Hadoop 是否可用。
MySQL 更新:
orders.status = PAID
MySQL Binlog 出现变更。
MySQL Binlog
     ↓
Flink CDC / Debezium
     ↓
Kafka order_event/payment_event
例如:
{
  "order_id": 202609140001,
  "user_id": 10086,
  "product_id": 8888,
  "amount": 6999.00,
  "status": "PAID",
  "event_time": "2026-09-14 01:20:11"
}
目标:后台 1~5 秒内看到销售额变化。
Kafka order_event
        ↓
Flink TaskManager
        ↓
过滤 status=PAID
        ↓
按窗口/维度聚合
        ↓
今日 GMV +6999
今日订单 +1
商品销量 +1
地区销售额 +6999
        ↓
ClickHouse / Redis
        ↓
BI API
        ↓
运营实时大屏
还可以同时:
Flink
 ├── 更新用户实时画像
 ├── 产生推荐实时特征
 └── 计算支付风控特征
这叫 实时流处理。
实时处理速度快,但复杂历史分析仍适合离线数仓。
订单事件被可靠保存到 HDFS:
/data/ods/order/dt=2026-09-14/
ods_order
保存接近源系统的订单变化。
凌晨或周期性 Spark SQL:
ODS
 ↓
去重
订单最终状态整理
时间标准化
金额校验
关联商品/用户维度
 ↓
DWD
结果:
dwd_order_detail
按常用粒度聚合:
dws_user_day
  user_id=10086
  order_count=3
  gmv=13998

dws_product_day
  product_id=8888
  sales=12840
  gmv=89867160
为具体业务准备结果:
ads_daily_gmv
ads_top_product
ads_new_user
ads_retention
ads_region_sales
ADS
 ↓
ClickHouse/Doris
 ↓
BI 报表

ADS/DWS
 ↓
用户画像离线特征
 ↓
HBase

DWD/DWS
 ↓
推荐特征/模型训练数据
                    用户购买商品
                         │
                         ↓
                   【业务主链路】
             订单服务 → MySQL → 支付成功
                         │
                         │ Binlog/事件
                         ↓
                       Kafka
                ┌────────┴────────┐
                │                 │
          【实时处理】          【离线处理】
                │                 │
              Flink             HDFS
                │                 │
         实时GMV/风控           Hive ODS
                │                 │
     ClickHouse/Redis          Spark
                │                 │
           实时运营大屏          DWD
                                  ↓
                                 DWS
                                  ↓
                                 ADS
                                  ↓
                         BI/画像/推荐/分析
这一张逻辑图就是电商大数据系统最核心的数据闭环。
MySQL = 交易系统
Hadoop/ClickHouse = 分析系统
不要让复杂报表 SQL 直接拖垮订单库。
下游 Flink 暂时升级或短时间不可用时,Kafka 可以保存一段时间的数据,让消费者恢复后继续处理。
HDFS/Hive → TB/PB 离线扫描
ClickHouse/Doris → 后台交互式查询
Spark/Flink 计算
HDFS/HBase/OLAP 保存结果
这是最容易混淆的地方。
Kafka、MySQL、Flink、Hadoop Worker 的资源特点不同:
因此生产环境不要随意把所有组件堆在同一台服务器。
| 模块 | 核心问题 | 典型技术 |
|---|---|---|
| 数据源 | 数据从哪里产生 | MySQL、APP、Web、第三方 |
| 数据采集 | 怎么可靠送进平台 | Kafka、Flume、CDC |
| 分布式存储 | 海量数据放哪里 | HDFS |
| SQL/数仓接口 | 怎么把文件变成表 | Hive |
| 随机实时数据库 | 海量数据怎么按 Key 快速访问 | HBase |
| 资源管理 | 谁来分 CPU/RAM | YARN |
| 批处理 | 历史数据怎么大规模计算 | Spark / MapReduce |
| 实时处理 | 数据来一条怎么算一条 | Flink |
| 数仓建模 | 怎么把数据加工成资产 | ODS/DWD/DWS/ADS |
| 交互查询 | BI 如何快速响应 | ClickHouse/Doris |
| 数据应用 | 数据最后产生什么价值 | BI/画像/推荐/风控 |
一套完整的电商大数据平台可以概括为:
【生产业务】
用户 → 电商服务 → MySQL
                   │
                   ↓
                 CDC
                   │
                   ↓
【数据总线】     Kafka
             ┌─────┴─────┐
             ↓           ↓
【实时】   Flink        HDFS   【离线】
             ↓           ↓
      实时指标/画像      Hive
             ↓           ↓
   ClickHouse/Redis     Spark
             │           ↓
             │      ODS→DWD→DWS→ADS
             │           │
             └─────┬─────┘
                   ↓
         BI / 用户画像 / 推荐 / 风控
其中:
最终需要形成的核心认识是:
大数据系统不是一台超级服务器,而是把采集、传输、存储、计算、建模和应用拆成多个可横向扩展的分布式系统;交易系统负责“正确地产生数据”,大数据平台负责“可靠地收集、加工并使用数据”。

 greenyang361

 iThome鐵人賽
 看影片追技術