
我的 MCP server 現在有超過 200 個工具。
這件事是慢慢發生的。一開始十幾個,某天需要查記憶就加了幾個記憶工具,需要管任務就加了任務工具,需要發訊息就加了通道工具。每一次都只加兩三個,每一次都覺得很合理。
直到我開始量固定開銷,才發現這 200 個工具的宣告,是每一次 spawn 都要付的錢。
拿昨天那個 task_list 來算:
{
  "name": "task_list",
  "description": "列出待辦任務。當使用者問「有什麼要做的」、「進度如何」,或你需要知道目前有哪些工作在進行時使用。",
  "inputSchema": {
    "type": "object",
    "properties": {
      "status": {"type": "string", "enum": ["todo","doing","done"],
                 "description": "只列出這個狀態的任務,省略則列出全部"}
    },
    "required": []
  }
}
這個 JSON 大約 150 到 200 個 token。它算是小的:一個參數、簡短描述。
實際專案裡的工具通常長這樣:五到八個參數,每個參數都有說明,描述寫得比較完整,可能還有回傳格式的說明。這種工具一個要 400 到 800 個 token。
用 500 當平均值算:
| 工具數 | 宣告成本 | 一天 100 次 spawn |
|---|---|---|
| 10 | 5,000 | 500 K |
| 50 | 25,000 | 2.5 M |
| 200 | 100,000 | 10 M |
十萬個 token。這已經超過很多模型的 context window 一半了,而模型還沒開始工作。
我實際的數字沒這麼誇張(有些工具描述很短),但量級是對的。這也是為什麼我在 Day 6 說 MCP 工具是固定開銷裡最大的一塊。
方法一:把描述寫短。
最直覺,效果有限,而且有反效果。描述寫太短,模型不知道什麼時候用,工具的呼叫率會掉。我在 Day 7 講過一個例子:一個工具因為描述太抽象,兩週零呼叫。
我的做法是分級:高頻工具寫詳細(值得那個成本),低頻工具寫精簡。判斷高頻低頻要看實際數據,不要憑感覺,稽核紀錄裡就有。
# 從稽核紀錄統計工具使用頻率
jq -r 'select(.outcome=="ok") | .tool' tool_calls.jsonl | sort | uniq -c | sort -rn
我第一次跑這個統計的時候嚇一跳:200 個工具裡,佔了 80% 呼叫量的只有 12 個。長尾有五十幾個工具,三個月來一次都沒被呼叫過。
方法二:按能力過濾。
昨天講過,重用 authorize 判斷來過濾 tools/list。這是最沒有副作用的做法,因為被過濾掉的工具本來就不能用。
實測效果取決於你的權限設計有多細。我的巡檢型 agent 只有唯讀 scope,過濾後從 200 降到 40 幾個,省了 70%。
方法三:按角色策展。
這是我現在的主力做法。不要問「這個 agent 有權用哪些工具」,要問「這個 agent 的工作需要哪些工具」。
# 按角色預先策展好的工具集
TOOL_PRESETS = {
    "inspector": [          # 巡檢:看,不動
        "task_list", "log_search", "metric_query", "activity_list",
    ],
    "responder": [          # 回話:讀記憶、回訊息
        "memory_search", "memory_store", "send_message", "task_list",
    ],
    "worker": [             # 執行:完整工作流
        "task_list", "task_claim", "task_update", "task_complete",
        "memory_search", "file_read", "file_write",
    ],
}

def tools_for(role: str, caller: Caller) -> list[dict]:
    names = TOOL_PRESETS.get(role, [])
    # 策展之後仍要過權限,兩層都要(策展省錢,權限保命)
    return [t for t in ALL_TOOLS
            if t["name"] in names and can_use(caller, t["name"])]
從 200 降到 5 到 10 個。這已經是數量級的差別,用百分比描述都嫌保守。
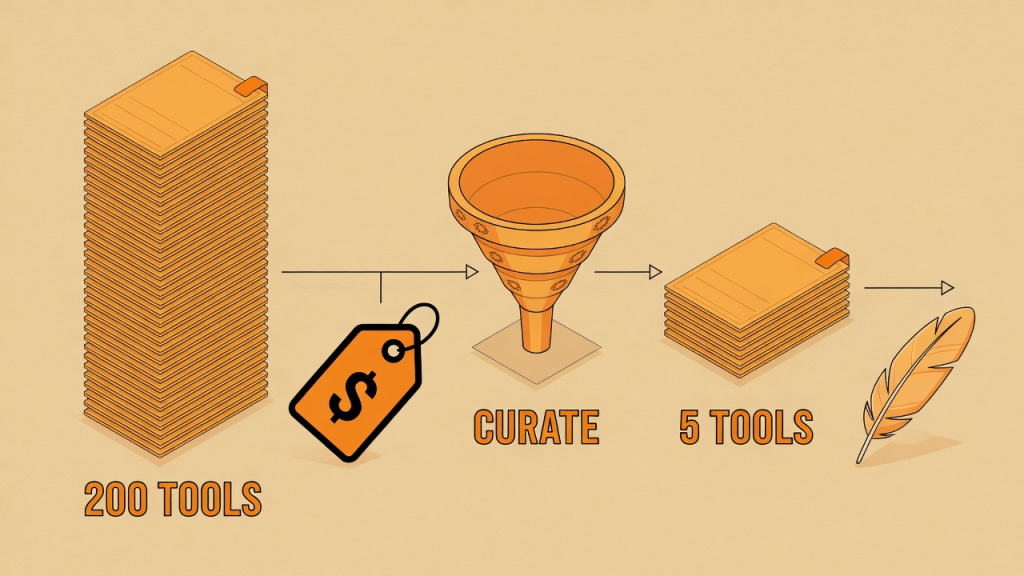
重點是問「這個角色需要哪些工具」,而不是「這個角色有權用哪些工具」。前者的答案通常是後者的十分之一。
策展的代價是:你要真的了解每個角色的工作內容。這件事沒辦法自動化,我試過用模型自己選,結果它選得太保守,什麼都想留著。
我認真評估過「動態工具載入」:一開始只宣告三個工具(其中一個是 search_tool),模型需要什麼能力時先搜尋,找到之後再要求載入。
聽起來很優雅,實際上有兩個障礙。
第一,多一輪往返。 模型要先呼叫 search_tool、看結果、再呼叫真正的工具。多一輪代表多一次完整的 context 傳輸,如果那次搜尋沒找到想要的,你可能連續浪費三輪。省下來的 token 一下就吐回去了。
第二,協定上的麻煩。 MCP 有 notifications/tools/list_changed 可以通知清單變更,但客戶端支不支援、支援得多好,是另一回事。你會綁死在特定客戶端的行為上。
我最後的判斷是:對絕大多數場景,靜態策展就夠了。當你的工具數在 5 到 20 之間,動態載入省下的錢還不夠付它自己的複雜度。
這個方向要到工具數量真的爆炸(幾百個、跨多個 server)才值得投資,而那時候你該問的是為什麼會有幾百個工具。
做這輪優化的時候,我順便處理了幾個累積下來的問題,這些可能你也有:
重複的工具。 我有三個功能幾乎一樣的搜尋工具,是不同時期加的。模型看到三個相似選項時,選擇會變得不穩定,同樣的問題有時呼叫 A 有時呼叫 B。合併成一個之後,行為一致多了。
永遠沒被用過的工具。 前面統計出五十幾個零呼叫。我沒有全刪,先做的是「從預設策展裡拿掉」,需要的角色才掛回去。留著是因為有些工具是給人手動觸發用的,不是給模型用的。
參數太自由的工具。 一個 query 參數收自由字串的工具,模型會發明各種格式。改成 enum 或結構化參數之後,錯誤呼叫大幅減少。能列舉就列舉,這件事我在 Day 7 說過一次,值得再說一次。
策展會讓 agent 變窄。 這是必然的。一個只有五個工具的 agent,遇到沒預期的狀況就是卡住。你要在「便宜且穩定」和「萬用但昂貴」之間選,而多數自動化任務應該選前者。
維護成本轉移了。 靜態策展表要有人維護。加新工具的人要知道該掛進哪些 preset,忘記掛的話,那個工具就等於不存在。我的處理方式是讓 preset 表跟工具定義放在同一個檔案,改一個會看到另一個。
統計數據會誤導。 「三個月零呼叫」不代表沒用。有可能是描述寫爛了沒被呼叫(該修描述),也可能是它負責處理罕見但重要的情況(該留著)。我拿掉一個零呼叫的工具之後,兩週後遇到一次真的需要它的狀況,只好加回去。看數據要配合判斷。
明天換個方向:把 Codex 和 Gemini CLI 掛在同一個介面下。
這件事的動機很實際:當某一家的服務出問題時,我的 agent 還能繼續工作。


 iThome鐵人賽
 看影片追技術