
我做的第一版記憶,是很標準的那種:對話存進向量資料庫,下次需要時做相似度搜尋,取前五筆塞進 prompt。
它在展示的時候表現很好。上線兩個月後,出現這種對話:
我:這個專案的部署方式是什麼?
agent:用 Docker Compose 部署,設定檔在 deploy/ 目錄下。
那是三個月前的做法。中間我們換過兩次,現在用的是完全不同的方式。而舊的那筆記憶因為寫得詳細、用詞跟問題高度相似,穩定地排在檢索結果第一名。
新的事實進來了,舊的沒有離開。 這就是我認為向量檢索解決不了記憶問題的原因。
先把兩件事分開。
檢索要回答的是:「在這堆文件裡,哪些跟這個查詢最相關?」它的假設是文件庫是靜態的、彼此獨立的、都是有效的。
記憶要回答的是:「以我現在所知,這件事是什麼?」它必須處理:
| 記憶需要的 | 純檢索有沒有 |
|---|---|
| 舊事實被新事實推翻 | 沒有 |
| 重要的事記久一點 | 沒有 |
| 不重要的事會忘掉 | 沒有 |
| 分辨「我聽說的」和「我做過的」 | 沒有 |
| 分辨「當時是這樣」和「現在是這樣」 | 沒有 |
檢索把所有文件當成平等且永恆的。記憶必須有時間軸、有權重、有生死。
我現在的記憶分兩層,這個分法來自認知科學裡的老概念,但實務上非常好用。
情節記憶(episodic):發生過什麼事。有時間、有場景、可能永遠不會再被用到。「8 月 14 日下午,使用者回報登入失敗,查出來是憑證過期。」
語意記憶(semantic):從事情裡萃取出來的知識。沒有特定時間、可重複套用。「這個系統的憑證有效期是 30 天,過期的徵兆是登入失敗。」
差別在哪?情節記憶會不斷累積,而且大部分不會再被用到。語意記憶數量少很多,但每一條的價值高很多。
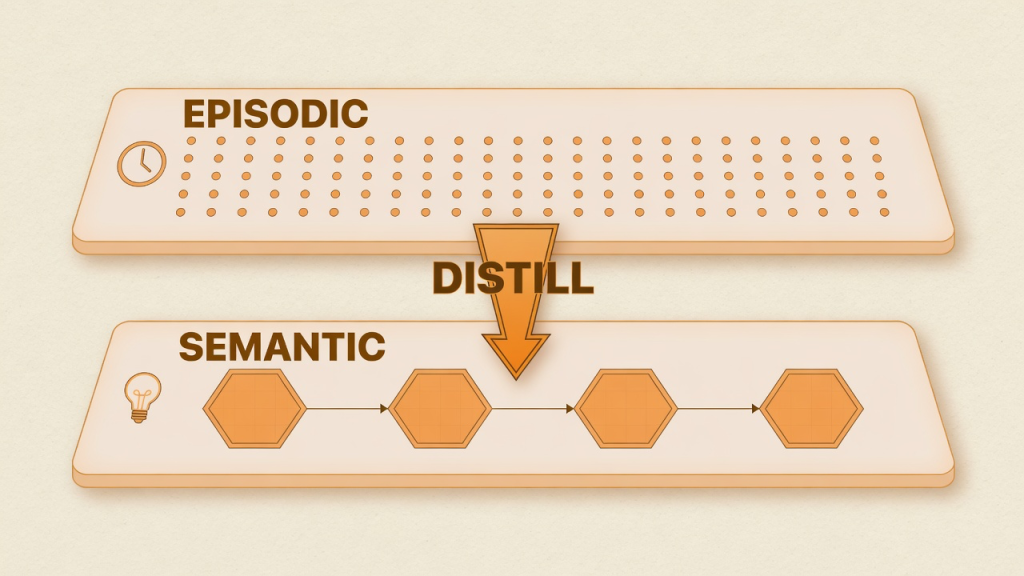
上面那條擠滿小點的是情節層,寫入便宜、數量龐大、多數再也用不到。下面那幾個節點是語意層,從情節裡蒸餾出來,數量少但每一條都可重複套用。
實務上的處理方式也不一樣:
# 情節:寫入便宜,檢索靠時間 + 關鍵字,會定期歸檔
store.append_episodic(
    content="使用者回報登入失敗,查出憑證過期,已更新",
    tags=["incident", "auth"],
)

# 語意:寫入要經過檢查,檢索要精準,很少刪除
store.upsert_semantic(
    subject="系統憑證",
    predicate="有效期",
    object="30 天",
    confidence=0.9,
)
語意記憶用 (主詞, 謂詞, 受詞) 三元組是有原因的,明天和後天會用到:有了這三個欄位,才能自動偵測「同一件事被講了不同的答案」。
用 SQLite 加全文檢索,不需要向量資料庫。我知道這聽起來很復古,但對絕大多數 agent 場景,這樣就夠了,而且好除錯太多。
import sqlite3, json, time

SCHEMA = """
CREATE TABLE IF NOT EXISTS memories (
    id          INTEGER PRIMARY KEY AUTOINCREMENT,
    agent_id    TEXT NOT NULL,
    layer       TEXT NOT NULL,           -- episodic / semantic
    content     TEXT NOT NULL,
    importance  REAL DEFAULT 3.0,        -- 1..5
    access_count INTEGER DEFAULT 0,
    created_at  REAL NOT NULL,
    accessed_at REAL NOT NULL,
    -- 語意層專用:用來偵測事實衝突
    subject     TEXT,
    predicate   TEXT,
    object      TEXT,
    -- 時效
    valid_from  REAL,
    valid_until REAL,                    -- NULL = 現在仍有效
    superseded_by INTEGER,               -- 被哪一筆取代
    metadata    TEXT DEFAULT '{}'
);
CREATE INDEX IF NOT EXISTS idx_spo
    ON memories(agent_id, subject, predicate) WHERE layer='semantic';
CREATE INDEX IF NOT EXISTS idx_valid
    ON memories(agent_id, valid_until);

CREATE VIRTUAL TABLE IF NOT EXISTS memories_fts
    USING fts5(content, content=memories, content_rowid=id, tokenize='trigram');
"""
三個設計決定要說明。
tokenize='trigram'。 這是給中文用的。SQLite 的預設分詞器碰到中文會把整句當成一個 token,搜尋幾乎無效。trigram 用三字元滑動窗,中文英文都能搜。缺點是索引比較大,我覺得值得。
valid_until 而不是刪除。 事實被推翻時不刪除舊的,標記它的有效期結束。這樣你才能回答「上個月的規定是什麼」這種問題,也才能追查一個錯誤結論的來源。
superseded_by 形成鏈。 從最新的一筆可以往回追整條演變史。這在除錯的時候救過我好幾次。
有了資料,檢索不能只看相關度。經典的做法是三個維度加權,我用的權重是實測調出來的:
def search(self, agent_id: str, query: str, limit: int = 5) -> list[dict]:
    now = time.time()
    rows = self.db.execute("""
        SELECT m.id, m.content, m.importance, m.access_count,
               m.accessed_at, bm25(memories_fts) AS rank
        FROM memories_fts
        JOIN memories m ON m.id = memories_fts.rowid
        WHERE memories_fts MATCH ?
          AND m.agent_id = ?
          AND (m.valid_until IS NULL OR m.valid_until > ?)   -- 只取現在有效的
        ORDER BY rank LIMIT 50
    """, (query, agent_id, now)).fetchall()

    scored = []
    for r in rows:
        relevance = 1.0 / (1.0 + abs(r["rank"]))        # bm25 越小越相關
        recency   = retrievability(r, now)               # 明天講這個
        importance = r["importance"] / 5.0
        score = 0.55 * relevance + 0.25 * recency + 0.20 * importance
        scored.append((score, r))

    scored.sort(key=lambda x: -x[0])
    top = [r for _, r in scored[:limit]]
    self._touch(top, now)          # 被取用過要記錄,這會影響下次排序
    return top
WHERE valid_until IS NULL OR valid_until > now 這一行,就是開頭那個 bug 的解法。過期的事實不會出現在檢索結果裡,除非你明確要查歷史。
_touch 那一行也很重要:被取用過的記憶要留下痕跡。這是明天遺忘曲線的輸入。
講了這麼多,向量檢索當然有它的位置。我的判斷是:
該用向量: 你的查詢和內容用詞差很多(使用者問「怎麼開機」,文件寫「啟動流程」),而且內容量大到關鍵字組合失控。
不該用向量: 內容量在幾千筆以內、查詢詞和內容用詞接近、你需要精確的時效與衝突處理。
我目前的做法是全文檢索當主力,另外加一層圖檢索補洞(Day 16 會講)。向量我試過,在我的資料量下沒有明顯優勢,但多了一個要維護的元件跟一個 embedding 成本。
這是我的場景的結論,你的場景不見得一樣。重點是先問你的記憶需要什麼,再選工具,不要因為向量資料庫是預設答案就直接用。
兩層分開存,寫入路徑變複雜。 每次要決定這件事屬於哪一層。我一開始讓模型自己判斷,它把什麼都寫成語意記憶,因為那聽起來比較重要。後來改成規則優先、模型輔助。
trigram 索引很肥。 我的記憶庫索引大小大約是內容的兩倍。以文字資料來說絕對值不大,但如果你要存幾百萬筆,要重新評估。
「現在有效」的查詢會漏掉有用的歷史。 有些問題就是要查舊的。我的做法是留一個明確的 get_history(subject, predicate) 介面,讓需要的時候能查,但預設路徑只給現況。預設值要服務多數情況。
明天處理一個更基本的問題:記憶要不要遺忘?
我的答案是要,而且遺忘的規則可以直接借用一條一百四十年前的心理學曲線。


 iThome鐵人賽
 看影片追技術