
上一篇我們看到,Dependency Graph 最麻煩的情況之一,就是出現循環。
例如:
A → B → C → A
如果箭頭代表:
前面的工作必須先完成,後面的工作才能開始
那麼這張 Graph 就會變成:
A 等 C
B 等 A
C 等 B
所有事情都在等待別人。
所以在安排工作以前,我們至少要先確認:
Dependency Graph 裡沒有循環
但沒有循環,只代表事情「有機會排得出來」。
它還沒有回答另一個更實際的問題:
到底應該按照什麼順序做?
假設今天有:
A → C
B → C
C → D
B → E
我們知道這些 dependency 沒有形成循環。
可是:
A 要先做?B 要先做?C 什麼時候才能做?D 和 E 又要放在哪裡?這就是今天要談的:
Topological Sort 拓樸排序
假設大學有四門課:
其中有一些先修規定:
也就是: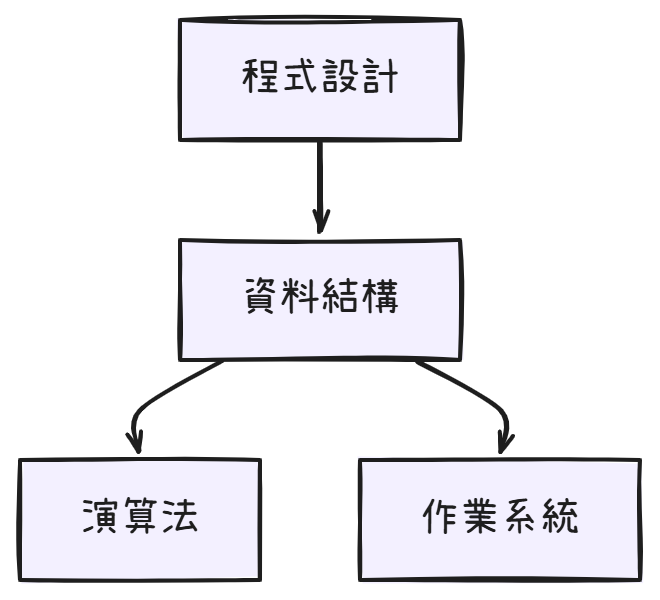
如果你直接排成:
演算法
→ 程式設計
→ 資料結構
→ 作業系統
顯然不行,因為修演算法之前,資料結構都還沒修完。
但:
程式設計
→ 資料結構
→ 演算法
→ 作業系統
這就可以,下面這個其實也可以:
程式設計
→ 資料結構
→ 作業系統
→ 演算法
為什麼?
因為 Graph 只規定:
資料結構 → 演算法
資料結構 → 作業系統
它沒有規定 演算法 → 作業系統,也沒有規定 作業系統 → 演算法,所以這兩門課誰先誰後都可以。
這裡開始出現拓樸排序最重要的特性:
答案不一定只有一個
看到 Sort,我們很容易聯想到一般排序:
4, 1, 3, 2
整理之後變成:
1, 2, 3, 4
這種排序通常是在比較:
1 < 2
2 < 3
3 < 4
但拓樸排序完全不是在比較:
A 和 B 誰比較大?
它真正處理的是:
哪些事情必須出現在另外一些事情之前?
例如:
A → C
B → C
C → D
代表:
A 必須在 C 前面
B 必須在 C 前面
C 必須在 D 前面
因此 A → B → C → D 是合法順序,但 B → A → C → D 也同樣合法。
因為 A 和 B 之間根本沒有 dependency。
所以 Topological Sort 做的是:
找出一個符合所有 dependency constraint 的順序
假設 Graph 是:
A → C
B → C
C → D
Graph 其實沒有直接告訴我們:
第一個做 A
第二個做 B
第三個做 C
第四個做 D
它只告訴我們:
A 要在 C 前面
B 要在 C 前面
C 要在 D 前面
也就是說:
Dependency Graph 描述的是限制,不是完整流程
沒有被 dependency 限制的部分,本來就可能有很多種合法安排。
拓樸排序的工作,就是把這些分散的限制整理成:
一個可以真的照著執行的順序
拓樸排序通常會跟一個縮寫一起出現DAG。
也就是:
Directed Acyclic Graph
拆開來看:
所以 DAG 就是:
沒有循環的有向圖
為什麼一定不能有循環?
上一篇其實已經回答過了。
如果:
A → B
B → C
C → A
那麼我們會同時要求:
A 在 B 前面
B 在 C 前面
C 又在 A 前面
不管怎麼排,都不可能全部滿足。
所以:
只要 Dependency Graph 裡存在循環,就不存在合法的拓樸順序
這也是為什麼上一篇先談 Cycle。
因為在問要怎麼排序以前,我們必須先知道:
這些 dependency 到底有沒有可能同時成立?
回到:
A → C
B → C
C → D
B → E
我們先不要想完整排序,先問一個上一篇最後留下來的問題:
現在有哪些 node 不需要等待任何人?
A 沒有任何前置 dependency,B 也沒有。
所以 A 或 B 都可以立刻開始,但 C 不行。
因為:
A → C
B → C
代表 C 必須等 A 和 B 都完成。
同時 D 也不能開始。E 則必須等 B → E,所以一開始真正可以選擇的只有 A 跟 B。
這其實已經給了我們一個很重要的拓樸排序直覺:
每次先找出目前沒有未完成 dependency 的 node
Day 13 我們提過:
A → B
A 而言是一條:outgoing edge
B 而言是一條:incoming edge
如果我們數一個 node 有多少條 incoming edge,這個數量就稱為:
in-degree
例如:
A → C
B → C
C → D
B → E
每個 node 的 in-degree 是:
A: 0
B: 0
C: 2
D: 1
E: 1
在 Dependency Graph 裡,可以把它直覺理解成:
目前還有多少個前置 dependency 指向這個工作
所以 in-degree = 0 就代表:
目前沒有任何事情需要先等,可以開始執行
所以一開始:
A: 0
B: 0
A 和 B 都是合法起點。
假設我們先做 A。
因為 A → C,A 完成之後,C 就少了一個尚未完成的 dependency。
原本 C: 2 現在變成 C: 1。
但還不能執行 C,因為 B 還沒完成。
接著我們完成 B。B 有兩條 outgoing edge:
B → C
B → E
因此:
C: 1 → 0
E: 1 → 0
現在 C 跟 E 都可以開始。
假設我們先處理 E,再處理 C。
完成 C 之後:
D: 1 → 0
於是 D 最後也能執行。
最後可能得到 A → B → E → C → D 這是一個合法順序,但 B → A → C → D → E 其實能合法。
重點不在於一定要找到某一個固定答案,而是:
不能違反任何 dependency
前面我們學 Queue 時,強調的是先來先處理 FIFO。
現在它又可以成為另一個演算法的拼圖。
假設一開始:
A: 0
B: 0
C: 2
D: 1
E: 1
我們可以把所有 in-degree = 0 的 node 放進 Queue:
Queue

[A, B]
取出 A:
Queue

[B]
處理它的 outgoing edge。
再取出 B:
Queue

[]
處理完 B 之後:
C: 0
E: 0
於是:
Queue

[C, E]
接著再繼續處理。
所以整個流程可以想成:
找出 in-degree = 0 的 node
↓
放進 Queue
↓
取出一個 node
↓
視為它已完成
↓
降低相鄰 node 的 in-degree
↓
如果有人變成 0,就加入 Queue
↓
重複
這種做法通常稱為:
Kahn's Algorithm (Kahn 演算法)
今天不需要急著記完整程式碼。
真正重要的是理解它背後的意思:
每完成一個工作,就解除它對後續工作的 dependency
這裡又會重新連回上一篇的 Cycle。
假設:
A → B
B → C
C → A
它們的 in-degree 是:
A: 1
B: 1
C: 1
一開始就沒有 in-degree = 0 的 node。
也就是說沒有任何事情可以先開始。
如果 Graph 更大,也可能一開始能先處理一些 node,但做到某個階段後:
Queue = []
可是 Graph 裡還有 node 沒有被處理。
這就代表:
剩下的 dependency 裡存在循環
所以拓樸排序很有趣的一點是它不只能幫我們找順序。
還能反過來告訴我們:
這張 Dependency Graph 根本排不出合法順序
如果最後:
處理完成的 node 數量 = 所有 node 的數量
就代表成功找到一個 Topological Order。
反過來,如果:
處理完成的 node 數量 < 所有 node 的數量
代表某些 node 永遠沒有機會變成 in-degree = 0,通常也就代表 Graph 中存在循環。
拓樸排序並不是只存在於演算法題目。
假設一個 build process 是: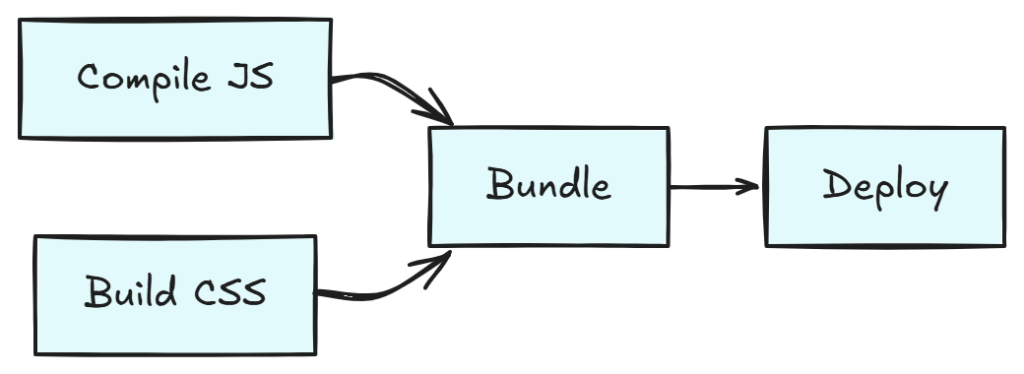
Compile JS 和 Build CSS 彼此沒有 dependency。
所以它們可以先後執行,甚至平行執行。
但 Bundle 一定要等 Compile JS 和 Build CSS 都完成之後才可以開始。
因此 Build system 真正需要知道的是:
哪些 task 現在已經沒有尚未完成的 dependency?
這跟剛剛找 in-degree = 0 的 node,概念上就是同一件事。
拓樸排序不是按照名稱或數值大小排序。
它處理的是一張沒有循環的有向圖,也就是 DAG,並嘗試找出:
一個不違反任何 dependency 的執行順序
Kahn's Algorithm 的概念可以整理成:
找到 in-degree = 0 的 Node
↓
表示它目前沒有尚未完成的 dependency
↓
處理這個 Node
↓
降低它所指向 Node 的 in-degree
↓
找出新出現的 in-degree = 0 Node
因為同一時間可能有多個 Node 可以開始,所以 Topological Order 不一定只有一個。
只要最後得到的順序沒有違反任何 dependency,就是合法結果。
如果過程中已經沒有 Node 可以處理,卻仍有 Node 尚未完成,就表示剩下的 dependency 存在循環。
這篇文章值得記住的是:
Dependency 描述限制,拓樸排序則在這些限制中找出一個可執行順序
大學課程、Build system 和工作流程,都可以形成 Dependency Graph。
其實我們每天使用的 JavaScript 專案也一樣。
當我們執行:
npm install
一個 package 可能依賴其他 package,而那些 package 又可能擁有自己的 dependency。
從資料夾看,node_modules 好像是一棵 Tree。
但 package 之間真正的 dependency relationship,也是一棵 Tree 嗎?
下一篇,我們就把 Dependency Graph 帶回 npm 專案。


 iThome鐵人賽
 看影片追技術