
這 30 天,我們談過很多看起來完全不同的問題。
排隊時,我們用了 Queue。
復原操作時,我們看到了 Stack。
找資料時,我們談 Hash Map。
捷運路線讓我們認識 Graph。
導航帶出了最短路徑。
工作安排讓我們碰到排程(Scheduling)。
有限容量帶出了 Knapsack 與 Bin Packing。
而當所有條件開始互相牽制時,我們又談到限制條件、最佳化,以及為什麼工程師有時候必須接受一個「夠好的答案」。
表面上看起來,這些問題彼此差異很大。
但如果回頭看整個系列,我們其實一直在做同一件事情:
找到問題真正的結構
今天是最後一天,我們不再找新的生活例子,而是回到很多前端工程師每天都在接觸的一個東西:
狀態(State)
假設我們有一個購物車,裡面有幾個基本資料:
price
quantity
discount
taxRate
然後系統會根據這些資料計算:
subtotal
total
例如:
subtotal = price × quantity

total = (subtotal - discount) × (1 + taxRate)
如果只看程式碼,我們可能會把它理解成幾個變數與幾個計算。
但如果把「誰依賴誰」畫出來,事情會開始變得不一樣: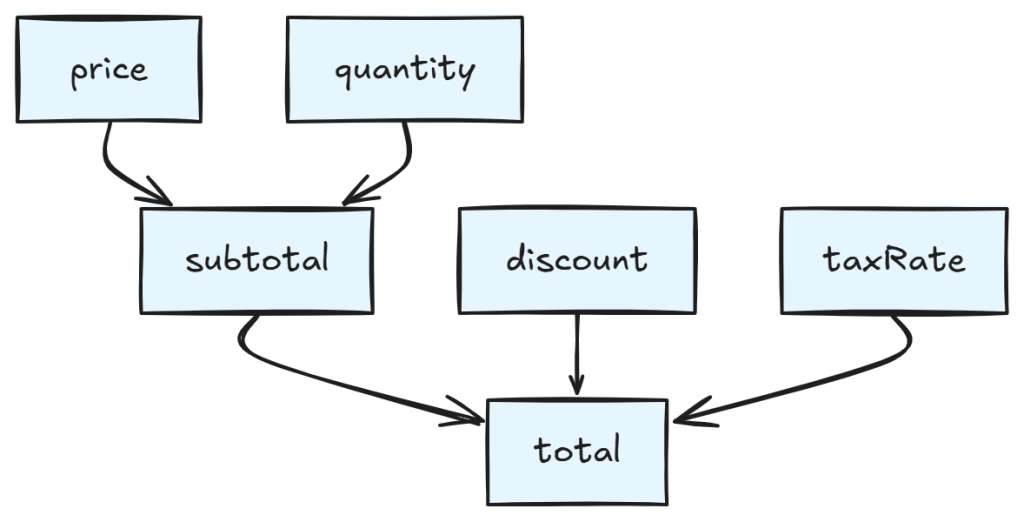
現在先不要想 React、Vue、Angular,也不要想任何框架。
只看這張圖,它比較像什麼?
是元件樹(Component Tree)嗎?
還是:
一張依賴圖(Dependency Graph)?
在系列前半段,我們第一次談 Graph 時曾經說過:
一張 Graph 最基本的元素是:
節點代表某個東西。
邊代表兩個東西之間的關係。
例如捷運 台北車站 ─── 西門 站點是節點。
兩個站之間可以通行,是邊。
到了有向圖(Directed Graph),我們又多了一件事:
關係可能具有方向
例如 A → B 代表的不是單純「A 跟 B 有關」,還傳達了 B 依賴 A 的訊息。
現在重新看剛才的購物車 price → subtotal 意思就是:
subtotal的值依賴price
而 subtotal → total 代表:
total又依賴subtotal
這就是我們從 Day 13 開始建立的:
依賴關係(Dependency)
假設原本:
price = 100
quantity = 2
discount = 20
taxRate = 0.05
那麼:
subtotal = 200
total = 189
現在 price 從 100 變成 120,實際發生的流程是:
price
  ↓
subtotal
  ↓
total
這正是 Day 17 談過的:
傳播(Propagation)
一個節點發生變化之後,影響可能會沿著依賴關係往下游傳遞。
A → B → C 如果 A 改變,B 可能受到影響。
而 B 一旦改變,C 也可能受到影響。
所以 Reactive System 很重要的一個問題其實就是:
當某個節點改變時,哪些下游節點需要被重新處理?
此時比「怎麼重新渲染元件」更前面的一層是:
哪些資料已經不再可信?
假設現在:
price → subtotal → total
price 改變之後,我們甚至不一定需要立刻重新計算所有東西,我們可以先知道 subtotal,已經不能保證是最新的。
既然 subtotal 可能過期,那麼 total 也可能已經過期。
所以系統可以先做的事情是:
price 改變

subtotal → 已過期

total → 已過期
這就是:
失效標記(Invalidation)
它和「重新計算」其實是兩件不同的事情。
失效標記回答的是:
哪些值現在已經不能相信?
重新計算回答的才是:
那我什麼時候要重新把它算出來?
這也是為什麼一個 Reactive System 並不只是 值改變 → 執行回呼函式。
困難的地方在於:
系統必須知道依賴關係
否則它根本不知道 price 改變之後,到底有哪些東西受到影響。
假設我們寫:
const subtotal = computed(() => {
  return price() * quantity()
})

const total = computed(() => {
  return (subtotal() - discount()) * (1 + taxRate())
})
從程式表面上看,我們只是執行了一個函式。
但 Reactive System 真正想知道的其實是:
subtotal讀取了誰?
當 subtotal 執行期間讀到了:
price
quantity
系統就可以建立:
price ───────→ subtotal
quantity ────→ subtotal
而 total 讀取了 subtotal、discount 與 taxRate,因此系統還可以建立:
subtotal ────→ total
discount ────→ total
taxRate ─────→ total
於是依賴圖就逐漸形成了。
這和我們 Day 8 談 Graph 的表示方式時,其實是同一件事情。
紙上可以直接畫 A → B 但電腦裡不能真的存一條「線」。
系統必須想辦法記錄 A 的下游有誰? 或者 B 依賴哪些上游?
例如概念上可能像:
price:
  下游訂閱者:
    - subtotal
以及:
subtotal:
  上游依賴:
    - price
    - quantity
到了這裡,Reactive System 看起來是不是已經越來越不像單純的「狀態管理」?
因為我們真正維護的,其實是:
狀態之間的關係
前端工程師非常習慣把畫面想成一棵元件樹:
App
├─ Header
├─ ProductPage
│  ├─ ProductInfo
│  └─ Cart
└─ Footer
這描述的是:
UI 的結構
但資料之間的依賴關係不一定遵守這棵樹。
例如 user 可能同時影響:
Header
Checkout
Profile
Analytics
甚至某個衍生值 shippingFee 可能同時依賴:
cartTotal
userLocation
membershipLevel
promotion
這些關係很難自然畫成一棵樹,反而更接近:
cartTotal ────────┐
userLocation ─────┤
membershipLevel ──┼→ shippingFee
promotion ────────┘
這就是一張 Graph,所以元件樹描述的是:
UI 怎麼組成
而依賴圖描述的是:
資料與計算之間誰依賴誰
這兩件事情可以相關,但它們不是同一件事情。
既然 Reactive System 是一張 Graph,那我們前面談過的 Graph 問題自然也可能重新出現。
例如:
A → B
B → A
這是什麼?
正是 Day 14 談過的:
循環(Cycle)
假設:
A = B + 1
B = A + 1
那系統要先算誰?
如果 A 需要 B,B 又需要 A,我們就重新遇到當時那個問題:
每個人都在等另一個人
甚至在 Effect 中,循環不一定會直接寫成:
A 依賴 B
B 依賴 A
它可能是:
A 改變
  ↓
Effect 1
  ↓
寫入 B
  ↓
Effect 2
  ↓
寫入 A
最後形成:
A
↓
Effect 1
↓
B
↓
Effect 2
↓
A
看起來像完全不同的反應式問題。
但如果把框架的 API 名稱全部拿掉,它其實還是我們之前看過的:
Graph 中的循環
Day 18 我們談過:
Graph 本身也可能會改變
這就是動態圖(Dynamic Graph),Reactive System 裡也經常發生同樣的事情。
例如:
const result = computed(() => {
  if (loggedIn()) {
    return user().name
  }

  return 'Guest'
})
第一次執行時:
loggedIn = false
依賴關係可能只有 loggedIn → result,因為程式根本沒有讀取 user,但下一次:
loggedIn = true
執行路徑改變了,現在依賴關係可能變成:
loggedIn → result
user ─────→ result
也就是說:
Graph 的邊本身會隨著程式執行改變
再下一次 loggedIn 變回 false:
user → result
這條依賴關係甚至可能又消失,所以一個 Reactive System 不只是維護 Graph。
它維護的是:
一張會隨程式執行持續改變的依賴圖
這就是為什麼依賴追蹤、清理與解除連結等機制會變得重要。
因為舊的邊如果沒有移除,Graph 描述的就不再是現在真正的依賴關係。
到這裡,我們終於可以把前端熟悉的幾個名詞放回來。
如果只看 API,我們可能會把它們當成三種框架功能。
但從 Graph 的角度看,它們可以被理解成:
依賴圖中具有不同責任的節點
例如:Signal 通常是 Graph 中的來源節點。
它保存某個可以改變的狀態:
price
quantity
taxRate
Computed 通常是一個衍生節點。
它從其他節點取得資料,計算出新的值:
price
   ↓
subtotal
它會依賴上游節點,也可能成為其他下游節點的依賴來源。
例如:price → subtotal → total,所以 subtotal 同時使用上游的 price 與 quantity,也為下游的 total 提供資料。
而 Effect 則常可視為依賴圖的下游終點,它通常不會產生可供其他節點依賴的新值。
而是在依賴關係改變之後,執行某個副作用:
狀態
  ↓
Effect
  ↓
DOM
或者:
狀態
  ↓
Effect
  ↓
console
甚至:
狀態
  ↓
Effect
  ↓
外部系統
所以從這個角度看:
不是三個彼此獨立的 API,它們共同存在於同一張:
反應式依賴圖(Reactive Dependency Graph)
只是每一種節點的責任不同。
很多人第一次接觸反應式機制(reactivity),會把它理解成 狀態改變 → 畫面更新 這當然沒有錯。
但這其實只是其中一種用途,如果依賴圖是:
price
  ↓
subtotal
  ↓
total
total 更新之後,可能:
total
↓
DOM
也可能:
total
↓
紀錄日誌
也可能:
total
↓
本地儲存
甚至:
total
↓
另一個計算
因此,Reactive System 關心的不只是:
如何重新渲染 UI?
更底層的問題是:
當某個資訊改變時,變化應該沿著哪些依賴關係傳遞?
畫面更新只是這張依賴圖某些路徑最後產生的副作用之一。
Day 1 時,我們問了一個問題:
如果所有資料都可以塞進 Array,為什麼還需要 Queue、Tree、Graph?
那時候我們得到的答案是:
資料結構不只存放資料,也表達我們想保留的關係與操作規則
排隊時,最重要的是先來後到。
所以 Queue 很適合。
復原操作關心最後發生的事情。
所以 Stack 很自然。
組織架構具有階層關係。
所以 Tree 很直覺。
捷運站之間可以任意連接。
所以 Graph 很合理。
而 Reactive System 真正關心的是:
誰依賴誰?
一個東西改變之後,會影響誰?
如果現在要描述的是狀態與計算如何互相影響,而不是 UI 如何組成,那麼最自然的表示方式就是:
依賴圖
再回頭看最開始的購物車: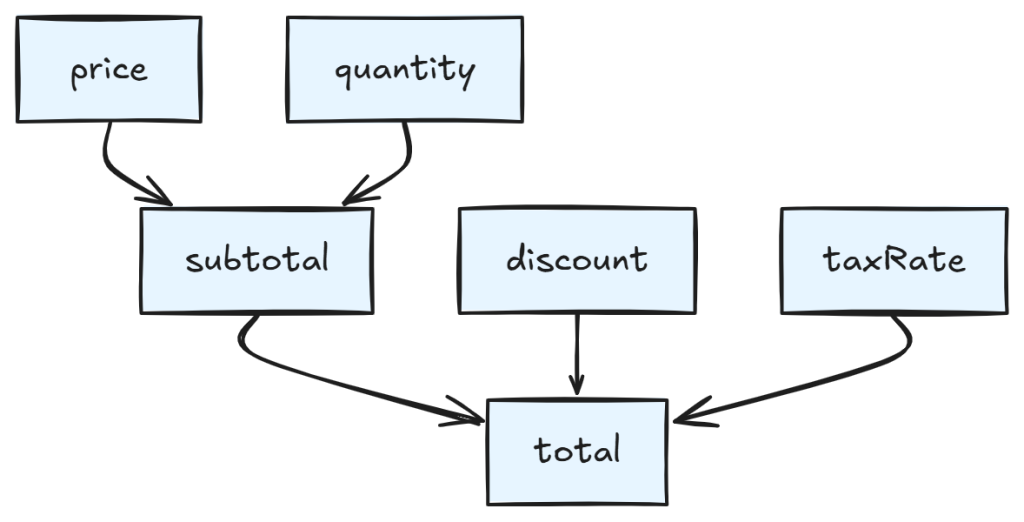
第三章談過的 Graph 觀念,也在這裡重新聚合起來:
於是 Signal、Computed、Effect 不再只是幾個需要背下來的 API 名稱,而是同一個基本模型中具有不同責任的節點。
我們花了 30 天學的不只是:
這些名稱都是工具,貫穿整個系列的是一種更基本的能力:
如何看見一個問題背後真正的結構,再決定應該如何處理它
有時候問題的核心是順序、有時候是階層關係、有時候是資料之間的連結。
有時候是依賴關係、有時候是有限資源、有時候是多個彼此衝突的限制條件。
而只有當問題被描述清楚之後,資料結構與演算法才真正有意義。
今天,AI 已經可以快速協助我們完成許多實作。
它會寫 Queue、會寫 BFS、會寫 Dijkstra,也能協助我們建立 Reactive System。
但在要求 AI 產生答案之前,我們仍然必須先釐清:
這些問題都發生在實作之前。
也因此,我們真正需要培養的能力比以前更往前移了一步。
花時間去理解:
我現在到底在解什麼問題?
因為 AI 可以幫我們寫出答案。
但我們仍然必須知道,它到底回答了什麼問題


 iThome鐵人賽
 看影片追技術