
前面我們一直在操作 Pod、Deployment、Service,但別忘了:
Pod 最後一定是跑在某一台 Node 上。
例如現在 Cluster 有三台 Worker:
worker1
worker2
worker3
API 有 3 個 replicas,Scheduler 可能把它們分配成:
worker1
└── API Pod 1

worker2
└── API Pod 2

worker3
└── API Pod 3
但 Production 的 Server 不可能永遠不用維護。
例如我們可能需要:
OS Patch
Kernel Update
Kubernetes Upgrade
硬體維修
更換 VM / Instance
假設今天要維護:
worker2
問題就來了。
上面還有:
API Pod 2
總不能直接把 Server 關掉。
所以 Kubernetes 的想法是:
先停止把新的工作派過來,再把原本能搬走的工作移走,最後才維護 Node。
流程就是:
確認 Node 上有什麼
        ↓
cordon
        ↓
drain
        ↓
maintenance
        ↓
uncordon
這邊先給的定義,先有個粗步概念即可,下面會再一一解釋清楚!
用來將 Node 標記成不可調度 (SchedulingDisabled)。阻止任何新的 Pod 被調度(schedule)到該節點上。
kubectl cordon <node-name>
kubectl uncordon <node-name> 恢復調度。用來將 Node 標記成不可調度 (SchedulingDisabled)。用於安全驅逐 (evict) 節點上的 Pod。本質上就是「先標記 cordon 避免新負載搶入,再透過 Eviction API 安全逐出舊 Pod」。
cordon,接著逐一安全驅逐該節點上所有的 Pod,讓控制器(如 Deployment、StatefulSet)在其他健康的節點上重建這些 Pod。kubectl drain <node-name> --ignore-daemonsets --delete-emptydir-data
** cordon, drain 比較表**
| 動作 | 是否標記不可調度? | 是否驅逐現有 Pod? | 適用情境 |
|---|---|---|---|
cordon |
是 | 否 | 觀察節點狀態、暫停負載流入,但暫不中斷現有服務 |
drain |
是 | 是 | 節點需維修、更換硬體、重開機或做節點系統升級 |
標準維修流程通常為:kubectl drain <node> $\rightarrow$ 進行節點維護 $\rightarrow$ kubectl uncordon <node>。
接下來就要實際進行實作啦
再說明一次前面提到的情境
今天我們要維護 Worker2,但他上面還有pod在運行
又不能直接關掉,所以我們現在就是必須做兩件事情:
流程就是:
確認 Node 上有什麼
        ↓
cordon
        ↓
drain
        ↓
maintenance
        ↓
uncordon
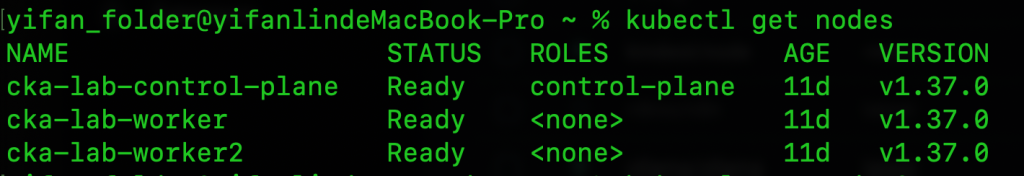
維護之前先看:
先看一下 NodeName
kubectl get nodes
kubectl get pods \
  -A \
  --field-selector spec.nodeName=cka-lab-worker2 \
  -o wide
會看到: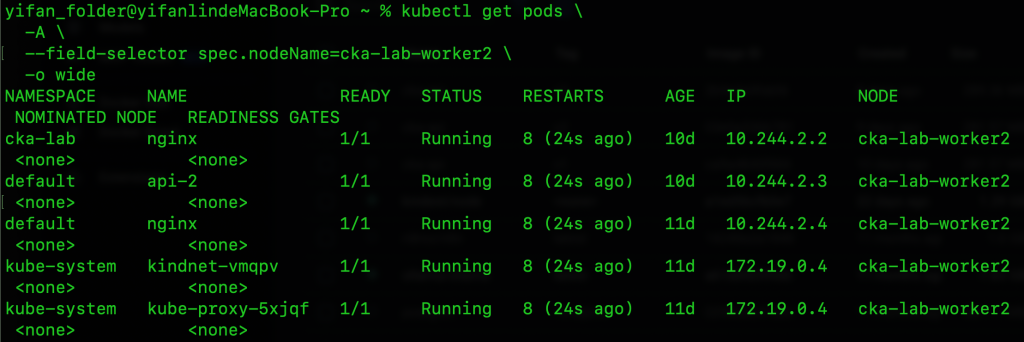
為什麼不能直接 drain?
因為這些 Pod 不一定都是同一種類型。
例如:
API Pod
通常是 Deployment 管理的,刪掉之後可以在其他 Node 重建。
但是 PostgreSQL 如果使用 Local PersistentVolume:
PostgreSQL Pod
        ↓
資料綁在 worker2 的硬碟
那就不能很單純地說:
搬去 worker1 就好
因為資料可能根本不在 worker1。
所以維護 Node 前第一個觀念是:
先確認哪些東西可以搬,哪些東西跟這台 Node 有特殊關係。
假設確定今天要維護:
cka-lab-worker2
先執行:
kubectl cordon cka-lab-worker2
這時:
kubectl get nodes
會看到:
cka-lab-worker2 Ready,SchedulingDisabled
這個 SchedulingDisabled 很重要。
它代表:
Scheduler 暫時不要再把新的 Pod 放到這台 Node。
但是原本上面的 Pod:
API Pod
Redis Pod
還是繼續跑。
所以 cordon 可以想成:
旅館要準備整修
先在門口掛:
今天不再接受新客人
但是:
原本住在裡面的客人
還沒有被趕出去。
所以:
cordon = 不再接新的 Pod
不是:
cordon = 把 Pod 刪掉
接下來才執行:
kubectl drain \
  cka-lab-worker2 \
  --ignore-daemonsets \
  --delete-emptydir-data
drain 可以理解成:
準備把這台 Node 清空,讓它可以安全維護。
假設原本:
worker2
└── API Pod 2
API Pod 2 是 Deployment 管理的。
drain 之後:
API Pod 2
↓
被 Evict
這裡的 Evict 可以先簡單理解成:
請這個 Pod 正常離開這台 Node。
Pod 消失後,Deployment 會發現:
我明明設定 replicas: 3

現在怎麼只剩 2 個?
所以 Deployment 會自動建立新的 Pod。
Scheduler 再幫它找新的 Node:
worker1
或
worker3
最後可能變成:
worker1
├── API Pod 1
└── API Pod 4

worker3
└── API Pod 3
因此真正負責「補 Pod」的不是 drain。
而是:
Deployment / ReplicaSet
drain 只是把 Pod 請離這台 Node。
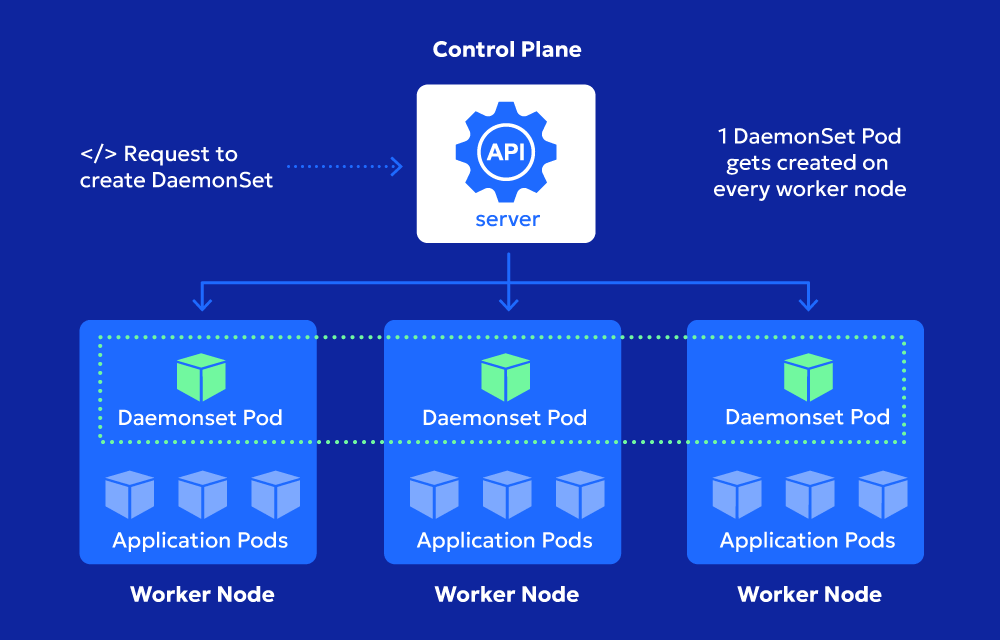
這裡最容易卡住。
Deployment 的概念通常是:
我要整個 Cluster 總共有幾個 Pod。
例如:
replicas: 3
代表:
整個 Cluster 有 3 個 API Pod
至於它們在哪些 Node,由 Scheduler 決定。
但是 DaemonSet 完全不同。
DaemonSet 的想法是:
每一台 Node 都應該跑一份這種 Pod。
最典型的例子就是:
Log Agent
Monitoring Agent
Node-level Network Agent
例如有三台 Node:
worker1
worker2
worker3
DaemonSet 可能變成:
worker1
└── Log Agent

worker2
└── Log Agent

worker3
└── Log Agent
不是因為你設定:
replicas: 3
而是因為:
有 3 台符合條件的 Node
所以 Kubernetes 自動讓每台都有一個。
--ignore-daemonsets?現在假設我們 drain:
worker2
上面有:
API Pod
Log Agent
API Pod 可以搬走。
但是 Log Agent 是 DaemonSet 管理的。
DaemonSet 本來的規則就是:
worker2 存在,就應該有一個 Log Agent。
所以如果 drain 把它當普通 Pod 刪掉:
Log Agent 被刪掉
DaemonSet Controller 馬上會想:
等等。

worker2 上怎麼沒有 Log Agent?
然後又建立一個。
變成:
刪除
↓
建立
↓
刪除
↓
建立
這顯然沒有意義。
所以 kubectl drain 看到 DaemonSet Pod 時,通常會要求你明確告訴它:
--ignore-daemonsets
意思不是:
把 DaemonSet 刪掉。
而是:
這些 DaemonSet Pod 不用搬,我知道它們存在,繼續處理其他 Pod 就好。
所以可以記:
Deployment Pod
→ drain 會嘗試 Evict

DaemonSet Pod
→ drain 不把它當普通 Workload 搬家
emptyDir 又是什麼?有些 Pod 需要一小塊暫存空間。
例如:
下載暫存檔
Cache
中間處理結果
這時可以使用:
emptyDir
例如:
Pod
└── emptyDir
    └── temp.txt
問題是:
emptyDir的資料是跟這個 Pod 綁在一起的。
當 Pod 被刪掉:
Pod 消失
↓
emptyDir 資料也消失
所以 drain 如果發現:
這個 Pod 有 emptyDir
它會提醒你:
如果我把 Pod 移走
這些資料會不見喔
如果你確定只是 Cache 或 Temporary Data,可以使用:
--delete-emptydir-data
意思就是:
我知道這些暫存資料會消失,可以接受。
但如果裡面是不能丟的資料,就不能亂加。
現在把整件事重新看一次。
原本:
worker2
├── API Pod
├── Worker Pod
└── Log Agent(DaemonSet)
先 cordon:
worker2
SchedulingDisabled
新的 Pod 不會再進來。
接著 drain:
API Pod
↓
Evict

Worker Pod
↓
Evict

Log Agent
↓
ignore DaemonSet
Deployment 會重新補:
API Pod
Worker Pod
到其他 Node。
最後可能變成:
worker2
└── Log Agent
這時主要 Application Workload 已經離開了,就可以開始維護 Node。
維護完成:
kubectl uncordon cka-lab-worker2
意思就是:
這台 Node 恢復營業,可以重新接受新的 Pod。
所以最重要的三個指令可以這樣記:
cordon
= 不要再派新的 Pod 進來

drain
= 把原本可以移動的 Pod 搬出去

uncordon
= 重新允許 Pod 進來
現在假設 API 有:
3 replicas
分布是:
worker1
└── API 1

worker2
├── API 2
└── API 3
今天我們 drain:
worker2
如果 API 2 和 API 3 同時被移走:
3 個 API
↓
瞬間剩 1 個
服務可能突然扛不住。
所以我們可以設定:
apiVersion: policy/v1
kind: PodDisruptionBudget

metadata:
  name: api-pdb
  namespace: cka-lab

spec:
  minAvailable: 2

  selector:
    matchLabels:
      app: api
意思是:
當 Kubernetes 在做可以控制的中斷時,至少要保留 2 個 Available API Pod。
所以如果現在:
API 1 Ready
API 2 Ready
API 3 Ready
可以先 Evict 一個。
變成:
2 個 Available
這時再想 Evict 第二個,PDB (PodDisruptionBudget) 就可能阻止:
等等。

再刪下去就只剩 1 個了。
等新的 API Pod 在其他 Node Ready:
Available 回到 3
才繼續下一個 Eviction。
這裡也要特別注意。
PDB 可以影響的主要是:
kubectl drain
這種 Kubernetes 知道、也有機會控制的中斷。
但是如果:
worker2 突然斷電
Kubernetes 根本沒有時間說:
等等,我 PDB 要 minAvailable: 2
Server 已經直接消失了。
所以:
PDB
比較像:
我們「主動維護」時,不要一次關掉太多服務。
而真正的 High Availability 還是要靠:
多 replicas
+
Pod 分散到不同 Node
+
健康檢查 (health check)
+
Anti-Affinity
今天不用背很多東西,只要建立這個畫面:
今天要維護 worker2
        ↓
先看看上面有什麼
        ↓
cordon
不准新的 Pod 進來
        ↓
drain
把 Deployment 等 Workload 搬走
        ↓
DaemonSet 不當一般 Pod 搬
        ↓
維護 Server
        ↓
uncordon
重新開放
而:
PodDisruptionBudget
就是在 drain 這種「可控制的中斷」裡,多加一道規則:
搬 Pod 可以,但不要一次把我的服務搬到沒人可以接 Request。
如果你只記一句話,可以記成:
cordon 是封路 (不再收人)
drain 是搬家 (舊住戶搬移)
DaemonSet 是每台 Node 都要有的駐點人員
PDB 是規定搬家時至少要留幾個人繼續上班


 iThome鐵人賽
 看影片追技術