
指揮中心流程完成後,我陸續將要修改的部分都使用這個流程處理,所有功能建置與調整的也差不多了。到了 7 月 1 日,系統就要交給第一批 UAT 人員。
從6/27-7/1中間只剩四天,將所有功能與驗證情境準備完成。
畫面能開、按鈕能按、Agent 回報完成,這些都還不夠。我在進 UAT 前先做了一件不能省的工作:把 13 項功能逐一操作,人工產出 JSON,再交給 Python 和舊系統的結果比對。
這 13 項不是跑一次指令就結束。每個功能都要準備輸入、操作舊版、操作新版、留下兩份輸出,看到差異後還要回頭判斷。那幾天最花時間的不是寫新功能,而是確認原本會動的東西,現在還是不是原來的樣子。
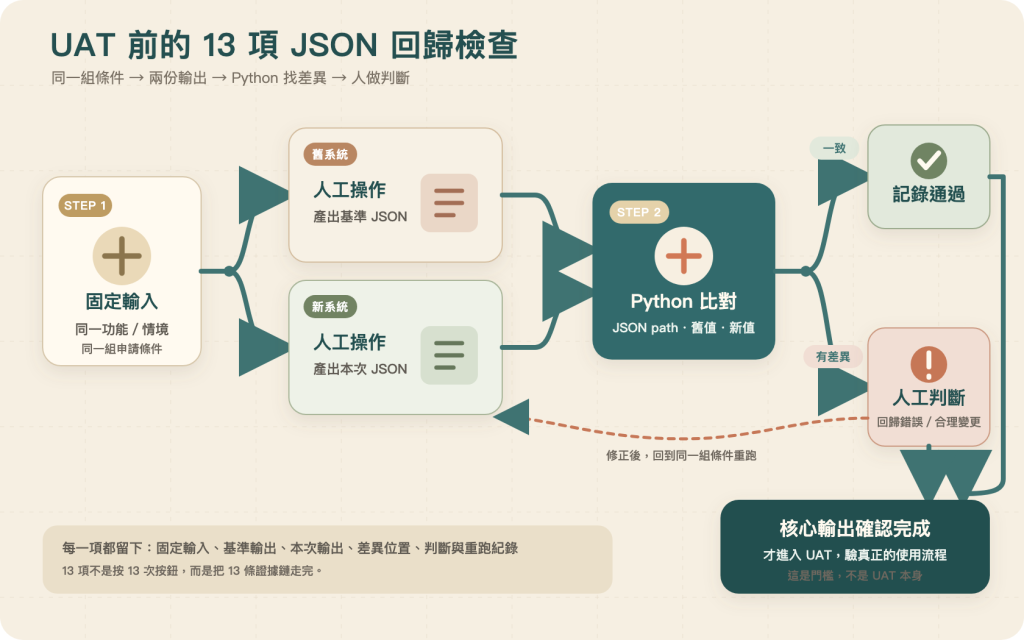
Day 03 記錄的是第二代剛累積到 12 項功能時,我開始不敢只看畫面。當時的做法很直接:Notebook 和 Web 使用同一組條件,各自產出 JSON,再用 Python 比對。
到了這次 UAT 前,驗證清單已經是 13 項。兩個數字對應不同階段;方法沒有大改,工作量卻完全不同。
開發途中挑一個功能比對,是在找眼前這次修改有沒有影響輸出。UAT 前把 13 項全部重跑,則是在確認整個版本能不能交給別人。只要中間任何一項出現無法解釋的差異,我就不能把它當成單純的測試雜訊跳過。
我把這次工作拆成固定流程:
準備同一組申請條件
  ├─ 在舊系統操作,人工產出基準 JSON
  └─ 在新系統操作,人工產出新版 JSON
             ↓
        交給 Python 比對
             ↓
  一致:記錄通過
  不一致:列出 JSON 路徑、舊值與新值
             ↓
        人工判斷差異原因
看起來只有幾個步驟。乘上 13 之後,就不是隨手檢查了。
每項功能的輸入條件不同。有些要先選環境與資料來源,有些要準備專案、帳號或權限,有些欄位還會依前一個選項改變。舊系統和新系統都要使用同一組條件,否則兩份 JSON 從一開始就沒有比較基礎。
所以每一列驗證紀錄至少要留下這些內容:
| 欄位 | 我需要記下什麼 |
|---|---|
| 功能/情境 | 這次實際操作哪一條申請路徑 |
| 固定輸入 | 舊版與新版共同使用的條件 |
| 基準輸出 | 舊系統產出的 JSON |
| 新版輸出 | 本次版本產出的 JSON |
| 比對結果 | 通過、出現差異或執行失敗 |
| 差異位置 | JSON path、舊值與新值 |
| 判斷 | 回歸、資料不同,或需求本來就改了 |
| 處理結果 | 修正後重跑,或確認新版結果合理 |
真正耗時間的是最後兩欄。
有差異,不代表新版一定寫壞了。舊版可能漏帶某個欄位,新版依需求補上;兩邊使用的測試資料也可能已經不同。Python 只把差異攤開,不應替我做業務判斷。
反過來說,「程式沒有報錯」也不代表可以通過。某個欄位放錯層級、少了一筆內容,JSON 仍然是合法格式,後面的申請流程卻可能收到錯的資料。這也是我保留基準輸出的原因:我要比的不是檔案能不能打開,而是固定情境下的結果有沒有發生不明變化。
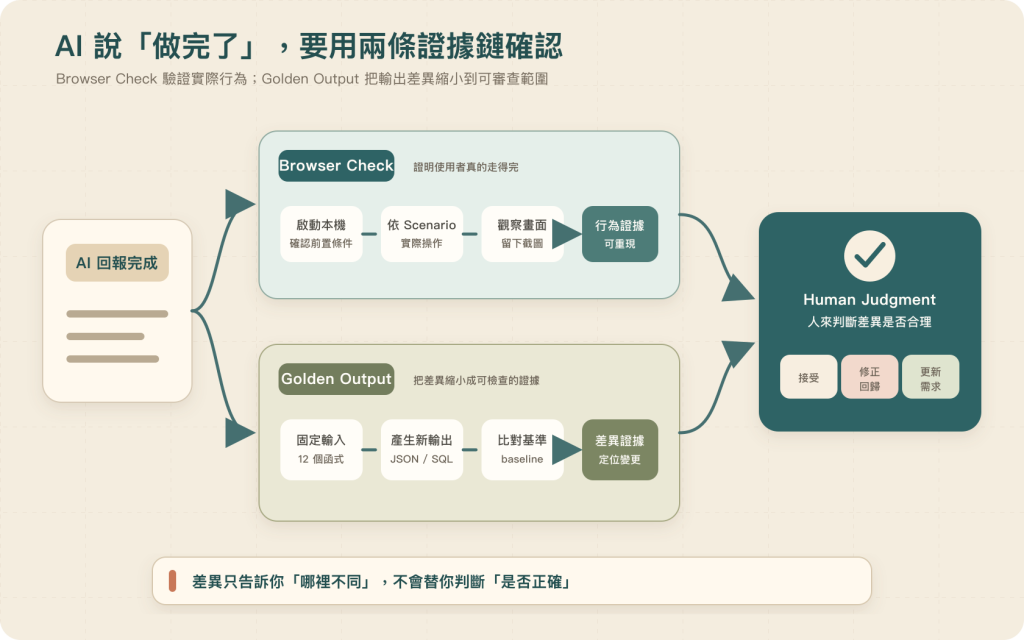
如果靠人直接打開兩份很長的 JSON 逐行找,13 項很容易漏看。Python 比對至少能先把範圍縮小:哪一項失敗、差異在哪條路徑、兩邊的值各是什麼。
這種檢查的優點很樸素:結果可以重跑,也能留下紀錄。缺點同樣明顯。只要輸出中有時間、順序或測試資料等合理變動,精確比對就可能出現差異;腳本不懂業務,也不知道新版是不是刻意修正舊版問題。
Anthropic 在 agent eval 的文章裡,把 code-based grader 的優點列為快速、便宜、可重現,也提醒它可能對合理變化過度敏感。文章也建議從團隊原本就在手動檢查的行為開始整理測試。這和我當時的情況很接近:我沒有先蓋一套完整平台,而是先把每次改版都在人工核對的 JSON,變成 Python 可以重複比較的輸入。(Anthropic, Demystifying evals for AI agents)
13 項 JSON 比對處理的是回歸問題:舊系統原本會產出的內容,新版是否還能正確產出。
它回答不了另一批問題:申請人找不找得到入口、欄位名稱看不看得懂、不同角色收到單據後知不知道下一步,以及跨科流程是否真的走得完。
那些只能交給 UAT。
我不想讓參與 UAT 的同事把時間花在替我抓基本輸出錯誤。先把 13 項功能逐一確認,是我進場前應該完成的功課。等這一層過了,UAT 才能把力氣用在更接近真實工作的地方。
挑一個你每次改版都會手動確認的輸出,先留下這張最小紀錄:
# Output Regression Check

- 功能/情境:
- 固定輸入:
- 基準輸出:
- 本次輸出:
- 比較方式:
- 差異位置:
- 差異原因:
- 處理結果與重跑紀錄:
輸出不一定是 JSON。API response、SQL、CSV、報表或固定計算結果都可以。先從你最怕被改壞的那一項開始,重點是保留一份下次還能拿來比較的基準。
UAT 前,我先把 13 項功能的 JSON 全部重跑。這讓我知道,新版至少沒有在我沒注意的地方改掉核心產出。
但接下來要驗的已經不是 13 份 JSON。
第一輪 UAT,我規劃了 14 個申請情境,要分配給不同組別協助驗證,還要請各科主管確認單據流程。準備測試帳號和資料只是前置;更麻煩的是,每個人要驗哪一段、預期看到什麼、出現問題後由誰接回來處理,都得先排好。
距離 7 月 31 日上線剩 30 天。下一篇,先從這 14 個情境怎麼準備開始。


 iThome鐵人賽
 看影片追技術