

需求釐清 agent 有沒有把一張 ticket 整理對、有問題的 AC 有沒有標齊,不能靠人看一眼的感覺判斷,要寫成一份可以一個欄位一個欄位擺在旁邊比對的資料。這份資料描述的是整理後那張卡最後留下來的樣子,不是 agent 中間走過哪條路。
昨天那個 case 檔案卡在最後三行的通過條件,「AC 標註總數 4」還算好寫,「Scope out 含結帳頁效能」這一條就寫不清楚要怎麼比,agent 輸出的是「結帳頁效能問題」,算不算符合?昨天把輸入固定住了,還沒處理的是判定這一半。
因為逐字比對抓錯重點,措辭、用語、語氣只差一個字就可能判定失敗,而要做的內容真的少了一條時,卻不一定檢查得出來。
換了一個詞語、多一行換行、把兩句話併成一句話,這時逐字比對就會全部判定紅燈(不通過),但其實東西並沒有壞掉(AC 與需求都正確合理)。這時反過來,4 個標註掉成 3 個那次(遺漏了「與描述不符」)在整份文字裡只短了十幾個字,跟改一個標點在字串比對眼中沒什麼差別。
所以要比的不是那份輸出,是從那份輸出讀出來的幾個欄位。
那張優惠碼的卡整理完該長什麼樣,前面已經寫過一份答案,當時的身分是示範輸出。同一份東西改寫成一組欄位,就是這筆 case 的 goal state:
goal state(ac-conflict-001)

Goal:必須存在、非空
Scope in:必須含 優惠碼套用、後台建立、過期處理
Scope out:必須存在且含 結帳頁效能
AC 標註:集合完全相同,{3 彼此衝突, 3 與描述不符, 4 不可驗證, 7 不可驗證}
留言的措辭:不比
查了幾次、查了誰:不比
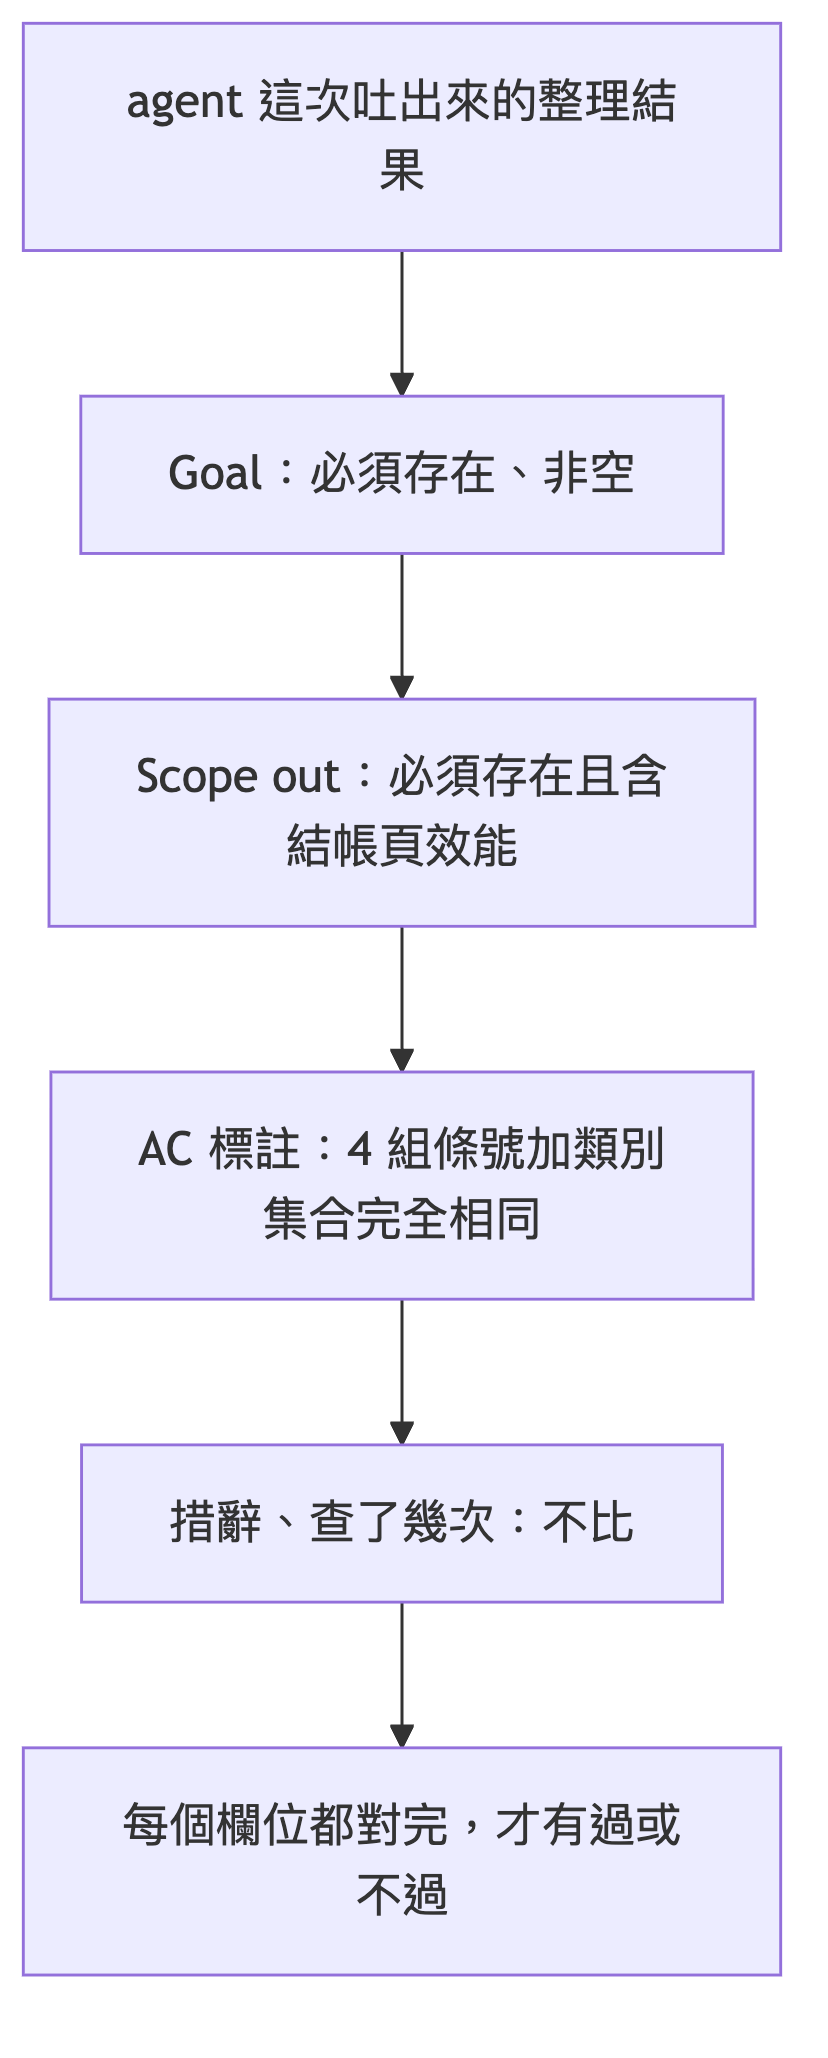
每個欄位要決定的是嚴格程度,上面那份 goal state 真正的內容不是欄位名,是右邊那一欄的三檔,完全相同、必須存在、不比。
先前講過 code-based grader(用程式判定的那一種)的代價,這種 grader 對「有效但沒被預期到的變異」很脆,agent 換一個沒想過的正確做法,程式照樣判失敗。三檔就是拿來決定這種脆弱放在哪幾個欄位。只有真的不能變的那幾個欄位才配得上「完全相同」,其他的往下放一檔。
分錯會往兩邊倒:
兩種分錯法都不會被發現,太嚴格的那條會被當成不穩定跳過,太鬆散的那條一直是綠的,看跑分結果的人不會覺得哪裡不對。
所以那份 goal state 裡最要緊的一行是 AC 標註 集合完全相同。這一行把當時沒人記下來的那個數字寫進檔案,而且寫的是集合不是總數,標對 4 個跟標錯 4 個分得出來。
τ-bench 就是這樣判的,對話結束以後,比對資料庫的最終狀態與標註好的 goal state(arXiv:2406.12045)。
理由前面說過一次,路本來就會換。同一張卡跑兩次,這次 search_repo 再 read_docs,下次變成三個工具各查一次,整理出來的卡一樣對。把「查了幾次」寫進判定標準,等於 agent 每次換個方式做對事情,這筆 case 都會被判成失敗,而卡最後留下來的樣子不會跟著路換。
這裡先留一個漏洞不補:有一類動作,等做完再判定就太晚了。 覆寫掉需求方親手寫的那 7 條 AC、post_comment 送出去的通知,這兩件事在最終狀態裡看起來就是「AC 更新了、留言在了」,agent 有沒有先和真人確認過?如果系統本身沒有留下操作紀錄(像 Redmine 至少會留一筆 AI 覆寫的紀錄),光看最終狀態完全分不出來。
這一類動作要不要管、能不能管,這個系列後面會用好幾天專門討論。今天只確定一件事,goal state 這份資料回答的是「最後長什麼樣」。
先寫「這個欄位判定不了」,然後保留紀錄。
「Goal 這一句寫得夠不夠精準」就是這種欄位,人一讀就看得出來,程式卻判不出來。這時候有兩種做法,第一種是塞一條看起來很努力的檢查(例如 Goal 至少 20 個字),第二種是老實把這個欄位標成判定不到。
要選第二種,因為第一種那條檢查會亮綠燈,而綠燈會被當成「這個欄位驗過了」的證據,其實什麼都沒驗。
這是前面那條規矩的延伸,判斷標準旁邊留一個欄位寫「這條現在驗不到」。空著的欄位至少不會被當成證據,假的檢查會。
需求釐清 agent 把一張 ticket 整理完、標完有問題的 AC 之後,「整理對了」長什麼樣要寫成一份 goal state。goal state 就是整理後那張卡的每個欄位,加上這個欄位要比到多嚴,三種選一種,跟答案完全相同、只要存在並含幾個關鍵詞、或者根本不比。這份 goal state 描述的是卡最後留下來的樣子,agent 查了幾次、走哪條路都不在裡面。
最要緊的欄位是 AC 標註,要集合完全相同,4 個掉成 3 個那次就是在這個欄位紅。判不到的欄位直接寫判不到,不要塞一條只會亮綠燈的檢查。


 iThome鐵人賽
 看影片追技術