

昨天我們成功運用 Docker Compose 建立App 微服務 + Prometheus + Grafana 的全套監控服務
現在,我們的容器不再是黑盒子了,不論內部 CPU 飆高、JVM Heap 記憶體波動,還是 Netty 執行緒的切換,Grafana 儀表板都能清晰無死角地呈現在我們眼前的動態曲線上。今天,我們就要來進行壓力測試,一探究竟目前的服務有什麼問題需要改進!
在發射 JMeter 壓測之前,先來思考一件事,我們在Day9的壓力測中,是使用JDK 內建的 JConsole 來監控,明明簡單方便為什麼一定要大費周章架設 Grafana?
原因很簡單,因為真實生產環境下會有很大的差別:
| 維度 | JConsole (本地單機工具) | Grafana + Prometheus (企業級 Cloud-Native) |
|---|---|---|
| 連線機制 | 需要暴露 Java JMX 埠與遠端 GUI 桌面 | Web 網頁直接登入,不需要任何 Desktop GUI |
| 容器與生產適用性 | 雲端/Docker/K8s 無 GUI,暴露出 JMX 有嚴重資安風險 | 專為容器與 Linux 伺服器設計,100% 安全 |
| 指標豐富度 | 僅能看 JVM 記憶體與執行緒,看不到 QPS 與 HTTP 429/500 比例 | 兼具 JVM、容器 CPU、HTTP 吞吐量、API 延遲與 S3 呼叫率 |
| 歷史數據與團隊協作 | 視窗一關數據瞬間消失,無法進行歷史趨勢比對 | 時序資料庫永久儲存,團隊全員共用面板、可設定警報通知 |
所以結論就是 JConsole 適合單機開發除錯,但是當服務容器化部署到雲端時,Grafana 才是唯一能掌控全域的視角!
在預設狀況下,Docker 容器會無限制地使用宿主機(Mac/PC)的所有 CPU 與記憶體。如果不加以限制,我們就無法測出「單一節點」在標準雲端硬體配置下的真實極限。
所以我們稍微修改一下 docker-compose.yml,加上嚴格的硬體資源限制(2 核 CPU / 512MB 記憶體,JVM 最大堆積記憶體 -Xmx384m):
  s3-app:
    image: ithome-s3-service:v1
    container_name: s3-app
    ports:
      - "8080:8080"
    environment:
      - AWS_REGION=ap-northeast-1
      - JAVA_OPTS=-Xms128m -Xmx384m -XX:+UseG1GC # 限制 JVM Heap 最大為 384MB
    deploy:
      resources:
        limits:
          cpus: '2'      # 限制最多使用 1.5 核 CPU
          memory: 512M      # 限制容器實體記憶體最多 512MB
    networks:
      - monitoring-net
重啟容器套用新的硬體限制:
docker compose up -d --force-recreate s3-app
或許有人會好奇為什麼要把容器限制在 1.5 核 CPU 和 512MB 記憶體?這會不會太小了?我們不能讓 Docker 盡情使用電腦的所有 CPU 和記憶體嗎?
這次測試中故意加上這道限制,原因有三:
resources.limits,K8s 就無法計算 CPU 使用率百分比,HPA 的自動擴展機制就會當場失效!之前Day9 效能壓力測試的文章中已經有帶大家設定過listObject, putObject相關的設定了,今天要帶大家來補充我們後續新增的/protected 上傳api的設定
在前面的 Day 12 中,我們實作了客戶端冪等性合約,要求前端上傳時必須在 Header 攜帶唯一的 uploadId (UUID)。在 JMeter 中,我們要如何讓每筆請求都帶上不同的動態 UUID 呢?
如果還有之前壓力測試的檔案可以直接複製一份,或是重新開始建立
20 個併發線程。5 秒內全數湧入。5 次(總計發射 500 筆 非同步 S3 上傳請求!)。| Name (名稱) | Value (值) | 作用與說明 |
|---|---|---|
| uploadId | ${__UUID()} |
使用 JMeter 內建函式,動態生成新的 UUID! |
localhost
8080
POST
/api/s3/async/upload/protected
file (對應 Controller 的 @RequestParam("file"))multipart/form-data
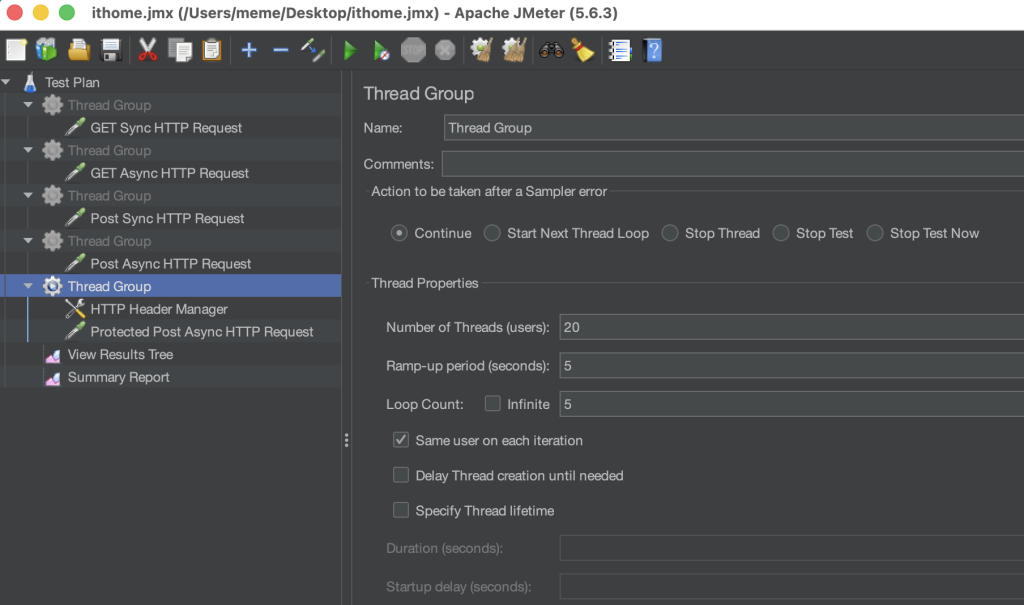
我們在正常的網路環境下,針對新建立好的protected api與舊的沒有任何保護的async上傳api做測試,設定20併發,rand-up:5s,迴圈重複5次,總共發100筆上傳的請求:
我們發現protected的api效能如下
反觀沒有任何保護措施的api有高達53%的錯誤率!
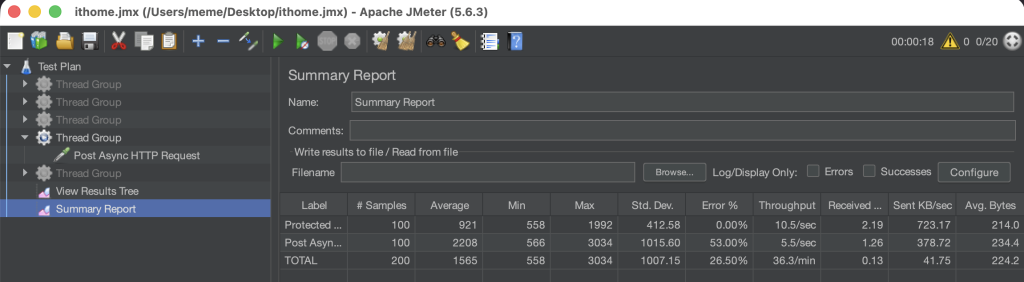
如果不看監控只看系統console會發現他只顯示timeout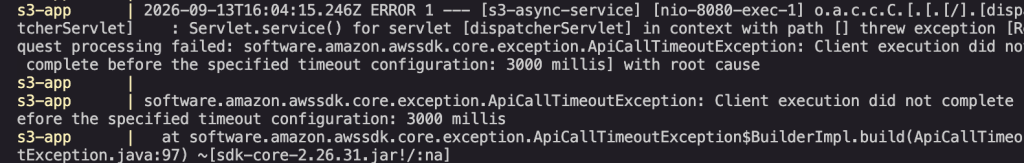
舊版 API 中,當 100 個併發請求擠進微服務時,因為連線數與 S3 I/O 發生壅塞,超過一半的請求在發起 putObject 後,耗時超過了我們在 SDK 設定的 apiCallTimeout = 3000ms (3 秒)。 舊版 API 遇到 Timeout 就直接認輸,拋出 ApiCallTimeoutException 並向客戶端回傳 HTTP 500 錯誤。這導致系統湧現高達 53% 的失敗率,且在 S3 端留下了大量不確定有沒有上傳成功的檔案!
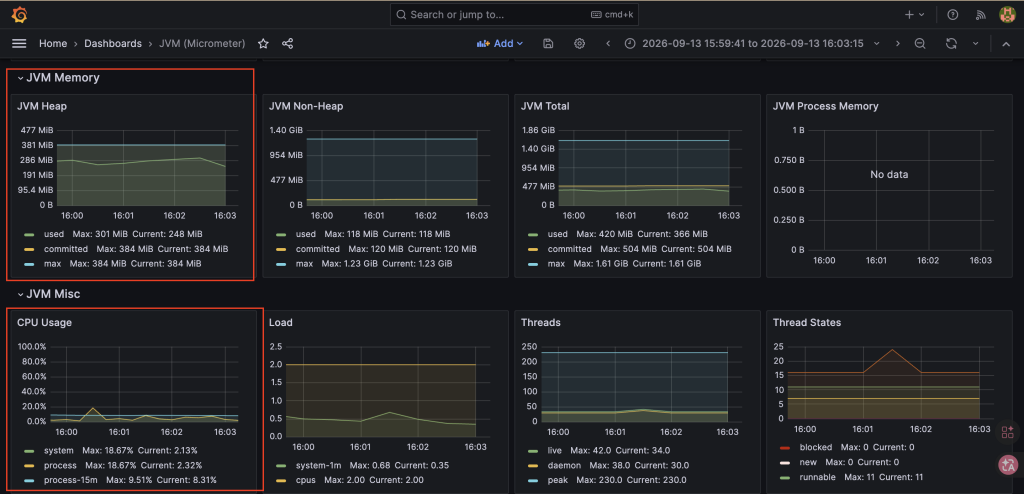
仔細看有兩個高峰,前者代表有保護API的執行,後者則是沒有保護API的壓力測試,仔細觀察可以發現兩次壓測執行時,容器的 CPU 佔用率其實都不到 40%(距離 1.5 核的上線綽綽有餘),JVM Heap 記憶體也還有充裕的空間,但為什麼無保護 API 卻卡死在 2208ms 甚至爆炸?
回過頭來看有保護API壓力測試時的console log,可以發現其實也會遇到timeout問題,但是我們有很多方式可以去處理,不讓超時成為破口,有保護的 API 把不確定的 Timeout轉換成了確定的結果!
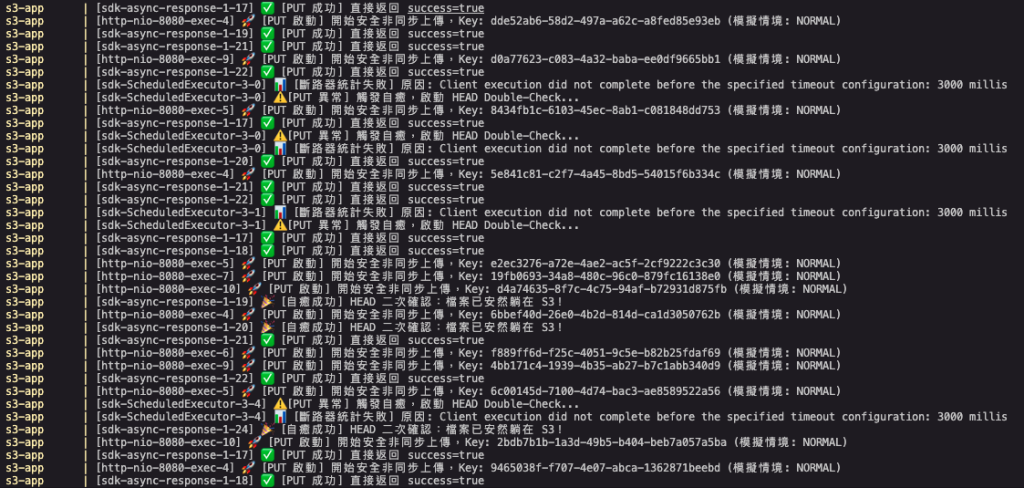
只看console可能有點混亂,我稍微將其繪製成流程圖
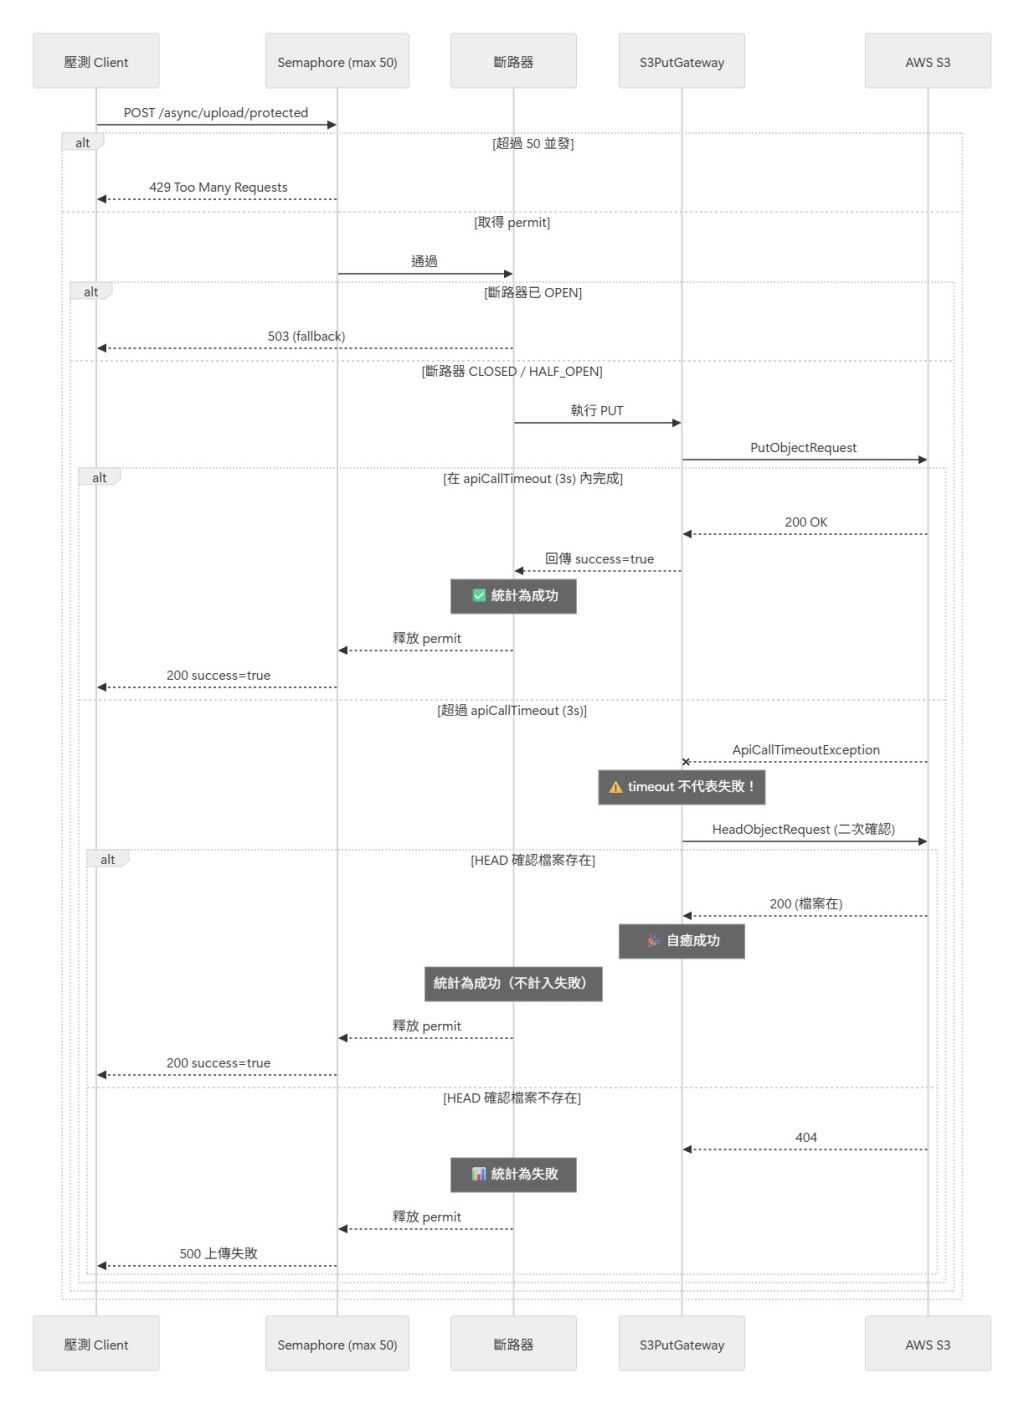
當 100 個併發上傳 S3 時,S3 處理 PutObjectRequest 可能花費了 3.1 秒(剛好超過 3 秒 SDK 超時限制)。
這就是 0% 錯誤率的秘密! 那些原本會被判定為失敗崩潰的 53% 超時請求,被我們的 Double-Check 探針在 20 毫秒內全數挽救回來,實現了對客戶端無感過關的分散式奇蹟!
今天,我們透過 JMeter 100 併發實彈對決與 Grafana 動態監控,得出以下結論:
200 或429 背壓,將 53% 的崩潰錯誤率徹底歸零!雖然今天的測試還沒有達到單機壓力測試的上限,明天我們就會把延遲的瓶頸解決掉,並且也來調整一下listObject的api,再次做壓力測試來驗證單一節點的硬體資源(1.5 Cores / 512MB RAM)上限!進一步思考說當現實世界中的突發海嘯流量超越了單機所能承受的極限時,只靠 Semaphore(429) 無情地把使用者拒之門外真的是一個好方法嗎?


 iThome鐵人賽
 看影片追技術