
一張工作流圖裡,方框代表能做的事,箭頭代表做完之後要去哪裡。前者通常很好列,後者才容易失控。
Day 19 先判斷一份工作值不值得使用 Agent,Day 20 再限制 AI 能碰哪些工具。搜尋與讀取可以放進能力契約,寫檔和發布不提供。做到這裡,AI 已經有一雙受限的手,但流程還少一個決定:它做完眼前這一步,下一站是什麼?
這個決定不能全部塞給模型。
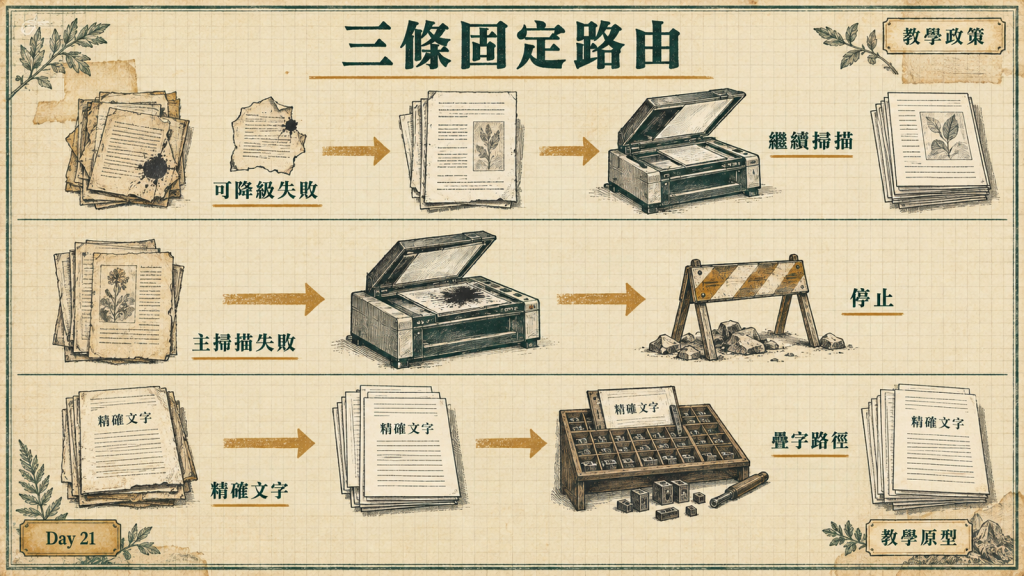
假設情報採集失敗,但這個來源本來就允許降級,流程可以固定繼續主掃描。假設主掃描失敗,或必要的 Markdown 根本沒產生,流程就該停。這些都不需要 AI。
另一種情況比較麻煩。需求只說「把兩個選項的差別並排說清楚」,合法候選同時有「比較圖」和「主題概覽」。兩個節點都存在、都能執行,光看成功碼或檔案是否存在卻選不出來。這裡才可能需要語意判斷。
Day 21 要拆的,就是固定規則與 AI 提案之間這條線。
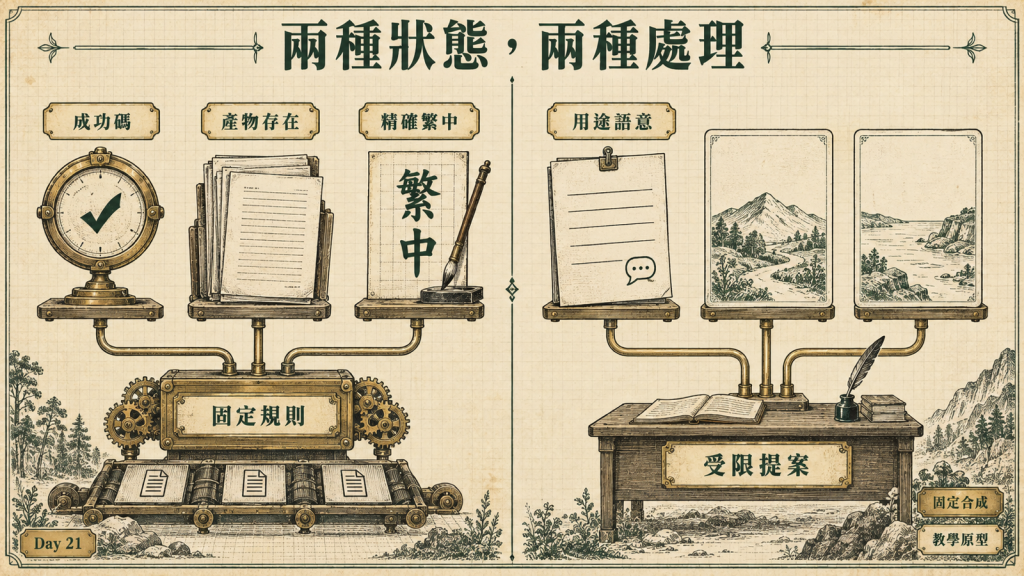
下面就用同一個內容路由案例,看看哪些箭頭該寫死,哪一段才值得問 AI。
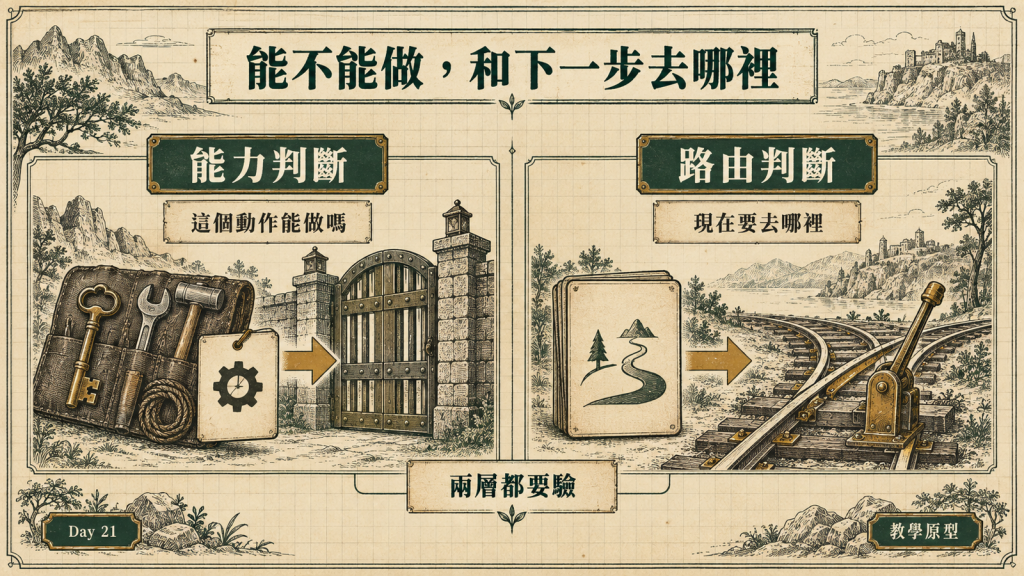
能力判斷處理一個動作。
模型要求讀取來源時,執行器要檢查工具名稱、參數、資源範圍與剩餘額度,再決定是否真的呼叫工具。Day 20 講的是這一層。
路由判斷處理狀態轉移。
搜尋完成後,下一站可能是讀取來源、換另一組關鍵字,或因為資料不足而停止。Day 21 講的是這一層。
| 問題 | 輸入 | 輸出 |
|---|---|---|
| Day 20:這個動作能不能做? | 工具請求與能力契約 | 允許、拒絕或停止 |
| Day 21:現在該去哪一步? | 目前狀態與合法候選 | 下一個節點或停止原因 |
這兩層不能合併。路由器選到「讀取來源」,只代表下一站是讀取;真正要讀哪一筆資料、呼叫者是否有權讀,仍要通過能力檢查。
同樣地,選到「產生圖片」也不代表流程突然獲得發布權。路由通過不是權限通過。
固定規則適合處理三種條件:事前列得完、相同輸入必須得到相同結果,而且不能因為句子換一種說法就改變答案。
放回內容產線,大概會長成這樣:
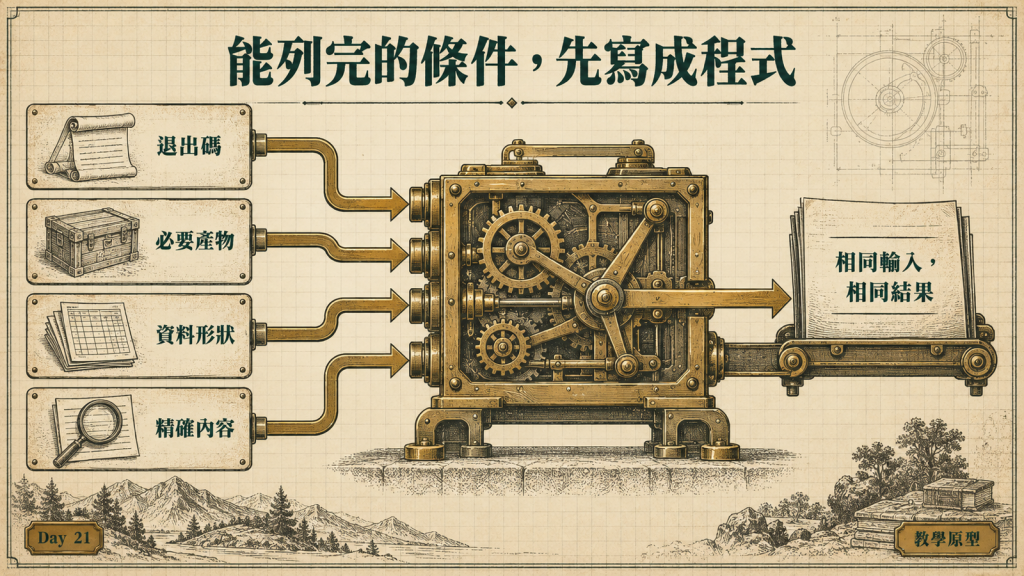
前面三條來自固定控制流的形狀,第四條來自視覺媒材規範。它們處理的是不同任務,不能拿來比較誰比較快、誰比較準。這次只是從中抽出同一個設計線索:條件既然能明確列出,就不必多加一次模型判斷。
Amazon States Language 的 Choice State也是類似做法:依順序檢查規則,採用第一個成立的分支;全部未命中時,必須有預設出口,否則就回報沒有可選分支。W3C SCXML則把狀態、事件、條件與轉移明確表示出來。
這兩份規格都不是 AI 路由標準,但它們提醒了一件很基本的事:合法下一站應該存在系統裡,不能只寫在提示詞裡期待模型記得。
固定規則處理完後,可能還會剩下一小塊難以列完的語意差異。這時可以讓模型參與,但它拿到的不是整張系統地圖,而是這一輪已經過濾過的候選清單。
這次把一次路由拆成四個責任:
route_id。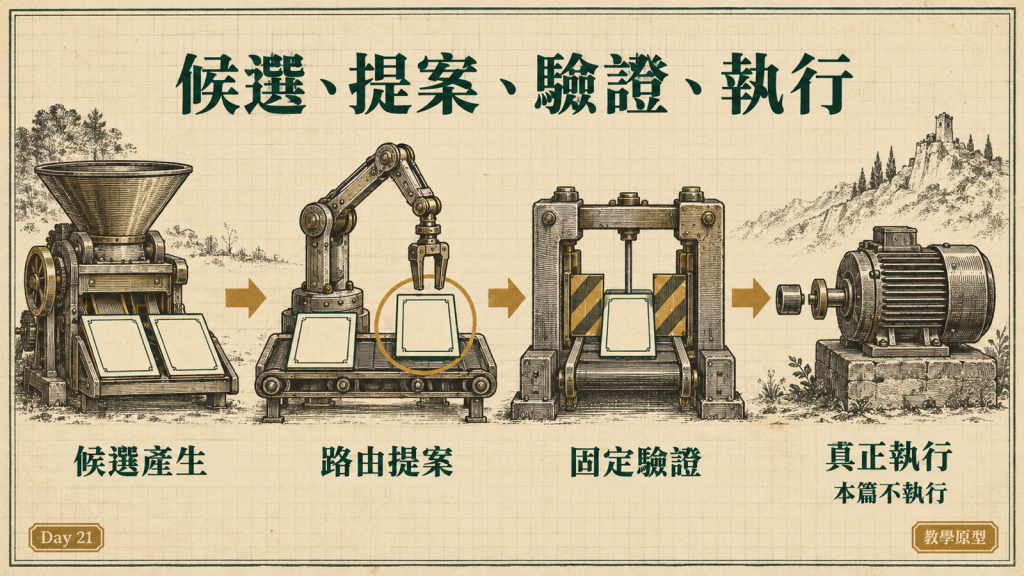
AI 如果參與,只待在第二站。前三站與第四站都不能讓它自己改。
以固定合成案例來說,當輪候選只有兩個:
{
  "allowed_routes": [
    "editorial-contrast",
    "editorial-overview"
  ]
}
模型可以提案 editorial-contrast,也可以提案 editorial-overview。它不能自己增加 publish,更不能宣稱這次已經獲得發布批准。
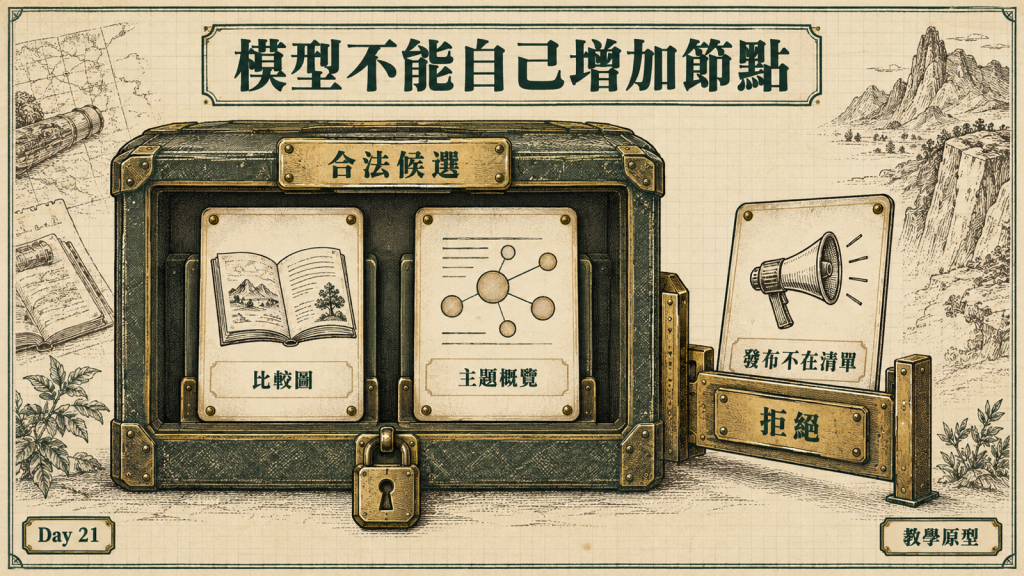
OpenAI Agents SDK 的 Handoffs 文件允許程式先登錄可交接的目的地,也能依當輪條件決定哪些目的地對模型可見。Context management 文件也把工具可見性與執行時的參數、資源授權分開。
所以候選清單只回答「這一輪有哪些路可以提」。它沒有回答「這條路裡的每個動作都獲准」。
OpenAI Agents SDK 的編排文件把模型驅動與程式驅動編排分開,也明示兩種模式可以混用。Anthropic 的 Agent 實作文章則建議先找能完成工作的簡單做法,路由既可以使用模型,也可以使用傳統分類方法。
放進這篇的問題,答案就不是「所有箭頭都寫死」或「所有箭頭都交給 AI」。比較合理的切法是:
為了確認這個切法,不能拿兩條原本就不同的工作流互相比。這次另外建立 7 組固定合成案例,讓兩種路由方式面對相同狀態、相同候選和相同的事前答案。
純規則基線遇到硬條件就直接選,碰到語意缺口便回 decision_required。混合路由保留完全相同的硬規則,只在那個缺口呼叫固定腳本提案者。
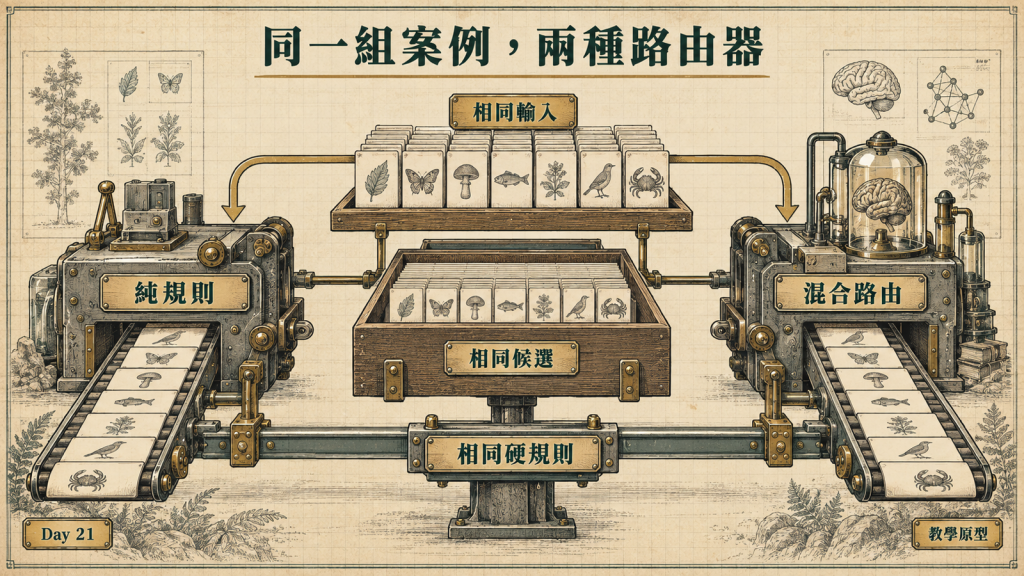
注意,這裡是「固定腳本」,不是真實模型。
這 7 組案例不是從正式流量抽樣,而是為指定分支建立的固定資料:
| 案例 | 事前答案 | 純規則 | 混合路由 |
|---|---|---|---|
| 可降級採集失敗 | 前往 scan |
命中 | 命中,提案 0 次 |
| 主掃描失敗 | scan_failed |
命中 | 命中,提案 0 次 |
| Markdown 缺席 | artifact_missing |
命中 | 命中,提案 0 次 |
| 精確繁中與表格 | hybrid-overlay |
命中 | 命中,提案 0 次 |
| 模糊編輯用途 | editorial-contrast |
decision_required |
命中,腳本提案 1 次 |
| 空候選 | no_route |
命中 | 命中,提案 0 次 |
| 必要輸入缺少 | input_required |
命中 | 命中,提案 0 次 |
保存稽核重算後,純規則符合事前答案 6/7,選定 2 組、停止 5 組,其中 1 組本來可以前進,卻交回人工。固定腳本混合路由符合 7/7,選定 3 組、停止 4 組,只提案 1 次。
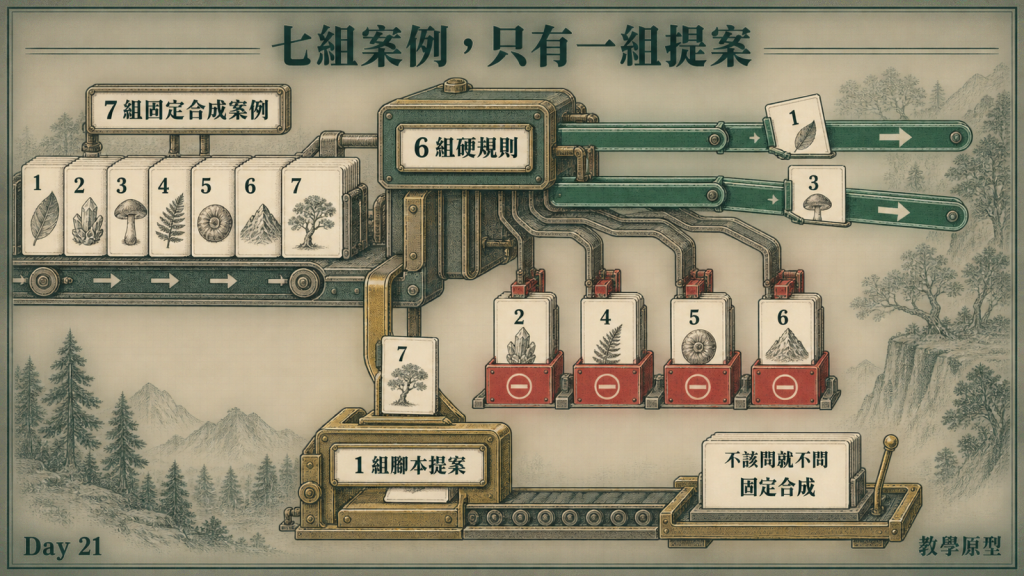
老實說,7/7 看起來很漂亮,也最容易被讀錯。
這不是模型成績。那次提案是預先寫好的腳本,事前答案也由教學案例的作者標註,沒有獨立標註者。這組結果只能證明兩件事:控制器把提案限制在預定的語意缺口,而且保存下來的路由結果可以重算。
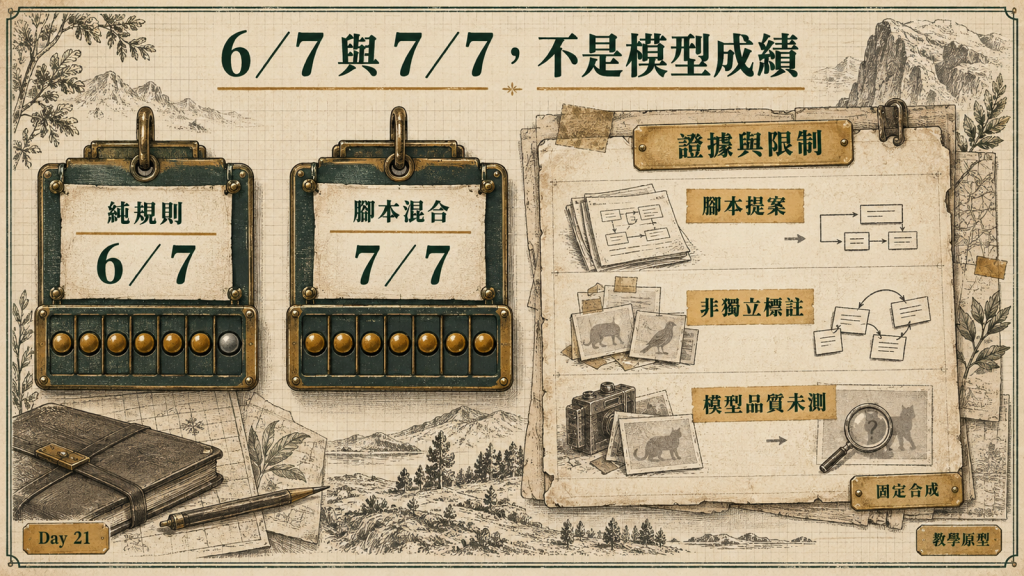
真實模型的語意品質、成本、延遲與重跑穩定性,這次全部未測。τ-bench會比對代理執行後的狀態與任務目標,也用重跑觀察同一任務能否持續成功。那套客服工具基準不能直接搬到內容產線,但方法上的提醒可以留下:只跑一次、只看最後一句答案,還不夠評估真實模型。
固定合成案例裡,「比較圖」與「主題概覽」都是合法候選。需求明明是「把兩個選項並排說清楚」,如果提案者選了主題概覽,驗證器仍可能接受。
不是驗證器壞掉,而是它只負責這幾件事:
route_id 的資料形狀正確。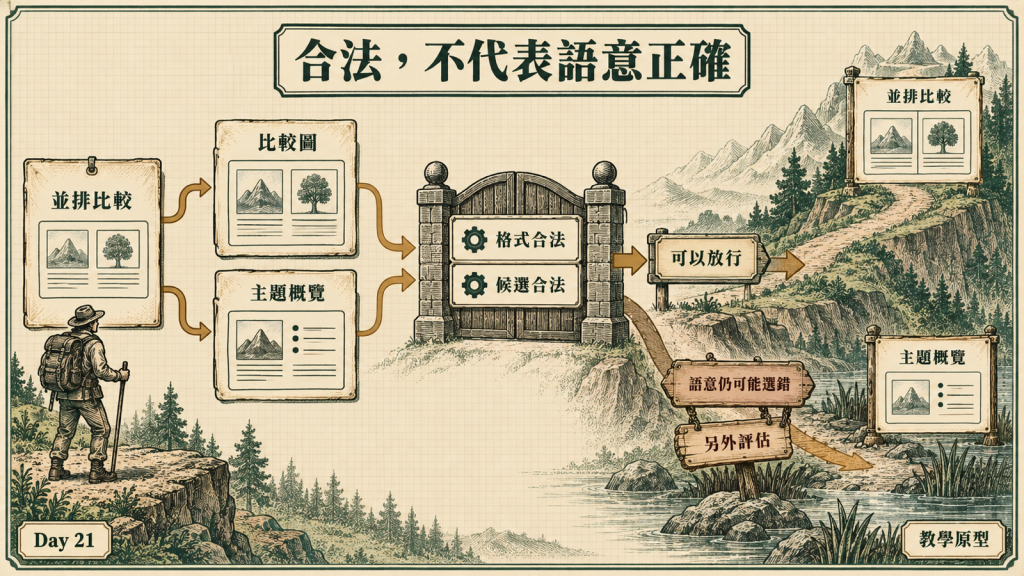
「用途選得對不對」是另一個問題。OpenAI 的 Structured Outputs 文件也特別說明,輸出符合資料結構,不代表內容值一定正確。
所以 accepted 的意思只能是「允許交給下一層」,不能寫成「答案正確」。之後若要使用真實模型,還得另外準備有標註方法的語意案例。
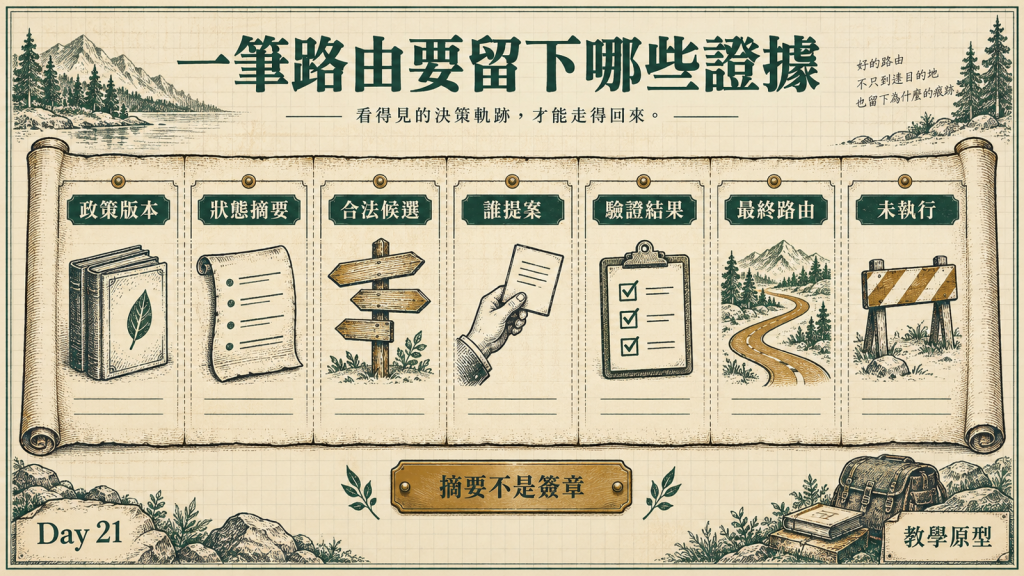
只記最後選到哪一站,事後很難判斷是固定規則選的、腳本提的,還是驗證器漏放。這次的 route-decision.v1 至少保存六類資訊:使用哪版政策、看到什麼狀態、當時有哪些候選、誰提出選擇、驗證結果是什麼,以及下游到底有沒有執行。
以下是那組模糊編輯用途案例留下的完整紀錄:
{
  "schema_version": "route-decision.v1",
  "policy_version": "day21-route-policy.v1",
  "state_digest": "sha256:cfa8c4991573fdf7ef07accd845de17e3dd311fe04f256b65b9501191b1aa583",
  "candidate_source": "program_filtered_fixture_registry",
  "allowed_routes": [
    "editorial-contrast",
    "editorial-overview"
  ],
  "decision_owner": "scripted_model_proposal",
  "proposed_route": "editorial-contrast",
  "proposal_digest": "sha256:9cf6a7c3b6b914450958584c7167e009340efb2c7356600180cff9aa1d9b2318",
  "validation": {
    "status": "accepted",
    "reason_code": "allowed_route"
  },
  "outcome": "route_selected",
  "final_route": "editorial-contrast",
  "stop_reason": null,
  "required_inputs_present": true,
  "human_exit": "decision_required",
  "scripted_proposal_calls": 1,
  "executed": false,
  "execution_status": "routing_only_downstream_not_run"
}
這裡最重要的欄位不是 final_route,而是 decision_owner 與 executed。前者說明選擇由誰提出,後者明確記著本篇只做路由,沒有執行下游節點,也沒有串接 Day 20 的能力閘門。
state_digest 用來檢查輸入內容是否一致,不是簽章,也不會自動保密。OpenAI Agents SDK 的 Tracing 文件提醒,追蹤內容可能包含模型輸入與工具輸出等敏感資料。能追蹤是一回事,要保存哪些內容、保存多久,又是另一份政策。
no_route、input_required 和 decision_required 都不能放進 allowed_routes。
原因很簡單。allowed_routes 記的是現在有哪些節點可以執行;stop_reason 記的是流程為什麼沒有往下走。把兩者塞進同一欄,之後就分不清系統當時沒有合法動作,還是選了一個名叫「需要人工」的節點。
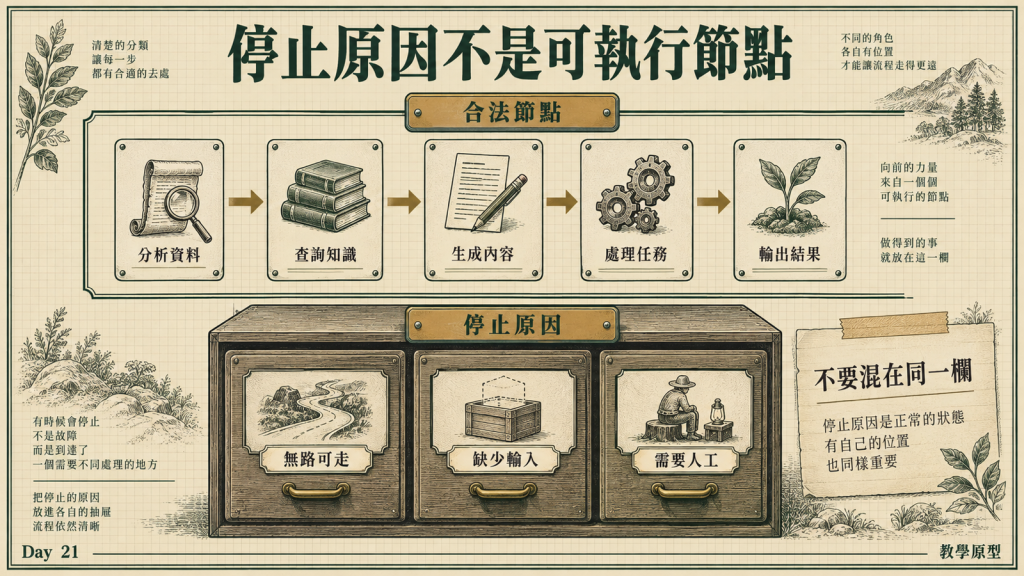
而「需要人工」本來就不是一個會自動執行的工作站。OpenAI Agents SDK 的 Human-in-the-loop 文件會在需要批准的工具前中斷並保存狀態,等批准或拒絕後再續跑。對外發布也是同一條責任線:沒取得批准,就停在執行前。
這次另外跑了 3 組契約負向案例,而且沒有灌進前面的 6/7 與 7/7:
| 提案 | 停止原因 | 結果 |
|---|---|---|
| 未知節點 | route_rejected |
拒絕,未執行 |
| 已停用節點 | route_disabled |
拒絕,未執行 |
| 未批准的發布節點 | decision_required |
拒絕,未執行 |
3 組固定案例合計 3/3 符合預期,final_route 維持空值,executed 也都是 false。
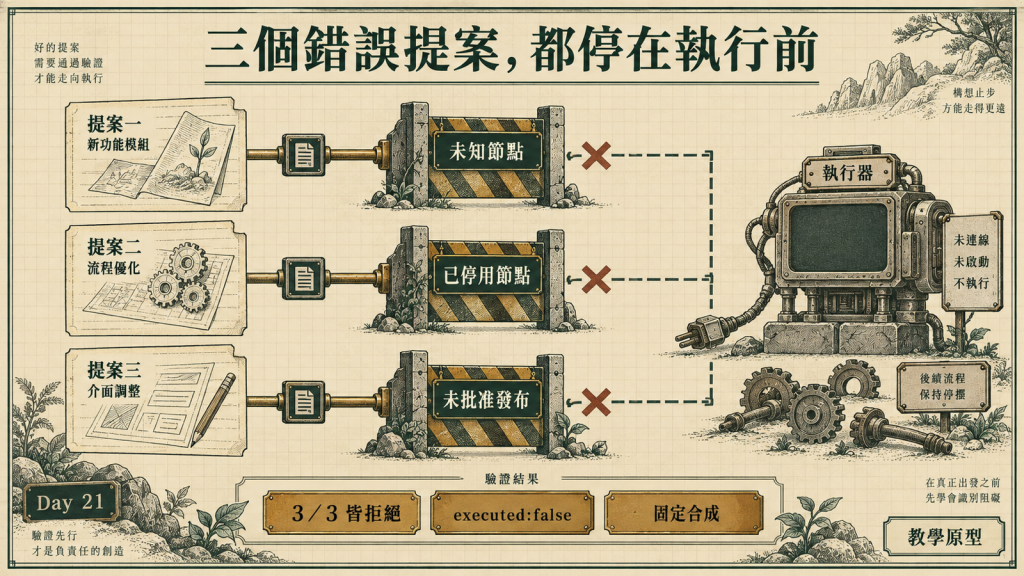
這只能證明參考控制器對這三條路徑的行為。它沒有證明正式環境不存在其他旁路,也沒有證明下游工具安全。MCP 的工具規格仍要求工具端驗證輸入與實作存取控制。選對下一站,不能取代工具層的權限檢查。
做到這裡,可以把選擇縮成五個問題:
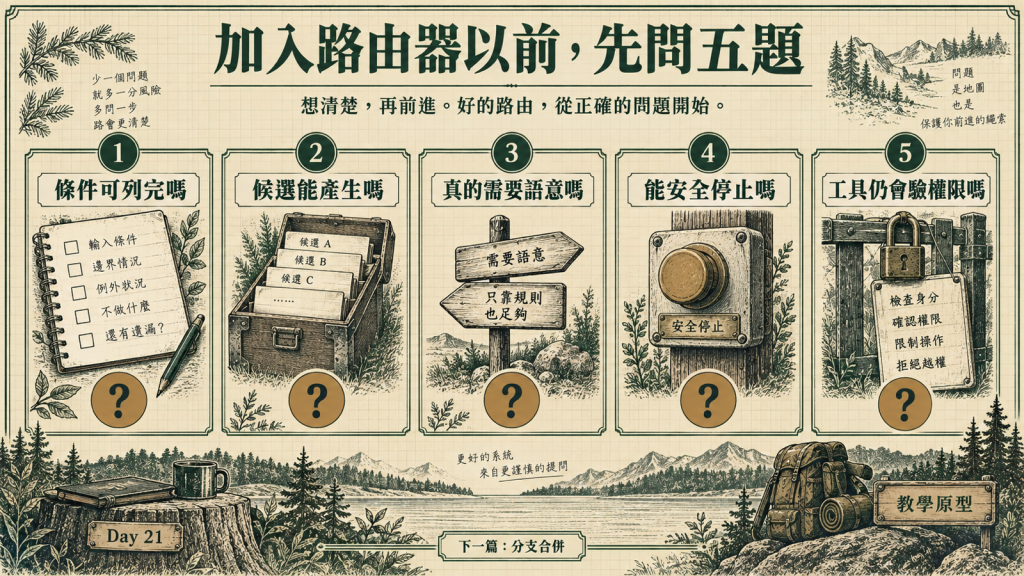
真正值得交給 AI 的,通常不是整條工作流,而是固定規則處理完後,合法候選之間仍然存在的那小塊語意差異。
程式負責產生候選、處理硬規則、驗證提案與停止。AI 只負責提案。作者偏好、內容採用與對外發布,仍然停在人面前。
Day 21 先把單一路由講清楚。下一篇會把多份彼此獨立的來源查核放在一起:哪些可以同時跑,其中一條逾時或缺席時怎麼保留部分結果,來源互相衝突時又該由誰合併。


 iThome鐵人賽
 看影片追技術