
昨天說今天要從 ping 開始,看它到底差多少。
動手之前我猜大概十倍。量完是幾百倍。而且量完才發現,這個工具回答的根本是另一個問題。
一台 RHEL 9.8 主機(rhel-node1,26 核,HT 關閉),板載網卡接到 Arista 7150。
ping 打兩個目標:主機自己的 loopback(127.0.0.1),還有交換器的管理 IP(192.0.2.237)。另外寫了 19 行 python 在 loopback 上灌 TCP 測吞吐,拿來當負載用。
五條指令,每條 10 到 30 秒。
ping -c 2000 -i 0.005 -D 127.0.0.1 > ~/day02/loopback.txt
ping -c 2000 -i 0.005 -D 192.0.2.237 > ~/day02/switch.txt
python3 ~/day02/tput.py 10 | tee ~/day02/tput.txt
taskset -c 3 python3 ~/day02/tput.py 30 > ~/day02/tput_pin.txt 2>&1 & sleep 1
taskset -c 3 ping -c 2000 -i 0.005 -D 127.0.0.1 > ~/day02/pinned.txt; wait
-c 2000 送滿 2000 個封包後自動停止(count)-i 0.005 每個封包間隔 5 毫秒-D 會在每行前面印時戳然後把 time= 那欄抽出來算百分位數。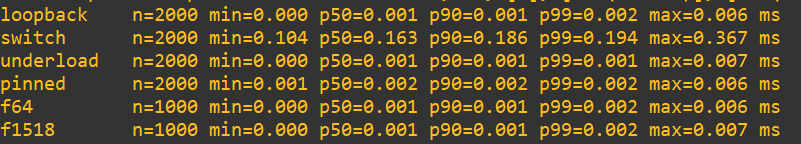
rtt 那行的 avg 印出來是 0.000 ms。 ping 的輸出只到小數第三位,也就是 1 微秒。7150 這種 cut-through 交換器,官方標稱是 350 奈秒。那是標稱值不是我量的,整段轉發時間塞得進ping的一個顯示格子裡。差幾倍我今天不算,因為手上還沒有實測值,後面量出來再回頭補。
ping 交換器量到 163 微秒。 這個數字不是轉發延遲。管理 IP 上的 ICMP 由交換器的 CPU 來回,封包根本沒進轉發晶片,所以量到的是那顆管理 CPU 今天有多忙。min 104 到 max 367,光抖動範圍就有 263 微秒。
64 bytes 跟 1518 bytes 那兩列,六欄裡五欄一模一樣,只有 max 差 1 微秒,而 1 微秒剛好就是 ping 的顯示下限。封包大了 1454 bytes,ping 的輸出幾乎一動也不動。同樣這段資料推上 10G 的線要花 1163 奈秒 (下面計算方法),那個量級 ping 就是看不到。
(1518 - 64) x 0.8 ns/byte = 1163.2 ns
吞吐那邊也一樣。tput.py 在 loopback 上跑出 85.75 Gbit/s,而這條路徑上完全沒有網路。數字很漂亮,但它對延遲一句話都沒說。

我原本預測當主機一加壓,ping 的 p99 就會炸開。理由很直覺,吞吐測試吃滿 CPU,ping 要排隊,延遲當然變差。然而實測下來完全沒有。underload 那列的 p99 是 0.001,比沒負載的 0.002 還低,而負載確實有跑滿,30 秒傳了 317 GB。
這台有 26 顆核心,我的腳本只有兩個執行緒,吃滿兩顆,剩 24 顆閒著。ping 永遠排得到空核心,兩邊沒搶過同一個東西。
我錯在把「有負載」直接當成「會競爭」,沒先問它們有沒有搶同一個資源。
所以我用 taskset 把負載跟 ping 都釘在第 3 顆核心上重跑。pinned 那列的中位數從 0.001 變 0.002,整條分布往右移一格,而一格就是 ping 能表示的最小一步。負載自己也慢了,同樣綁在那顆核上,沒有 ping 的時候跑 81.91 Gbit/s,有 ping 剩 71.69。
-i 0.005 要求每 5.000 毫秒送一包,把 -D 的時戳相鄰相減,就能看它有沒有做到。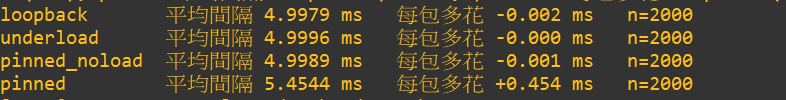
loopback        (沒綁核、沒負載)
underload       (沒綁核、有負載)
pinned_noload   (綁了核、沒負載)
pinned          (綁了核、有負載)
前三列都貼著 5.000,只有最後一列跳掉,所以那個落後是搶核心造成的,跟 taskset 本身無關。每包多花 0.454 毫秒,2000 包累積下來,ping 自己遲到了 908 毫秒。而它在 rtt 那欄只多了1微秒。
同一次加壓、同一個行程。ping 的輸出多了 1 微秒,實際每包被延誤 454 微秒,差 454 倍。
那 454 微秒不在 ping 的任何一欄輸出裡。RTT 是從封包真的送出去那一刻才起算的,行程被排程器晾在旁邊的那段,發生在碼錶按下之前。
還有一組數字指向同一件事。我寫了個 UDP echo,一樣打 127.0.0.1,一樣一來一回,封包大小也一樣,唯一的差別是回覆由誰產生。
ping       p50 1 µs      max 6 µs
UDP echo   p50 5.52 µs   max 30.26 µs

ICMP 的回覆是 kernel 在軟中斷裡直接生出來的,不用叫醒任何使用者空間的行程,UDP echo 的回覆要叫醒一個。UDP echo 平常那一下就已經接近 ping 在同一條路徑上量到的最壞值,max 更是差了五倍。
先講一個跟上面完全同源的狀況。之前同事說印表機沒反應,我 ping 那台印表機的IP可以通,但就是連不上。後來重開機幾次就好了,那時候我也不知道具體原因是什麼,只覺得 ping 不太準。
做完今天這組才想通,ping 通不代表那台機器能用,它只證明那台機器的 kernel 還活著。服務行程卡死,網路堆疊照樣回 ICMP。實驗室裡 UDP echo 那五倍是溫和版本,現場的極端版本就是服務已經掛了,而 ping 持續回應。所以有兩件事現在可以確定:
ping 通不等於服務可用。
監控只有 ICMP,等於只監控到 kernel 活著。要知道服務能不能用,探測至少要打一次它真正的服務埠。
看百分位數,不要看平均。
今天 avg 那欄印出來是 0.000,等於什麼都沒說,p99 跟 max 至少還告訴我分布右邊長什麼樣子。
至於門檻要訂多少我還沒有答案,得先有一組基準數字才談得上。
明天開始碰硬體時戳,先弄清楚 ExaNIC 的時戳是誰打的、打在封包的哪個位置。


 iThome鐵人賽
 看影片追技術