
📝 本系列為 iThome 鐵人賽學習筆記,屬個人教學與非商業用途;文中法規與標準內容均以自身理解後的話轉述並註明出處,非逐字引用。
階段四|怎麼落地:從技術棧示範
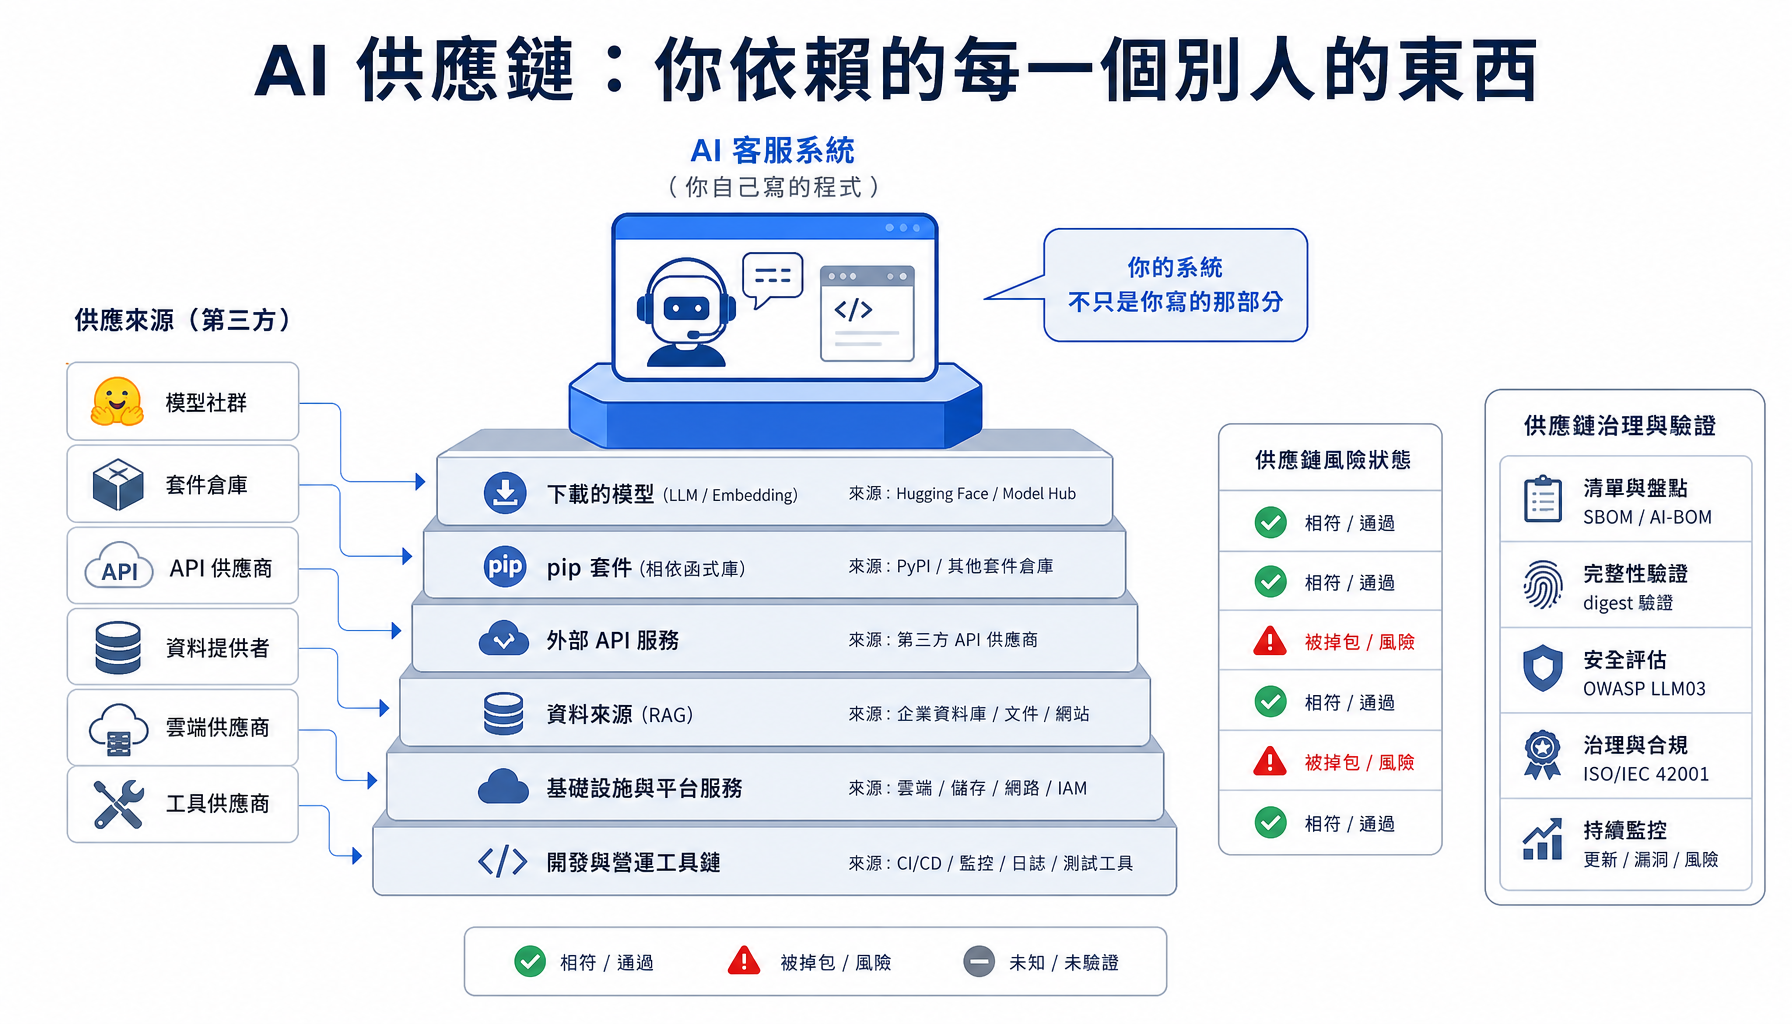
過去幾天,我們把醫院檢索增強生成(Retrieval-Augmented Generation,以下簡稱 RAG,原理見 Day 21)客服的每一層防禦都做得滴水不漏:資料、輸入、輸出、存取、稽核,還用紅隊測試驗證過。看起來,安全的功課做完了。
但這裡有一個容易被忽略的盲點:這套系統,遠遠不只是「我們自己寫的那幾百行程式」。 打開來看,它其實站在一長串「別人的東西」之上——那個用 ollama pull 下載來的大型語言模型(Large Language Model,以下簡稱 LLM)、那些 pip install 進來的 numpy 和 ollama 套件、可能還有外部的應用程式介面(Application Programming Interface,以下簡稱 API)、以及餵進知識庫的資料。
這些「別人的東西」,你信得過嗎? 下載回來的模型,會不會被人動過手腳、藏了後門?安裝進來的套件,會不會其實是個偽裝成正牌的惡意冒牌貨?這一整條「別人的東西」構成的鏈條,就是供應鏈(Supply Chain)。今天要談的,就是供應鏈風險——以及怎麼治理它。這也對應到開放全球應用程式安全計畫(Open Worldwide Application Security Project,以下簡稱 OWASP)LLM 應用十大風險中的「供應鏈(LLM03)」條目。
一個典型的 AI 系統,會從如下圖所示的四個地方引入「別人的東西」,每一類都有它的風險:
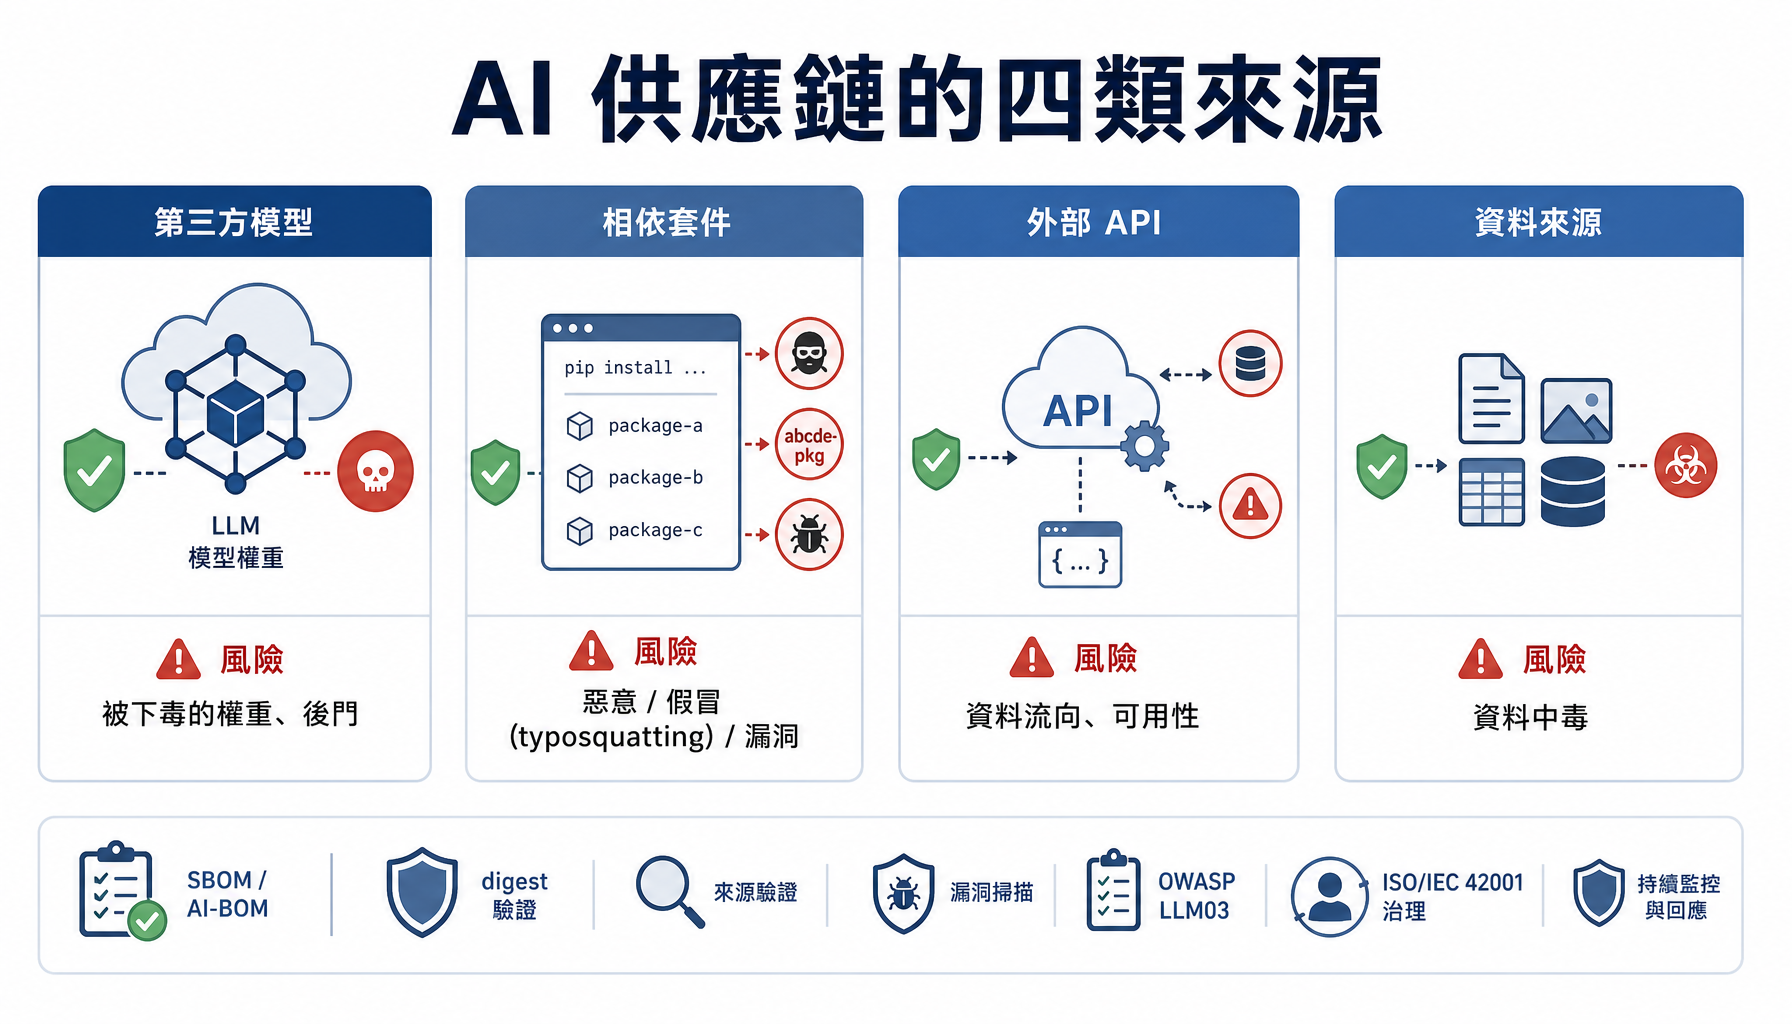
qwen3:8b、embeddinggemma 就是)。風險在於——模型權重是一個巨大的二進位檔,無法像原始碼那樣逐行讀過,只能信任來源。萬一它被植入了後門(例如遇到某個特定觸發詞就洩漏資料),幾乎看不出來。pip install 進來的每一個套件,以及它們各自又相依的套件(相依鏈可能有上百個)。風險包括:被植入惡意程式的套件、名稱極為相似的假冒套件(名稱搶注,typosquatting,攻擊者上架一個和熱門套件只差一兩個字母的惡意套件,賭的就是開發者打錯字時裝到它)、以及本身含有已知漏洞的舊版本。這四類的共同特徵是:風險不在自己的程式碼裡,而在「信任」的東西裡。 傳統資安花大力氣檢查自己寫的程式,卻常常對這些「拿來就用」的第三方元件毫無防備——而近年最嚴重的幾起資安事故,正是從這裡爆發的。
供應鏈這個題目聽起來龐大,但治理它的核心動作其實很樸實,就兩步:先盤點,再釘選與驗證。 這條路徑如下圖所示,展開來是盤點、釘選、驗證三個動作。
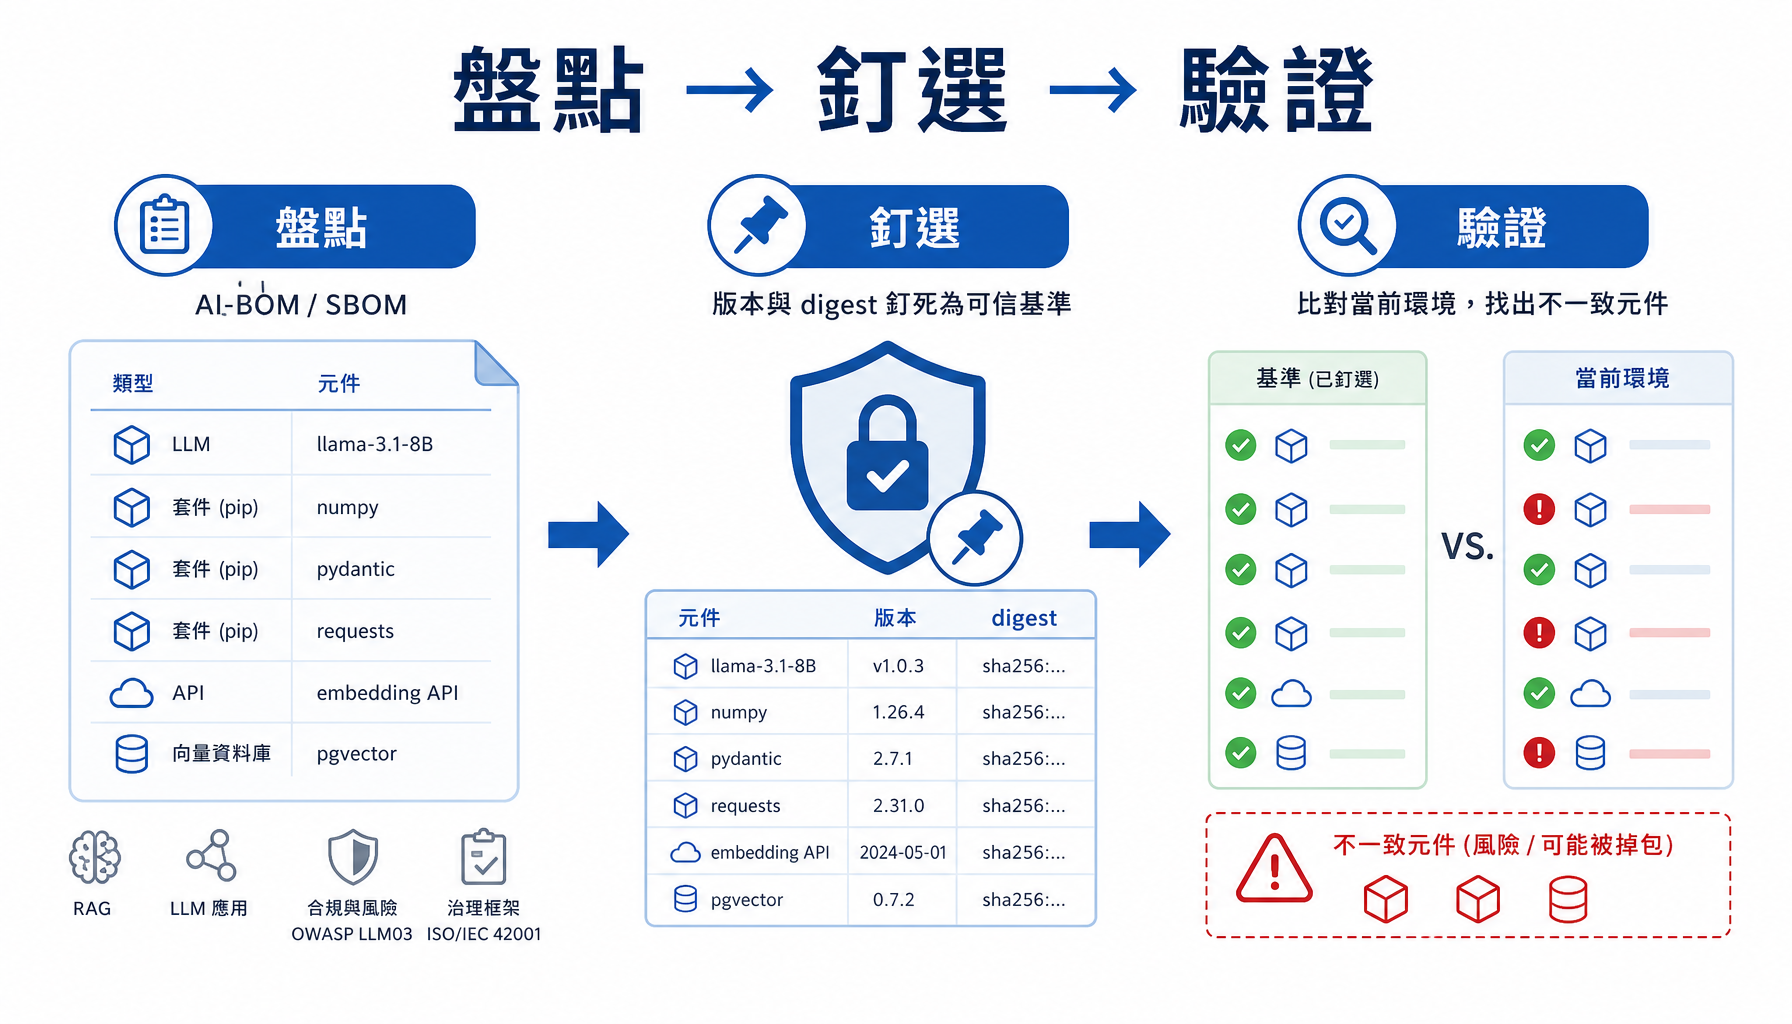
下面就把這兩步做成一支可跑的程式。
我們替本系列的 RAG demo 寫一支供應鏈盤點與驗證工具(完整檔在 程式碼/Day28/ai_bom.py),治理對象就是我們一路用到的模型與套件。
先宣告「這個專案用到哪些第三方元件」,再去環境裡把它們實際的版本與指紋撈出來:
from importlib.metadata import version, PackageNotFoundError

import ollama

# 這個專案「用到」的第三方元件(要治理的對象)
USED_MODELS = ["qwen3:8b", "embeddinggemma:latest"]
USED_PACKAGES = ["ollama", "numpy"]


def collect_bom() -> dict:
    """盤點目前環境實際安裝的模型與套件,產生 AI-BOM。"""
    installed = {}
    for m in ollama.list()["models"]:
        installed[m.get("model") or m.get("name")] = m.get("digest", "")

    models = [{"name": n, "digest": installed.get(n, "(未安裝)")} for n in USED_MODELS]

    packages = []
    for p in USED_PACKAGES:
        try:
            packages.append({"name": p, "version": version(p)})
        except PackageNotFoundError:
            packages.append({"name": p, "version": "(未安裝)"})

    return {"models": models, "packages": packages}
collect_bom() 做兩件事:用 ollama.list() 撈出每個模型實際安裝的 digest(Ollama 為每個模型算的內容指紋,內容一改,指紋就變),再用 Python 標準庫的 importlib.metadata.version() 撈出每個套件實際安裝的版本。產出的就是一份「當下環境到底裝了什麼」的 AI 物料清單。
盤點只是知道「現在裝了什麼」,還要有一份「應該是什麼」的基準來比對。這份基準,是在某個時間點、我們檢查過並信任的版本與指紋快照:
# 基準清單(盤點當下、經信任後記下的版本與指紋)。
# 實務上這份基準會版控起來(像 requirements.txt 釘版本、加上雜湊),
# 作為「可信的供應鏈快照」;這裡直接寫在程式裡示範。
TRUSTED_MANIFEST = {
    "models": {
        "qwen3:8b": "500a1f067a9f782620b40bee6f7b0c89e17ae61f686b92c24933e4ca4b2b8b41",
        "embeddinggemma:latest": "85462619ee721b466c5927d109d4cb765861907d5417b9109caebc4e614679f1",
    },
    "packages": {
        "ollama": "0.6.2",
        "numpy": "2.5.1",
    },
}
這正是資安界說的「釘選(pin)」——不要用「最新版」這種浮動的說法,而是明確釘死「就是這個版本、這個指紋」。實務上,套件的釘選會寫在 requirements.txt(甚至加上每個套件的雜湊值),模型的釘選則記下 digest。這份基準本身要版控起來,成為專案「可信的供應鏈快照」。
最後是驗證——拿當前環境的 AI-BOM,逐項和可信基準比對:
def verify(bom: dict, manifest: dict) -> list[dict]:
    """逐項比對 AI-BOM 與可信基準,回傳每個元件的驗證結果。"""
    results = []
    for m in bom["models"]:
        expected = manifest["models"].get(m["name"], "")
        ok = (m["digest"] == expected)
        results.append({"type": "模型", "name": m["name"], "ok": ok,
                        "actual": m["digest"][:16], "expected": expected[:16]})
    for p in bom["packages"]:
        expected = manifest["packages"].get(p["name"], "")
        ok = (p["version"] == expected)
        results.append({"type": "套件", "name": p["name"], "ok": ok,
                        "actual": p["version"], "expected": expected})
    return results
verify() 的邏輯很單純:每個模型比對 digest、每個套件比對版本,只要有一項對不上,就標記為可疑。單純,但這正是供應鏈完整性驗證的核心——用一個機械式的比對,把「有沒有被動過手腳」變成一個確定的答案,而不是靠「應該沒問題吧」的僥倖。
主程式把三步驟串起來——先印出 AI 物料清單,再跑兩個情境的驗證(正常環境、以及模擬模型被掉包):
if __name__ == "__main__":
    bom = collect_bom()

    print("── AI 物料清單(AI-BOM)──")
    for m in bom["models"]:
        print(f"  [模型] {m['name']:22} digest={m['digest'][:16]}…")
    for p in bom["packages"]:
        print(f"  [套件] {p['name']:22} version={p['version']}")

    # 情境一:正常環境——當前環境與可信基準相符
    print_results("正常環境", verify(bom, TRUSTED_MANIFEST))

    # 情境二:模擬供應鏈攻擊——有人把 qwen3:8b 換成同名但被下毒的模型
    print("\n── 模擬:有人把 qwen3:8b 掉包成同名但被下毒的模型 ──")
    tampered = {"models": [dict(m) for m in bom["models"]], "packages": bom["packages"]}
    for m in tampered["models"]:
        if m["name"] == "qwen3:8b":
            m["digest"] = "deadbeef" + m["digest"][8:]   # 內容被換掉,指紋就變了
    print_results("被掉包的環境", verify(tampered, TRUSTED_MANIFEST))
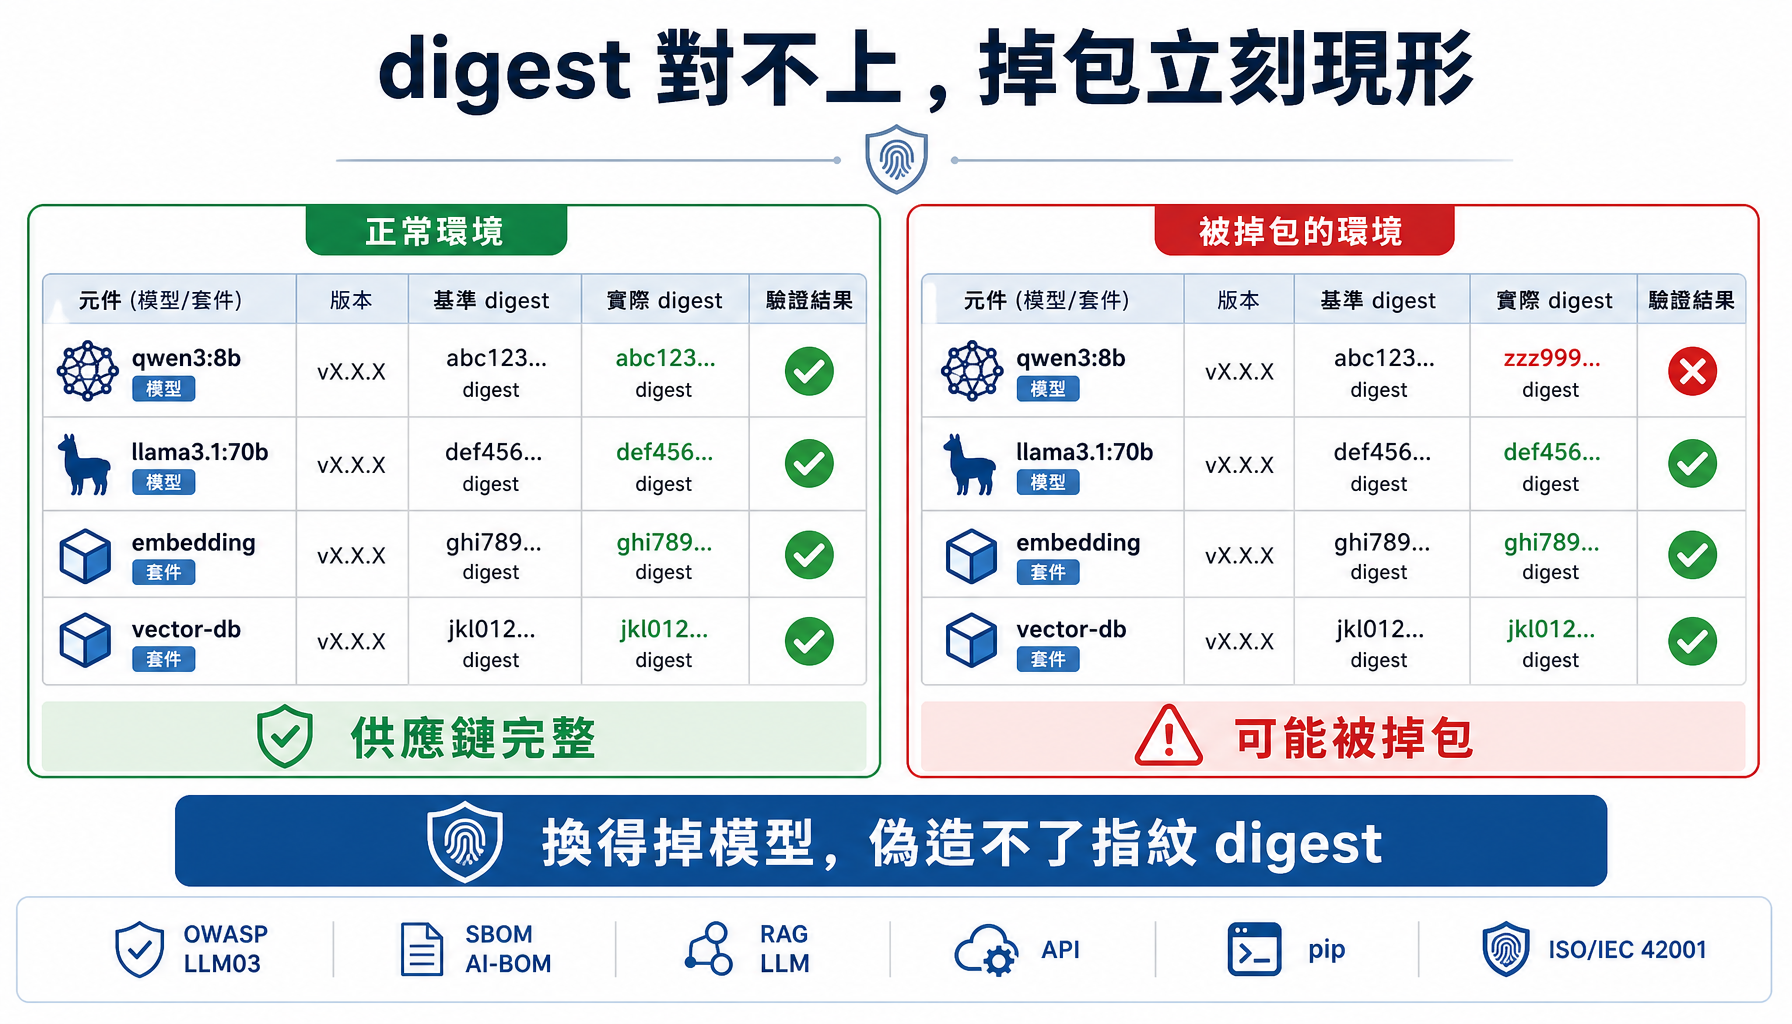
其中 print_results() 負責把驗證結果逐項印出並回報整體是否相符(完整程式在 程式碼/Day28/ai_bom.py);情境二用 deadbeef 開頭覆蓋掉 qwen3:8b 的 digest,模擬「模型被換成同名下毒版、內容一改指紋就變」。兩個情境的對照如下圖所示,實際執行輸出如下:
── AI 物料清單(AI-BOM)──
  [模型] qwen3:8b               digest=500a1f067a9f7826…
  [模型] embeddinggemma:latest  digest=85462619ee721b46…
  [套件] ollama                 version=0.6.2
  [套件] numpy                  version=2.5.1

【供應鏈完整性驗證:正常環境】
  [模型] qwen3:8b               🟢 相符
  [模型] embeddinggemma:latest  🟢 相符
  [套件] ollama                 🟢 相符
  [套件] numpy                  🟢 相符
  ── ✅ 供應鏈完整,所有元件與基準相符

── 模擬:有人把 qwen3:8b 掉包成同名但被下毒的模型 ──

【供應鏈完整性驗證:被掉包的環境】
  [模型] qwen3:8b               🔴 對不上(可能被掉包)
        基準:500a1f067a9f7826…  實際:deadbeef7a9f7826…
  [模型] embeddinggemma:latest  🟢 相符
  [套件] ollama                 🟢 相符
  [套件] numpy                  🟢 相符
  ── ❌ 發現不一致!有元件與可信基準對不上,需人工調查
第一個情境是正常環境,四個元件的指紋與版本全部與基準相符,驗證通過。第二個情境,我們模擬一個供應鏈攻擊——有人把 qwen3:8b 掉包成一個同名、但內容被下毒的模型。因為模型內容變了、digest 就跟著變(模擬成 deadbeef… 開頭),驗證立刻抓出「對不上」,並明確指出是哪個元件、基準與實際各是什麼。
這就是供應鏈治理的價值:攻擊者可以把模型換成同名的下毒版本,卻無法偽造出一模一樣的指紋。 只要有釘選與驗證,這種「偷天換日」就會在比對的那一刻現形。
把上面的原理,整理成一份可以直接照著做的治理清單——這也是本系列白皮書「供應鏈」欄位的雛形。下圖整理了四類供應鏈與主要治理動作:
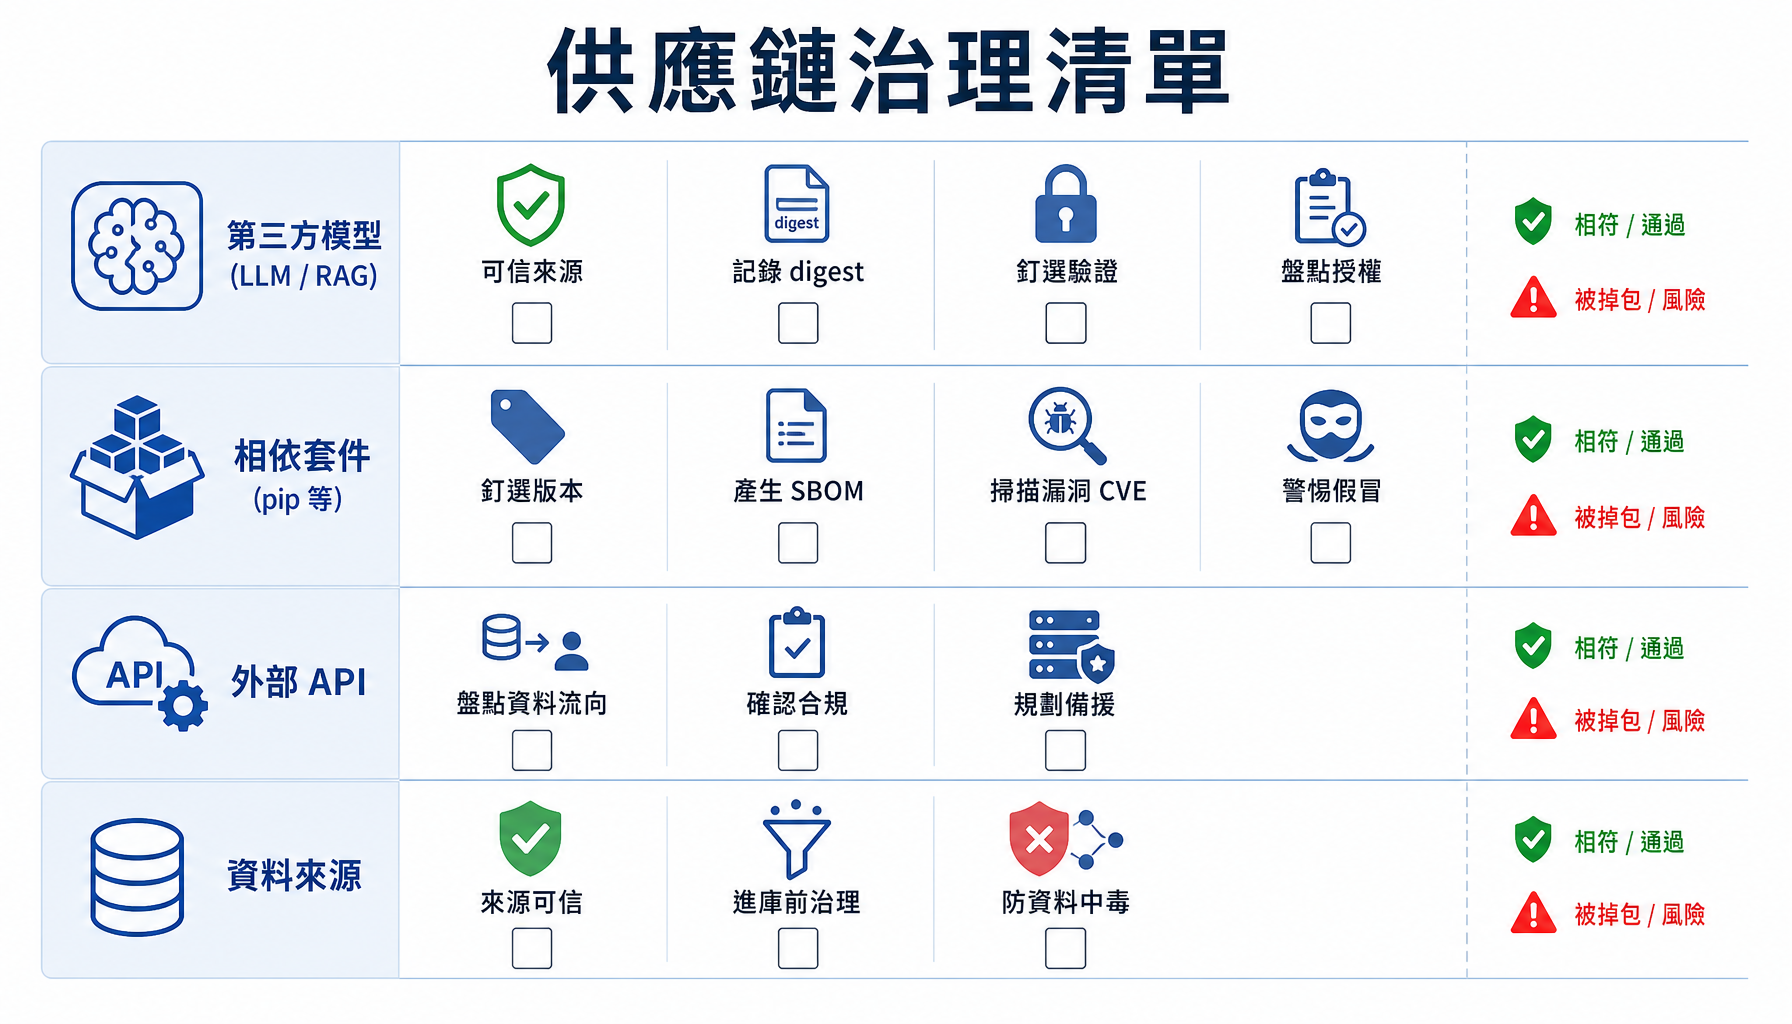
這份清單的精神,可以濃縮成一句話:每一個用到的「別人的東西」,都要說得出它是什麼、從哪來、可不可信。 說不出來,就是風險。
把供應鏈治理接回貫穿本系列的對映總表(Day 21)。下圖呈現這組對映:
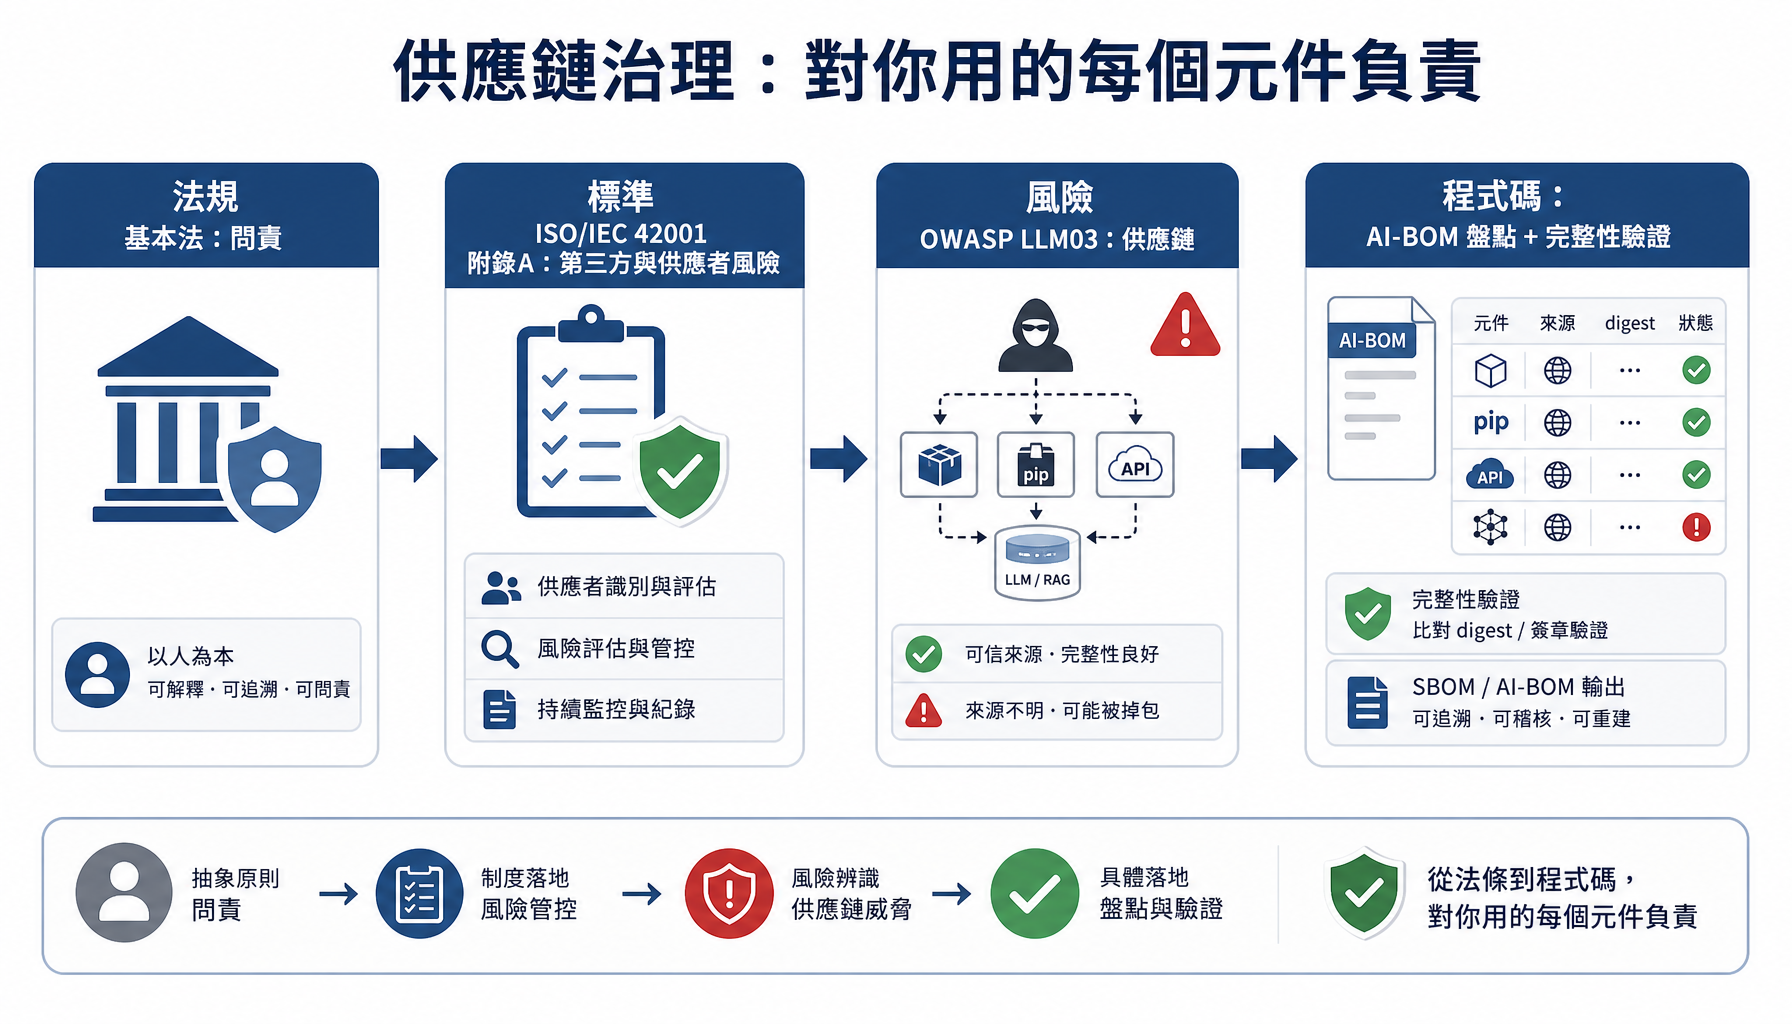
這裡特別對應到 OWASP 的「供應鏈(LLM03)」——它明確把「第三方模型、套件、資料來源」列為 LLM 應用的重大風險類別。而基本法的「問責」原則也在此有了新的一層意義:既然要為整個系統負責,就包括為它用到的每一個第三方元件負責——出事時總不能說「那是我下載的模型自己有問題」。 一份 AI-BOM,就是「我對我的供應鏈心裡有數」的證據。
今天的指紋驗證,解決的是「這個元件有沒有被掉包/竄改」,但它有幾個管不到的地方:
所以供應鏈治理和前面每一層一樣,不是「跑一次驗證就高枕無憂」,而是一套要持續運轉的紀律:盤點、釘選、驗證、定期複查。
今天處理了一個跨層、卻最容易被忽略的風險——供應鏈:
到這裡,第四階段的技術實作示範(Day 21–28 這八天)告一段落——RAG 五層防禦、紅隊驗證、供應鏈治理都走過了一遍。接下來的 Day 29–30 同屬第四階段,但任務不同:這些散落在八天裡的技術控制,該怎麼收攏成一份能直接拿去用的東西?
明天(Day 29)進入整個系列的核心交付物——AI 專案資安合規檢核表。 我們會把 Day 1 到 Day 28 的所有內容——法規原則、ISO/IEC 42001 控制、AIEC 評測項目、技術控制——收斂成一份可勾選的檢核表,每一項都對應「法條→標準→評測→技術」,並附上「怎麼驗證」。這份檢核表,就是本系列白皮書的核心。
程式碼/Day28/ai_bom.py(AI 物料清單與供應鏈完整性驗證)。程式盤點本系列 RAG demo 用到的模型(qwen3:8b、embeddinggemma)與套件(ollama、numpy),digest 與版本為本機環境真實值;「被掉包」情境的 deadbeef… 指紋為模擬示範。實作用本機 Ollama,結果為真實執行輸出。

 iThome鐵人賽
 看影片追技術