
第四天,我們要正式踏入 Python 資料分析最強大的核心套件——Pandas。昨天學習了底層的 NumPy 數值運算,而 Pandas 就是建立在 NumPy 之上,提供了更貼近 Excel 試算表的高階操作。在 Pandas 中,資料結構主要分為兩種:一維且帶有標籤索引的 Series,以及二維結構的資料表 DataFrame。今天我們透過純 .py 腳本建立 day04_pandas_basics.py,一步一步掌握它們的建立方式與取值邏輯。
第一部分
新建 day04_pandas_basics.py。首先認識一維結構 Series,它就像是 Python 的清單,但最大優勢在於能自訂具備語意的索引標籤(Index),而且能直接呼叫內建的統計函式(例如 .sum()):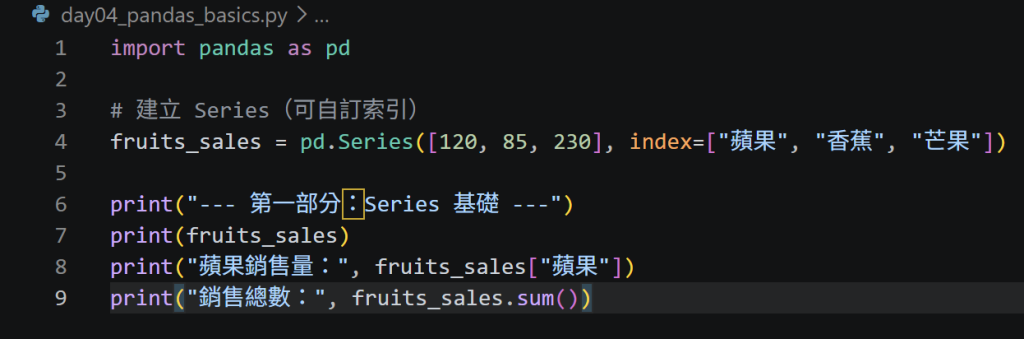
第二部分
接著建立二維資料表 DataFrame。最常見的做法是傳入「鍵(欄位名)對應清單(欄位值)」的字典。在提取欄位時需特別注意:單層中括號 df["部門"] 取出的結果本質就是一個 Series,而雙層中括號 df[["姓名", "績效分數"]] 則會保留 DataFrame 表格型態: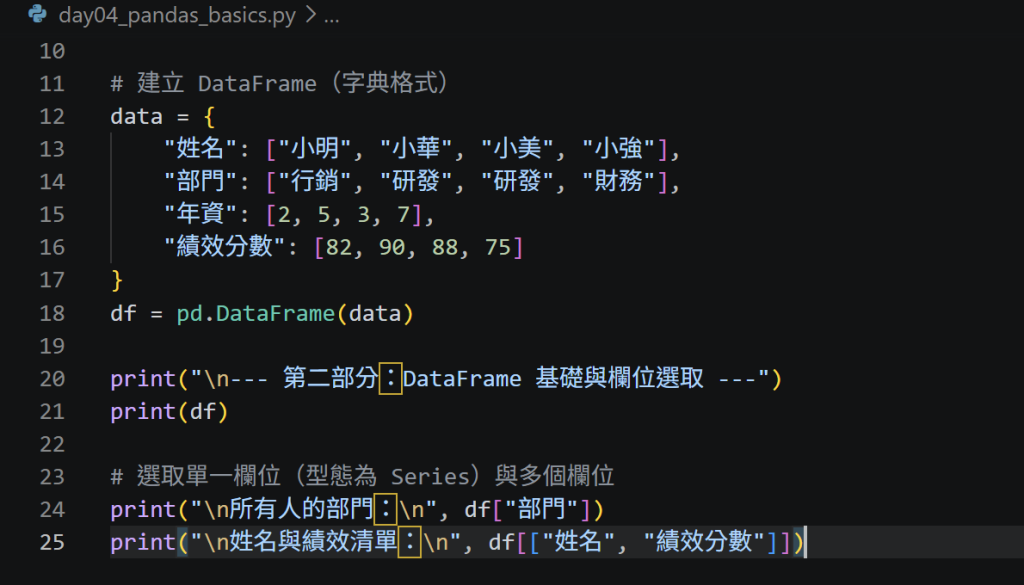
第三部分
最後是實務分析時最常用的取值與篩選功能。我們使用 iloc 透過整數索引直接定位資料列;同時利用條件布林判斷進行多條件過濾。在 Pandas 中做複合條件篩選時,原生 Python 的 and 必須寫成元素級別的比對符號 &,且每個條件都要用小括號包起來: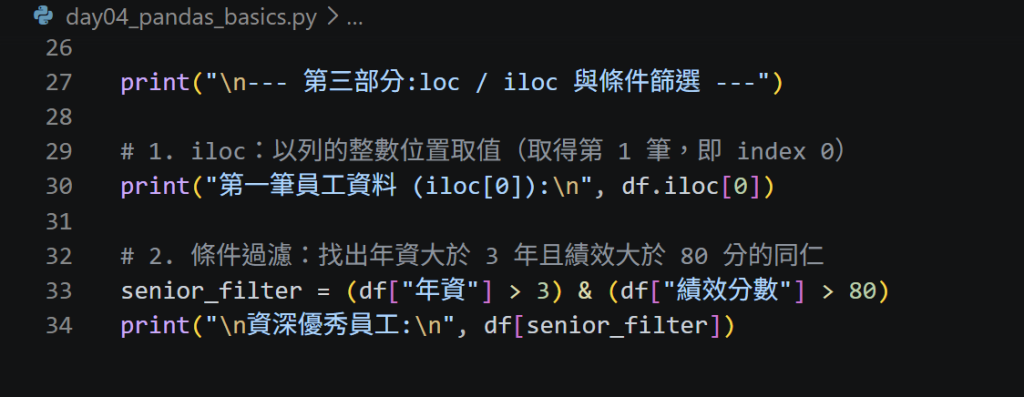
執行 python day04_pandas_basics.py 後,終端機順利印出 Series 運算結果、DataFrame 表格以及條件篩選後的數據。
第四部分
記得按 Ctrl + S 儲存檔案後,將今天的進度推送到 GitHub 進行版本控制: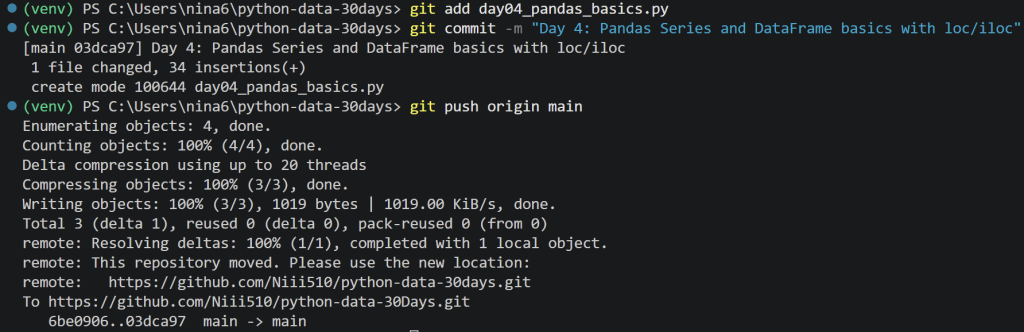
終端機提示推送成功,回到 GitHub 重新整理頁面,就能看到今天寫好的程式檔。
今日心得/遇到的問題
今天釐清了 Series 與 DataFrame 之間的層級關係:DataFrame 其實就是由多個共用索引標籤的 Series 所拼裝而成的二維資料表。在實作複合條件過濾時,一定要記得替每個條件加上小括號 () 並使用 &,如果直接寫成 and 就會跳出 ambiguous truth value 的常見語法報錯,這個細節在未來做資料清洗與萃取時非常關鍵!

 niii

 iThome鐵人賽
 看影片追技術