
Hi 大家好,我是 David,目前在 Synology 擔任軟體工程師,主要負責備份相關功能。
因為平常就喜歡研究一些 Harness/AI Agent 相關技術,今年主管也把幾個內部專案交給我,因此有機會設計一些不同場景專用的 Harness,私底下也有做一個小機器人幫助記性不好的我安排行程,記帳,順便拿多的 Token 來嘗試各種不同架構。
去年在跟一位同事聊天的時候推薦他來挑戰鐵人賽,沒想到他一路撐完三十天,在沒有屯稿的情況下每天還是咬牙堅持,最後拿到了佳作,推坑的人自己卻沒有完賽過,今年趁這個機會來挑戰一下,順便彌補當年研究所選錯題目,最後想不到要寫甚麼而挑戰失敗的遺憾。
實際開始設計 Harness 之後,才發現平常使用 Claude Code 或 Codex 時覺得理所當然的事情,背後都要有人想清楚,像是按下停止之後還在跑的工具要怎麼處理、對話太長壓縮時哪些內容不能丟、哪些操作要先問過人,這些問題當使用者的時候幾乎不會想到,自己動手做才一個一個冒出來。
然後又遇上今年 Claude Code 外流事件,大量 Harness 的設計手法跟著流出,社群突然有了對答案和借鏡的機會,隨後各種資源開始冒出來,Harness 也正式進入大爆發的時代,同時 Codex 也逐漸嶄露頭角(這邊是個人淺見,因為初期我也是用 Claude Code 居多,或許年初的時候 Codex 就已經確定了架構)。
這段期間我很常參考 OpenAI、Anthropic、Shopify、Cursor 這些團隊公開的文件和工程文章,看他們碰到類似的狀況怎麼設計、做了哪些取捨。只是資料一多就散落各處,每篇講的又是自家產品的條件,讀完常常得自己再整理一次,才知道哪些做法搬得到自己的場景。當然,更多文章是收藏從未停止、行動從未開始 XD,所以想趁這次機會把零散的知識整理起來,也把囤積已久的文章好好讀過一輪,希望能幫大家對 Harness 建立比較有系統的認識。
這個系列分成五個部分,後面會再細講。每篇會從一個具體問題出發,先看它怎麼發生,再對照幾家公開的做法,最後整理出設計時可以參考的判斷。前後篇有些會接著討論同一件事,但也可以直接挑自己在意的主題來讀。
希望讀完之後,不管是正在做 Agent 產品,還是像我一樣替自己寫小工具,遇到問題時都能比較快找到該從哪一層下手。那就先從最基本的開始,看看一次 LLM Request 是怎麼一路長成 Agent Loop 的。
假設你有一段測試失敗的 log,想請模型幫忙解釋。最直接的做法,就是把問題和 log 一起送過去,等它回答。
LLM Request 就是你的程式對模型服務發出的一次 request。 裡面帶著這次的指令、輸入和一些設定,服務處理完再把模型的輸出傳回來。下面都是說明流程用的 pseudocode,不是哪個 SDK 的真實 API:
response = llm.generate(
    instructions="根據提供的紀錄解釋問題,資料不足就明說。",
    input=[user_message("請解釋這段測試失敗紀錄:...")],
    tools=[],
)
print(response.text)
模型這一次實際拿到的所有資訊,就叫做 Context,可能有指令、問題、先前的對話、檔案內容和工具說明。模型看不到你的整個硬碟,也看不到系統存過的其他資料,你沒把完整的 log 給它,它就不會知道被省略的那些內容。
這裡先看最單純、沒有內建工具的 request。多輪聊天的歷史,可以由你的程式每次重新帶進去,也可以交給服務保存,但總得有人負責。聊天介面之所以記得前文,是外面的系統幫忙記的,模型本身每次 request 結束就什麼都不留。
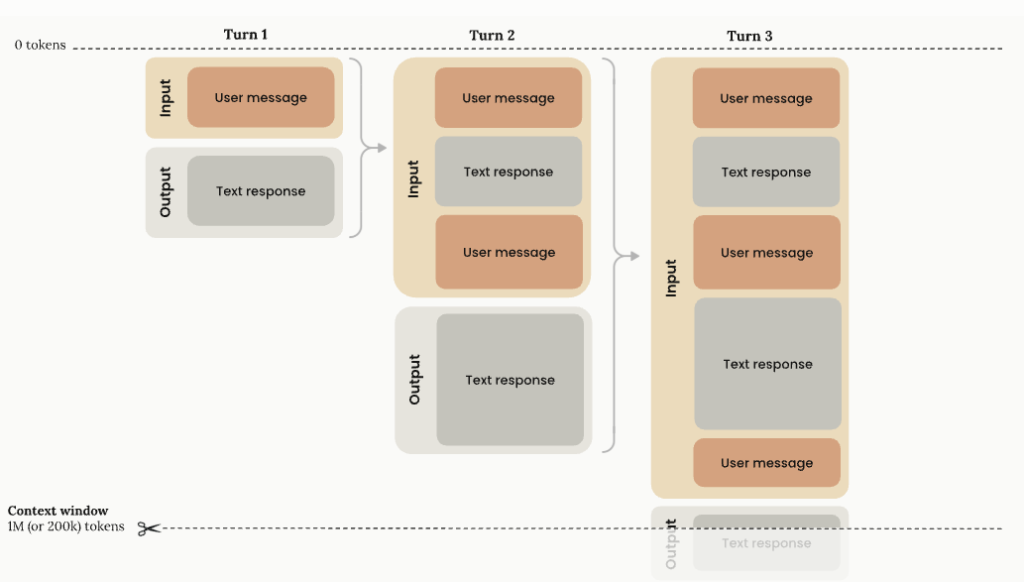
圖:每一輪送給模型的 input,都要把前面的使用者訊息和模型回覆一起帶上,所以會越來越長,超過 context window 就會被截斷。圖片來源:Anthropic|Context windows
接下來,你不想每次都自己去找 log、貼程式碼,能不能讓模型自己決定還需要看什麼?
可以,先告訴它有哪些工具能用,例如 read_test_log 和 read_source。工具說明只寫用途和參數,真正去讀檔案的程式碼還是在模型外面。
Tool Call 是模型輸出的一個「請幫我執行工具」的要求,裡面有工具名稱、參數,還有一個用來對應結果的 call ID。 例如模型說:用 read_test_log 讀 job-42 的 log。這時候只是提出要求,log 還沒有被讀取。
程式收到要求後,會先檢查工具、參數和存取範圍,沒問題才真正執行,再把結果連同對應的 call ID 送回給模型。OpenAI 的 Function calling 文件 講的就是這一來一回;如果是服務商自己提供的內建工具,就由服務端直接執行。
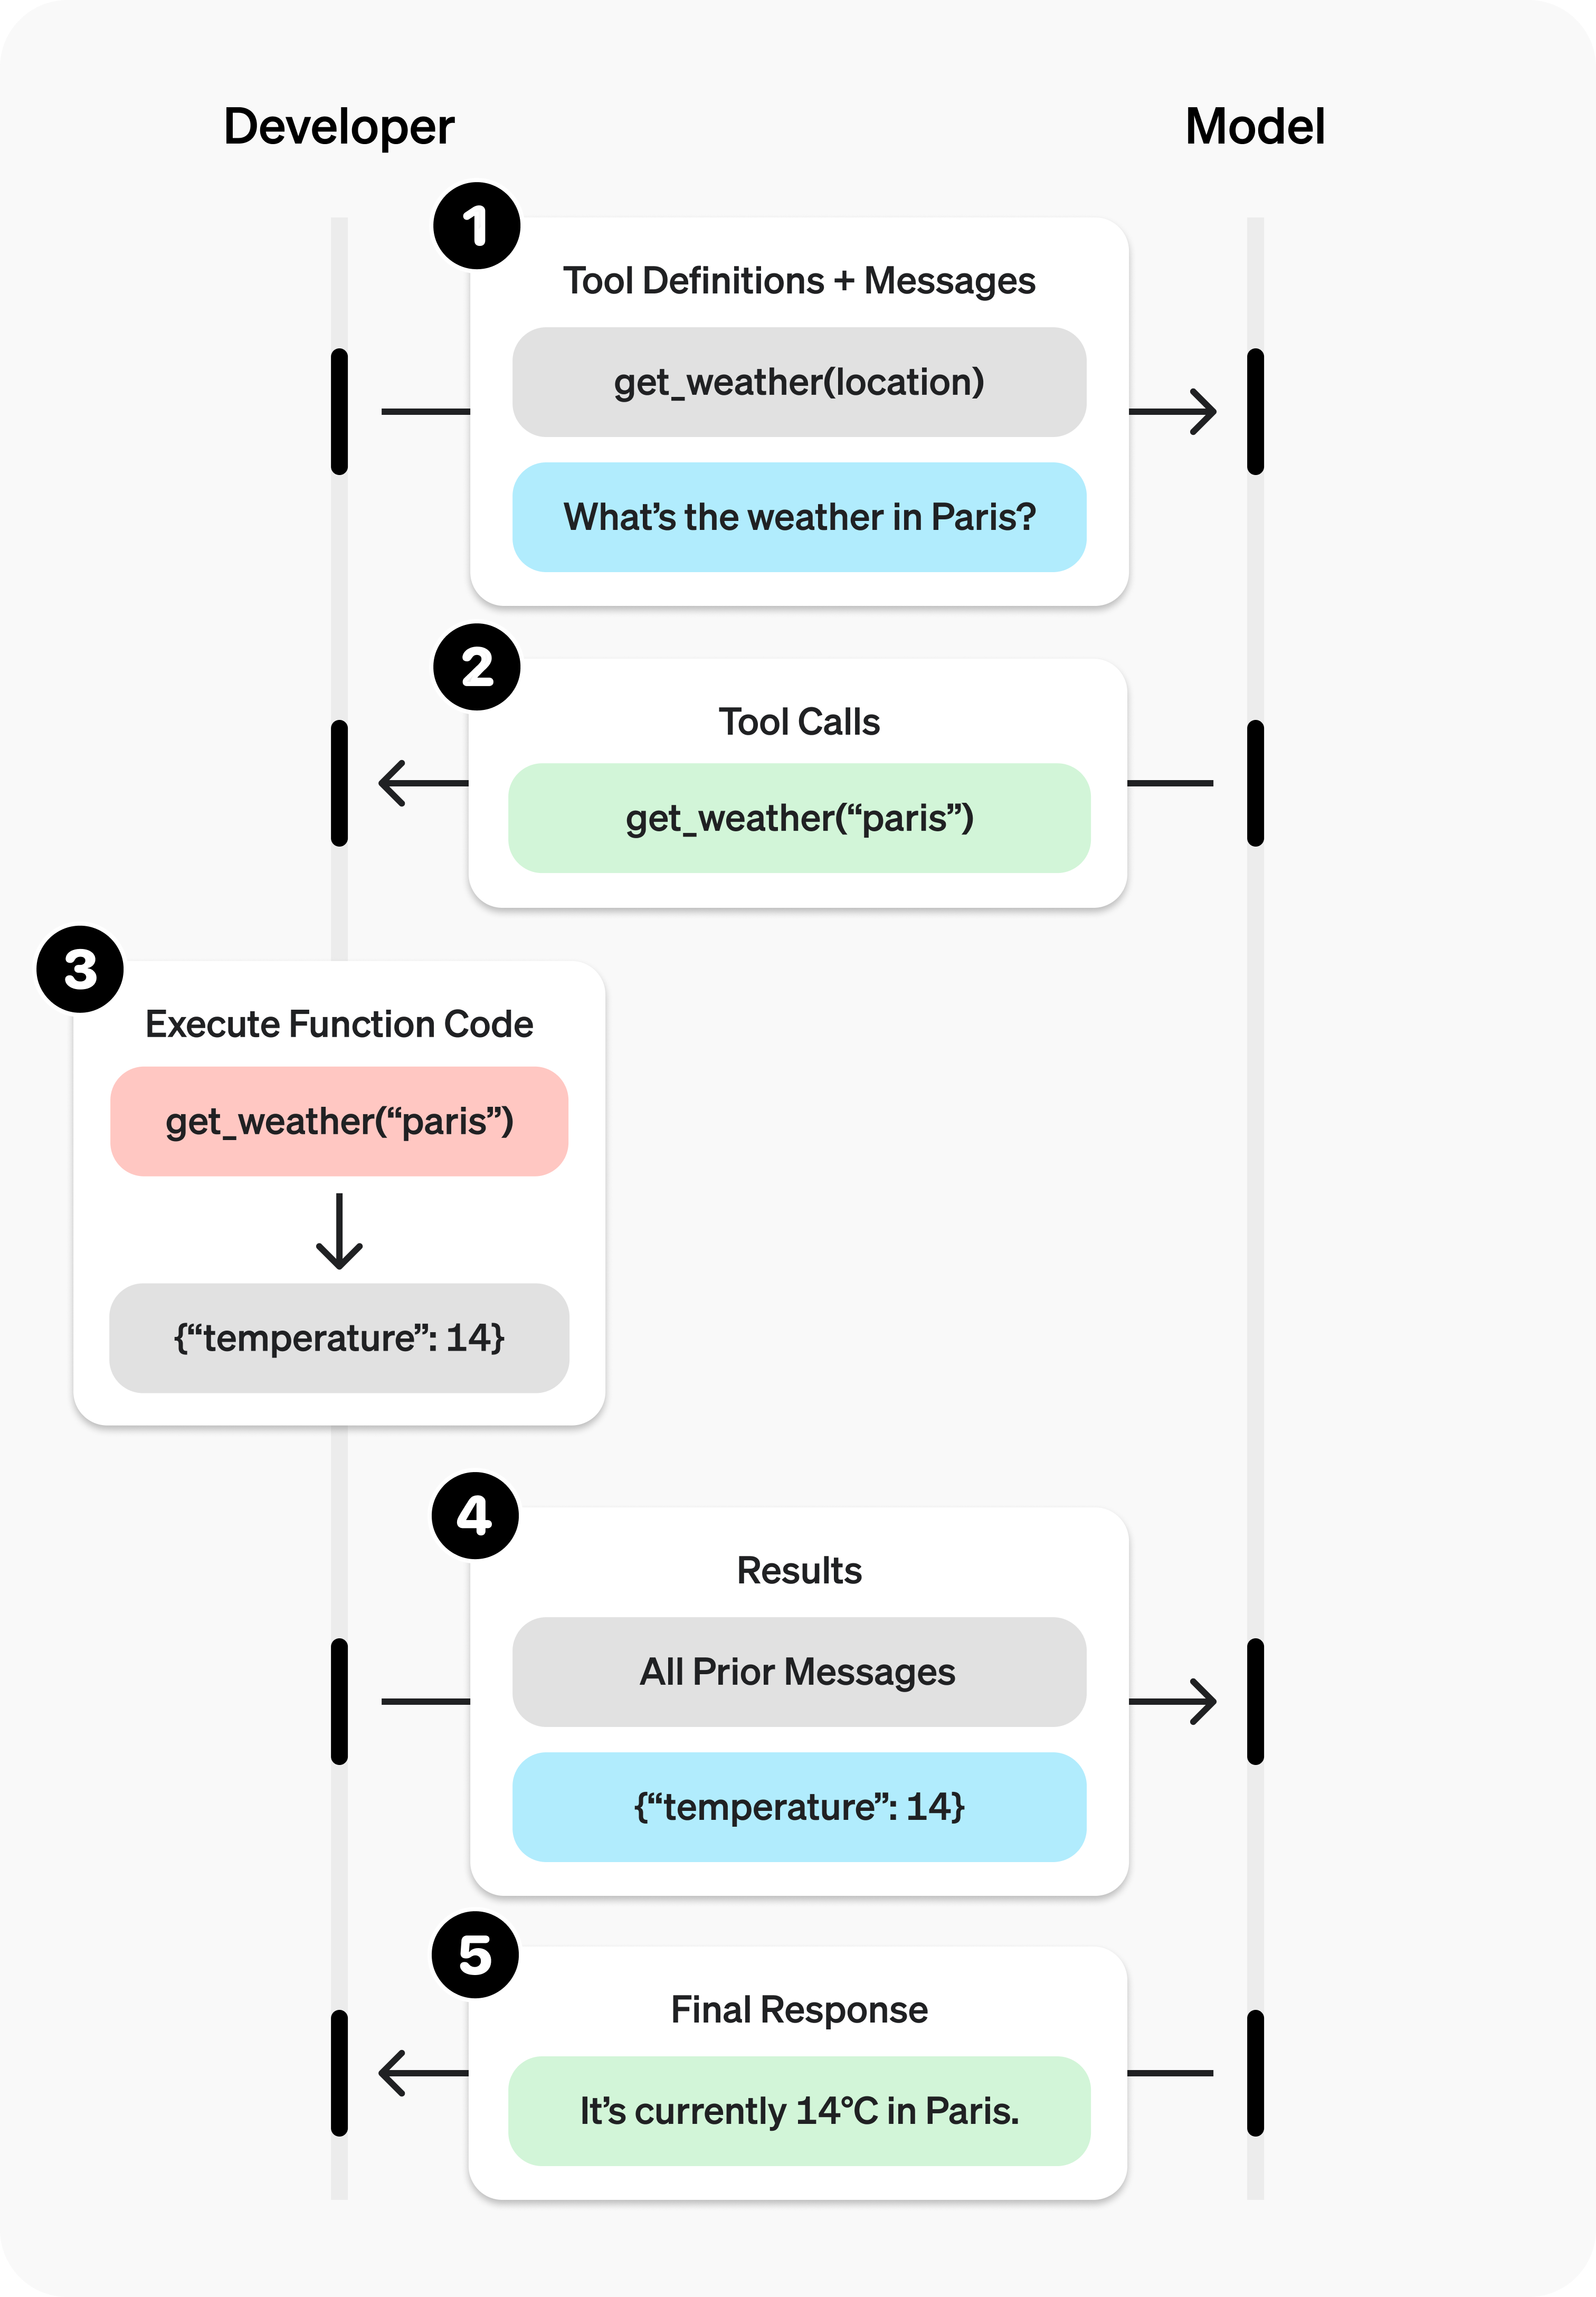
圖:模型在第 2 步只回傳 Tool Call,第 3 步真正執行 function 的是開發者的程式;第 4 步送回結果時,先前的訊息也要一起帶上。圖片來源:OpenAI|Function calling
模型讀完 log,可能發現還得看某個 function;讀完程式碼,才有足夠的資訊回答。下一步要做什麼,是模型看完剛拿到的結果才決定的。
業界現在最常引用的說法,是 Simon Willison 整理出來的一句話:「An LLM agent runs tools in a loop to achieve a goal.」,也就是 LLM 為了完成目標,在 loop 裡 反覆使用工具(原文)。Anthropic 的說法也差不多:「Agents are models using tools in a loop」(出處)。Amp 的 Thorsten Ball 講得更直白:「It's an LLM, a loop, and enough tokens.」,他還示範了用不到 400 行程式碼 做出一個 Agent(How to Build an Agent)。
拆開來看,模型負責決定下一步要用什麼工具,外面的程式負責執行,再把結果送回去;「達成目標」則代表這個 loop 要有停下來的條件,不會一直跑下去。每一輪大致是四個步驟:① 準備資訊 → ② 呼叫模型 → ③ 處理模型的要求 → ④ 把結果送回,這樣一輪一輪跑下去,就是 Agent Loop。
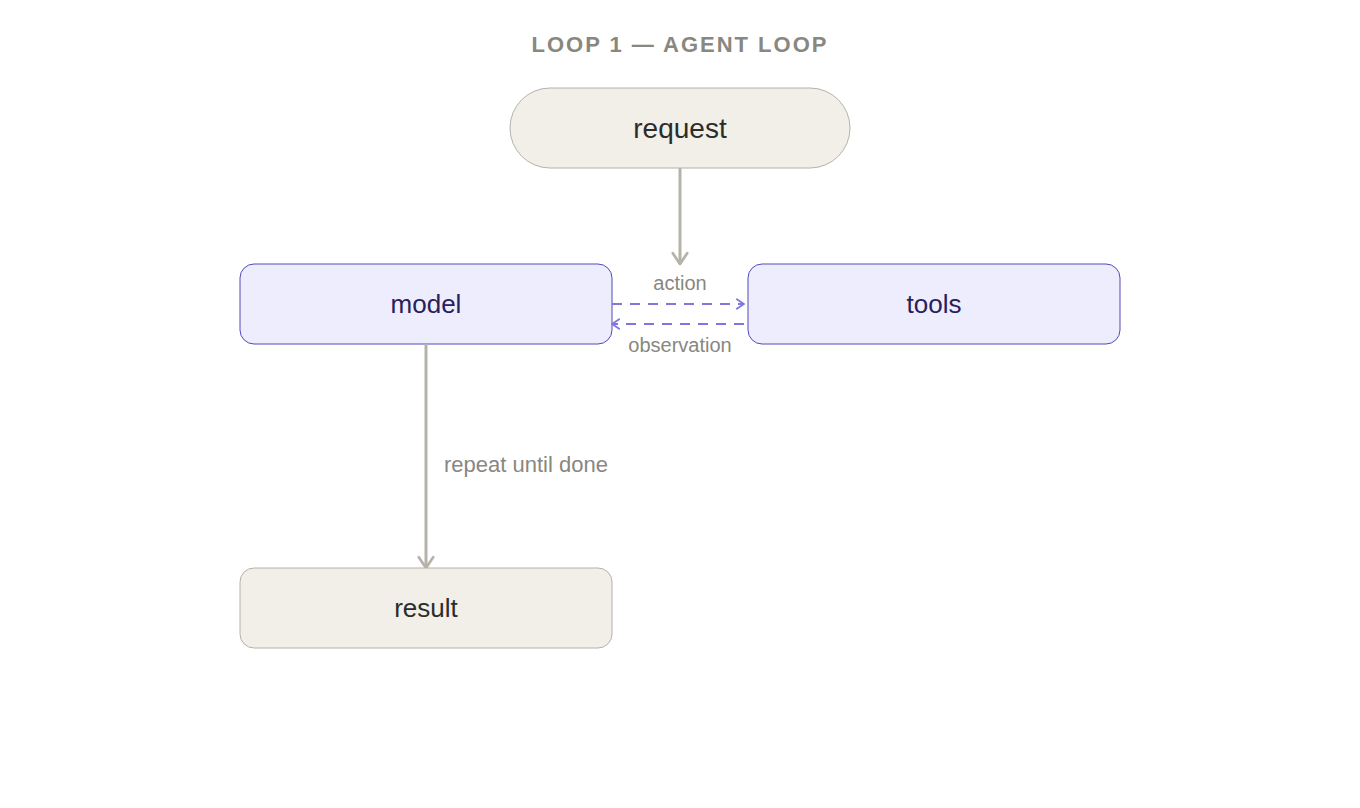
圖:action 就是前面講的 Tool Call,observation 是工具執行完送回來的結果,一直重複到任務完成。圖片來源:LangChain|The Art of Loop Engineering
最簡單的版本大概長這樣:
# pseudocode:不綁定任何 SDK,只開放唯讀工具,先不處理修改與 retry。
MAX_STEPS = 10

def run_agent(task):
    tools = readonly_tools("read_test_log", "read_source")
    history = [user_message(task)]  # 對話歷史由外面的程式保存

    for step in range(MAX_STEPS):
        # ① 準備資訊、② 呼叫模型:每一輪都送出完整歷史和工具說明
        response = llm.generate(input=history, tools=tools.schemas, timeout=30)
        history.append(response.message)  # 模型這一輪的輸出也要記進歷史

        # ③ 處理模型的要求:模型沒有要用工具,loop 就停下,但不代表任務成功
        if not response.tool_calls:
            return stopped("no_tool_calls", output=response.text)

        for call in response.tool_calls:
            result = tools.run_checked(call, timeout=10)  # 先檢查工具名稱、參數、路徑再執行
            # ④ 把結果送回:配上 call_id 放進歷史,下一輪模型才看得到
            history.append(tool_result(call_id=call.id, result=result))

    return stopped("step_limit")  # 跑滿上限也不算完成

run_agent("找出 job-42 測試失敗的可能原因。")
response.message 是簡化過的寫法。實際的 API 一輪可能回傳好幾個項目,各家的格式也不一樣,要照各家的規定完整存下來,不能只存 response.text。另外,模型同一輪可能一次要求好幾個工具,上面是一個一個處理,每個結果都要配回原本那次呼叫。call.id 指的是用來配對結果的 ID,欄位名稱不一定叫 id,像 OpenAI 就叫 call_id(見 OpenAI|Function calling)。這些格式差異交給 SDK 或 provider adapter 處理就好,這裡就不另外發明一套了。
程式碼裡的 timeout 也不保證底層的工作真的停了。以 Python 為例,Popen.communicate(timeout=...) 發生 timeout 時不會自動 kill 掉 subprocess,subprocess.run(timeout=...) 則會把它終止並等它結束。所以 executor 要講清楚,自己只是不等了、送出了取消,還是已經確認工作結束。怎麼把還在跑的工作收乾淨,後面再細談,第一天的 loop 先不處理(詳見 Python subprocess 文件,不過這只是 Python 的行為,換成別的 executor 不一定一樣)。
照著程式跑一次:第一輪模型要求讀 log,第二輪根據 log 要求讀程式碼,第三輪整理出答案。它之所以會「繼續做」,是因為外面的程式又呼叫了一次模型,request 結束之後 ,模型自己是不會繼續跑的。
這裡刻意寫成 stopped,而不是 success。模型沒有再要求工具,只代表這個 loop 不會自動往下跑,它的回覆可能是答案、可能是拒絕,也可能是請使用者補資料。跑滿十輪只是碰到上限,同樣不代表工作完成。任務怎樣才算成功,後面再加上驗收條件。
有 loop,也不一定就是 Agent。 如果程式固定照「查資料 → 摘要 → 寄出」的順序走,模型只負責寫摘要,這比較像事先排好的 workflow;Agent 則會根據拿到的結果,自己決定要用哪個工具、下一步做什麼。這個分法借自 Anthropic 的文章,各家產品的叫法不一定相同。
另外要注意,API request 的次數不一定等於 loop 跑了幾輪,有些服務會在一次 request 裡自己跑好幾輪模型和內建工具。上面的 pseudocode 把這些步驟攤開來寫,是為了看 清楚每一段是誰在做。
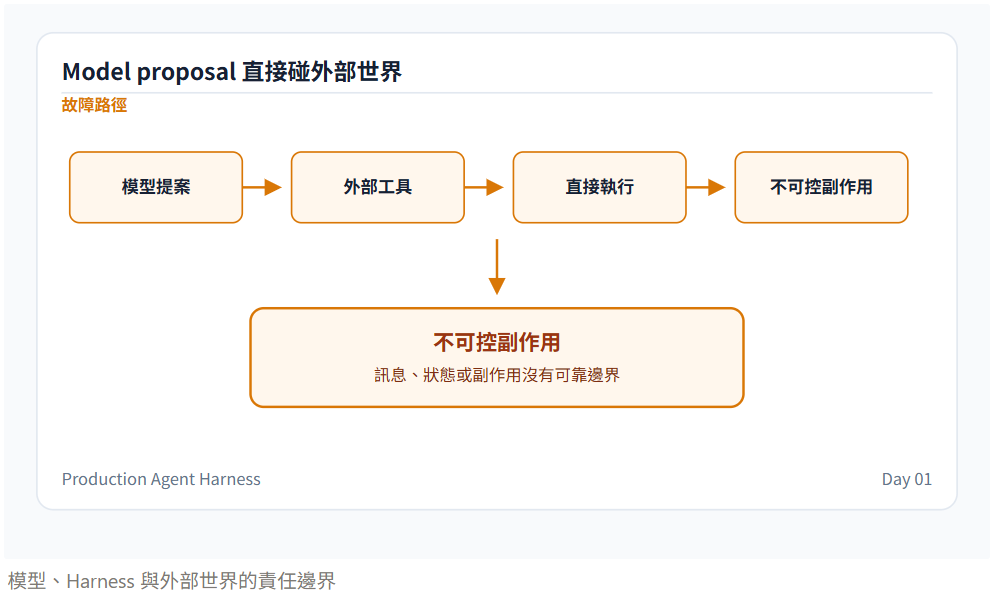
再看一次上面的 pseudocode:誰保存歷史?誰呼叫模型?誰把工具要求交給真正的程式?誰決定不再繼續?答案都是模型外面的那一層。
本系列說的 Agent Harness,指的就是模型之外、負責組織與控制 Agent 執行流程的那一層:組裝 Context、串接模型與工具、處理回傳的結果,並決定繼續、等待還是停止。
模型提出「接下來做什麼」,Harness 負責讓這一步在允許的條件下發生,再把結果帶回來。
所以剛才那段 loop,就已經算是最小的 Harness 了,不用另外蓋一套平台,也不需要先有 multi-agent、vector database 或哪個 framework。執行工具、整理輸入、判斷什麼時候該停,都算 Harness 的工作。
被操作的檔案、瀏覽器、正在執行的指令和外部服務,則叫做 Environment,工具就是操作它們的介面。這些元件可以全寫在同一支程式裡,也可以拆成好幾個服務,怎麼部署跟誰負責什麼是兩回事。
例如 Shopify 的架構 就把保存歷史的 Session、跑 loop 的 Harness,以及執行程式的 Sandbox 分開。這裡只是借 Shopify 的切法來說明,不是每個系統都得照這樣命名。
把上面講的放在同一張圖裡看:
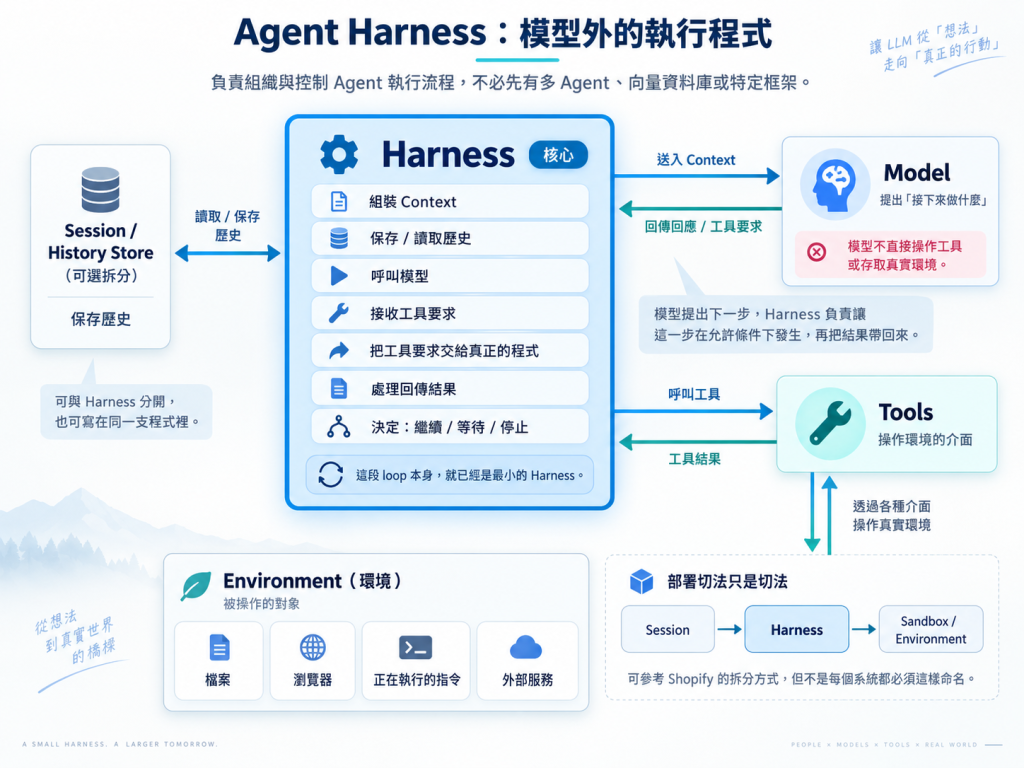
圖:Model 只提出「接下來做什麼」,不直接碰工具或真實環境;中間的 Harness 負責組裝 Context、保存歷史、呼叫模型、把工具要求交給真正執行的程式,再決定繼續、等待還是停止。Tools 是操作 Environment 的介面,檔案、瀏覽器、正在執行的指令和外部服務都算在 Environment 裡。右下角的 Session、Harness、Sandbox 要不要拆開,是部署上的選擇,寫在同一支程式裡也可以。
上面的 loop 拿來示範流程夠用了,但歷史只放在 memory 裡,使用者沒辦法中途取消,程式掛掉也接不回來,更沒有人檢查任務到底有沒有成功。模型服務一出錯,這段教學程式就只會直接退出。
等你真的把工作交給它,問題就變成:程式重啟後能不能接著做?使用者按了停止,還在跑的工具怎麼辦?模型說修好了,測試到底有沒有過?
Production Harness 用的還是同一套 Agent 原理,只是依任務的風險,把基本的 loop 補到出事時查得到、做完時驗得了。 要做到多完整,看任務而定,只是查個資料的唯讀任務,不需要一開始就搬出整套分散式架構。
OpenAI 在 Harness engineering 這篇文章裡就是這樣做的:除了讓 Agent 讀程式碼,也讓它能把應用跑起來,拿到測試結果和 log、metrics 這些觀測資料,改完之後自己檢查有沒有改對。
有些已知的問題,也適合直接交給程式處理。例如工具每次遇到同一種錯誤,模型都要重新摸索一次同樣的解法,那就可以把確認過的處理方式直接寫進 executor。不過如果操作會寄信或付款,得先查清楚第一次到底有沒有生效,不能遇到錯誤就一律 retry。
接下來三十天,就是一項一項回答這幾個問題:模型現在知道什麼?這一步允許它做什麼?要看到什麼證據,才算真的完成?
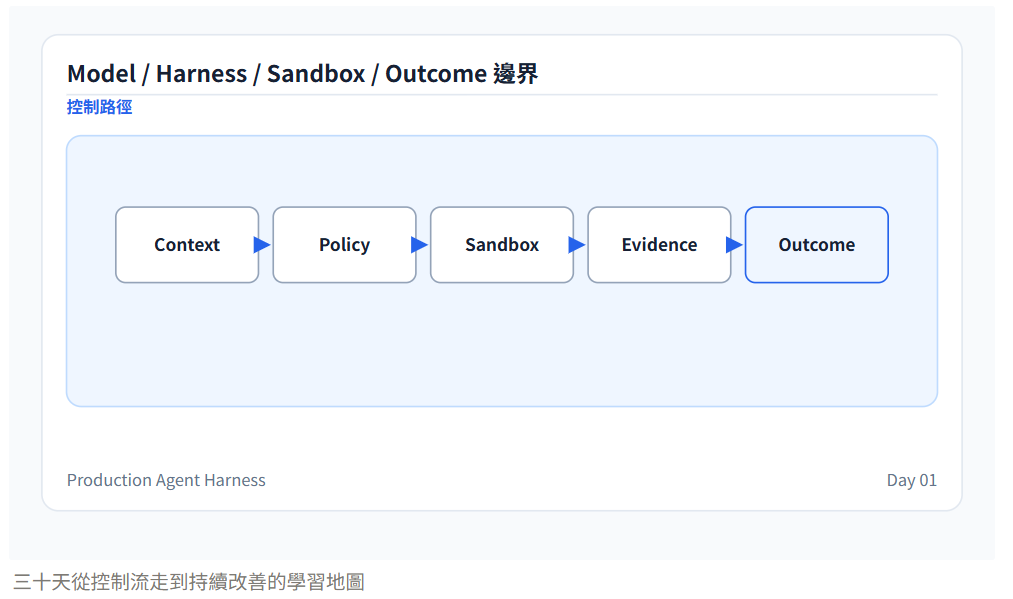
後面二十九天分成五個部分:
回到讀測試 log 的例子:模型提出要用 read_test_log,這是 Tool Call;executor 真的去讀了 log,這是工具執行;把 log 放進下一輪的輸入,這是 Context 組裝;一路安排這些步驟、決定什麼時候停,這是 Harness 的工作。
看到這裡,可以試著回答兩個問題:工具的結果存進了資料庫,但沒有放進下一輪給模型看,模型會知道嗎?模型最後說「原因找到了」,就能證明它真的找對了嗎?
第一題跟資訊怎麼送到模型手上有關,第二題跟驗證和評測有關,這兩題在系列後半講到執行紀錄和 Eval(用一組任務和評分方式來檢查系統表現)的時候,會再回來回答。
至於引用的資料,公司的工程文章用來看他們實際怎麼做,官方文件用來確認機制怎麼運作,我自己整理的做法會特別標明是建議。沒有公開資料可以佐證的例子,我會標成假設情境,免得大家把教學用的故事當成真實發生的事故。
Harness 決定模型看得到什麼、被允許做什麼、做完之後怎麼確認,讓結果不一定可靠的 LLM,也能一步步穩定地完成目標。
明天就從最常聽到的一句話開始:「Agent 做不好,那換個模型呢?」我們把這個問題拆開,看看換模型到底改到了哪一段。
Popen.communicate(timeout=...) 和 subprocess.run(timeout=...) 在 timeout 之後 的行為差異。

 iThome鐵人賽
 看影片追技術