
如果每個服務都自己接 ERP SOAP,就要各自處理 WSDL client、欄位轉換、認證與錯誤。服務多了以後,同一套介接工作也會重複出現。我想把這些事情集中整理,這就是這一篇要談 Adapter 的原因。
可以想像,第一支服務接上 ERP 時,欄位對好、資料取得到,就完成了一大步。等到第三支、第五支也接進來,同一個欄位可能有不同的轉法,同一種 SOAP fault 也可能各自處理。之後 ERP 一改,就得全部再確認一次。
這些差異不一定會立刻報錯。各服務都能運作,但對同一份資料的理解不一樣,等到對帳時才會慢慢看出問題。我會希望這些轉換規則,能有一個共同維護的地方。
這裡的 Adapter,就是用來承接 Anti-Corruption Layer 的工作。外面使用平台的 REST 或事件契約,裡面再處理 ERP SOAP、欄位、日期、錯誤碼與操作限制。把這一層整理好,業務服務就能專心處理自己的流程。
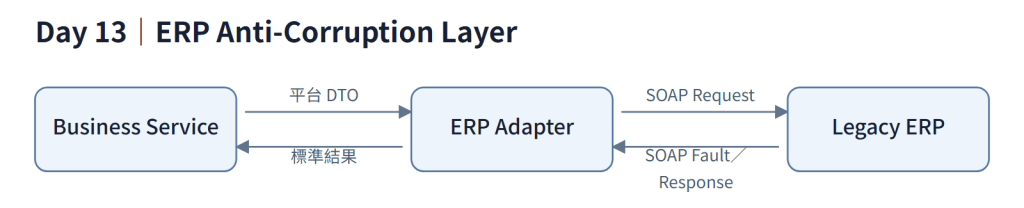
圖 Day 13-1:ERP Anti-Corruption Layer。
看這張圖時,我會順著一筆資料走:業務服務送出平台 DTO,Adapter 轉給 ERP,再把結果整理回來。如果業務服務還得知道 ERP 的欄位或錯誤碼,這份隔離就還有地方要補。
查詢一定要帶什麼條件、一次最多幾筆、哪些欄位要先取號,這類操作限制讓呼叫端各自處理,比較容易漏掉其中一項。所以除了格式,我也會把操作限制一起整理,集中處理。
另一條界線是資料歸屬。跨領域流程與新平台的核心資料仍由業務服務負責,Adapter 只處理介接,不保存平台的主資料。
接 ERP 的做法不只一種。我把常見的幾種放在一起比,用同一個情境看:ERP 廠商改了一個欄位,接下來誰要改、錯誤怎麼對、有沒有地方能看見所有呼叫。
| 做法 | ERP 改欄位時誰要改 | 轉換規則與錯誤對照 | 稽核與限流放哪 | 什麼情況下合理 |
|---|---|---|---|---|
| 各服務自接 SOAP | 每一支接過 ERP 的服務 | 各自一份,差異要到對帳才看得出來 | 分散在各服務,難以齊備 | 只有一支服務會碰 ERP,且短期不會再增加 |
| 共用 client 套件 | 套件改一次,但每支服務都要升版重新部署 | 程式碼同一份,版本卻容易不齊 | 仍在各服務內,沒有單一觀察點 | 服務少、同一團隊維護、部署節奏一致 |
| Adapter 服務(本系列的選擇) | 只改 Adapter;平台契約不變,呼叫端不動 | 一份規則、一處對照 | 集中在 Adapter,可一併記 metadata 與量 P95 | 多支服務要接 ERP,而且 ERP 介面會持續變動 |
| 整合平台(ESB/iPaaS) | 改平台上的流程設定 | 一致,但規則落在平台設定,版控與測試方式跟著平台走 | 平台內建 | 已有平台與維運人力,整合對象多且不只 ERP |
| 直連 ERP 資料庫 | 資料表一改,所有查過那張表的系統連帶受影響 | 繞過 ERP 的商業規則,沒有錯誤對照可言 | 幾乎沒有 | 只剩唯讀報表、ERP 廠商同意,而且已列入退場計畫 |
這張表不是要說 Adapter 永遠最好。服務只有一支的時候,自接反而簡單;整合對象很多、又有人力維運平台的公司,整合平台也合理。這個案例裡多支服務都要接同一套 ERP,而 ERP 介面還會變,所以我選 Adapter。至於直連資料庫,Day 02 的指標之一就是把直連系統數降下來,Day 08 也把它列在禁止方式。
實作時,先集中管理 WSDL client 與連線設定,再整理 DTO、錯誤碼對照、connect/read timeout 和 correlation ID。這些基本工作做好,後面新增介面也比較有一致的做法。
有些 client 的預設行為不會替我們限制等待時間,所以 timeout 這一項,我會特別確認實際設定。ERP 一慢,請求就可能持續占住連線,所以正常流程測完,也要模擬一次回應變慢的情況。
Log 先想清楚要用來回答什麼。我需要知道誰呼叫、做了哪個操作、結果與耗時如何,因此保留必要 metadata 就好,敏感 payload 不要整包寫進去。
Micrometer 的 meter 是延遲註冊(lazy registration):Timer 在第一次 record 之前不會出現在 registry,Prometheus 端點自然也抓不到。「有指標類別、卻沒有任何地方呼叫 record」這種漏洞,看 Dashboard 完全看不出來,只會覺得那條線一直是空的。所以 Log 之外,指標也要確認真的量到了,不是定義了就算。我寫了兩個小測試把這件事守住:
@Test
void timerAbsentBeforeFirstRecord() {
    PrometheusMeterRegistry registry = new PrometheusMeterRegistry(PrometheusConfig.DEFAULT);
    new ErpCallMetrics(registry);                  // 建好 metrics 物件,但還沒 record

    assertThat(registry.scrape()).doesNotContain("erp_adapter_call_duration_seconds");
}

@Test
void timerAppearsAfterFirstRecord() {
    PrometheusMeterRegistry registry = new PrometheusMeterRegistry(PrometheusConfig.DEFAULT);
    ErpCallMetrics metrics = new ErpCallMetrics(registry);

    metrics.recordSuccess("GetItemData", Duration.ofMillis(120));

    assertThat(registry.scrape())
        .contains("erp_adapter_call_duration_seconds_count")
        .contains("operation=\"GetItemData\"");
}
兩個測試合起來看:沒有 record,指標就不存在;有人呼叫 record,指標才會出現。所以要確認指標有沒有真的接上,與其讀程式碼,不如呼叫一次 API,再看 /actuator/prometheus 有沒有多出那幾行。Adapter 的呼叫路徑上少了那一行呼叫 record 的程式碼,就沒有 ERP 等待時間的資料,後面指標表的「Adapter P95 延遲」也就算不出來。
既然 Micrometer 要等第一次 record 才註冊,就在服務啟動時把已知 operation 的指標先建好,值為 0。這樣一上線,Prometheus 就會看到每個 operation 的計數線(成功、業務錯誤、連線失敗各一條)都是 0;看到 0 是正常,看不到那條線就代表指標沒接上。
驗證方式也跟著變:不是看有沒有多出那幾行,而是呼叫一次 API 後,看數字有沒有從 0 變 1。
已知的清單分兩部分:查詢類固定幾支寫在指標的設定類別裡,relay 類則直接從服務原本就有的 operation 允許清單讀,兩者取聯集,避免 relay 白名單改了而指標這邊沒跟上;不在清單裡的 operation,仍然在第一次呼叫時才出現。上面第一個測試建 metrics 時沒有帶清單,所以結論不受影響。
順帶一提,這個雷是真的踩過。寫這篇時回頭查自己的 Adapter,指標類別存在、命名也對,卻沒有任何地方呼叫 record,指標端點上從服務上線起就沒出現過這幾行。是靠上面兩個測試才抓出來的。
| 取捨 | 這樣選的理由 | 何時要重新評估 |
|---|---|---|
| ERP 存取一律經 Adapter | 轉換規則與操作限制只需維護一份 | Adapter 成為效能瓶頸時,先量測再考慮分流 |
| 接受多一層網路呼叫的延遲 | 換取呼叫端不需理解 ERP 細節 | 延遲已超出業務可接受範圍時 |
| 稽核只記 metadata 不記完整 payload | 降低個資與敏感資料風險 | 稽核需求要求更完整內容時,需另訂保護措施 |
| retryable 資訊由 Adapter 提供、呼叫端判斷 | Adapter 不知道呼叫端的交易狀態 | 有明確可安全重試的操作可集中處理時 |
多了 Adapter,也就多了一層需要維護的服務。因為 ERP 相關功能會共同依賴它,多個 instance、健康檢查、容量與依賴監控,都要一起安排。
| 指標 | 計算方式 | 想回答的問題 |
|---|---|---|
| 繞過 Adapter 的 ERP 呼叫數 | 未經 Adapter 直連 ERP 的呼叫數 | 隔離是否真的無法被繞過? |
| SOAP fault 對應覆蓋率 | 已對照的 fault 種類/實際出現的種類 | 是否有未處理的錯誤直接透出? |
| Adapter P95 延遲 | 每筆請求分別記錄總耗時與 ERP 等待,相減得到自身耗時,再各自算 P95 | 慢的是轉換還是 ERP? |
| 契約測試結果 | 通過的契約測試數/全部 | 介面變更是否破壞呼叫端? |
最後也要確認還有沒有呼叫繞過 Adapter。若有,就列出尚未納入的路徑;SOAP fault 則定期和實際紀錄比較,看看有沒有新出現、卻還沒建立對照的錯誤。
我希望 Adapter 能讓 ERP 介接變得比較好理解,也有人能持續維護。不過,接得到 ERP 之後,新的需求要放哪裡?下一篇,就來把 Adapter 的責任再劃清楚一點。


 iThome鐵人賽
 看影片追技術