
Day 2 會帶大家快速走過這個專案的基本架構,並透過一張草圖說明前端、後端與其他支援元件之間如何互動。
這一篇的目標,是先建立對主要元件、各自職責,以及彼此之間交換的訊息與資料流有一個清楚的整體認識。
以下是目前的架構圖:
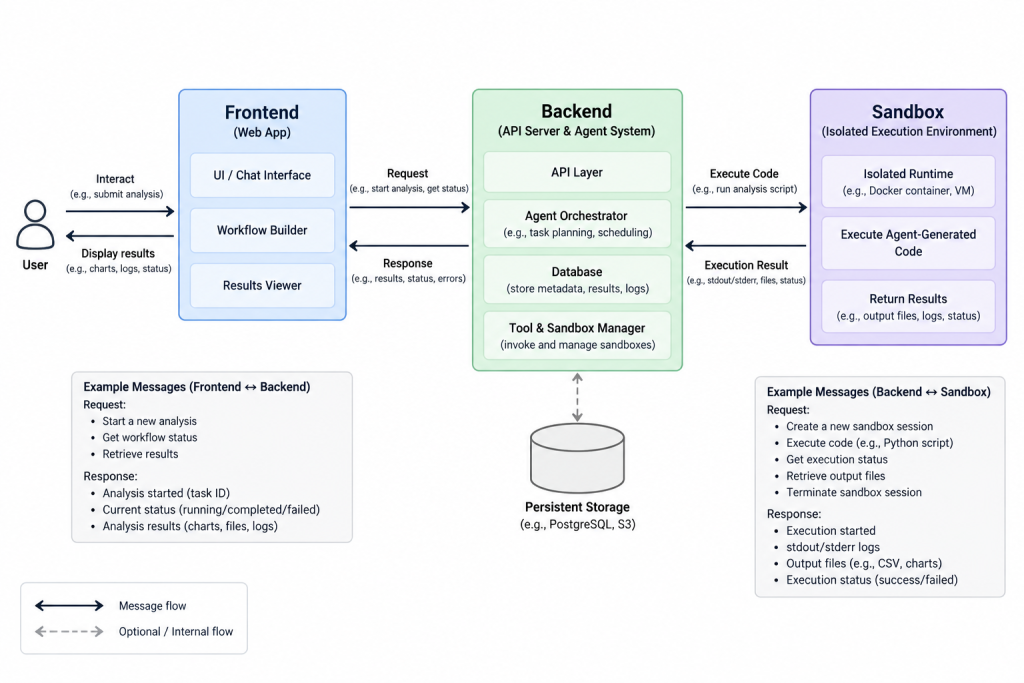
Frontend 是使用者與 Agent以及整個系統互動的主要介面。它負責處理各種面向使用者的流程,例如與 Agent 互動、上傳與預覽檔案,以及管理已上傳的資料。
Backend 是整個系統的協調層,負責管理 Agent、datasource 存取、workflow 執行,以及與 sandbox 這類外部執行環境之間的溝通。
平台主要支援兩大類 datasource:
File-based sources
Relational databases
從 system design 的角度來看,關鍵不在於支援多少種 datasource,而是要避免讓 datasource-specific logic 滲透進 Agent / Analysis Layer,意思是說如何讀取跟處理資料的邏輯不需要讓 Agent 知道。
簡化後的 dependency model 可以表示為:
Agent / Analysis Layer → Datasource Abstraction → Concrete Implementation
以 file-based source 為例,可以透過單一入口,根據檔案類型將工作交給對應的 implementation:
Agent / Analysis Layer → AsyncFileSource → CsvFileSource / XlsxFileSource / ...
Database source 也可以採用類似的設計。
這樣可以讓 Agent 專注在資料分析本身,而不需要處理檔案解析、database driver 或 connection details。Datasource abstraction 的設計會在之後更進一步展開。
Sandbox 提供一個隔離的執行環境,用來執行 Agent 產生的分析程式碼。Backend 會將 execution request 傳送到 sandbox,並接收執行結果或產生的 artifacts。
引入 sandbox 最主要的原因是 isolation。由 AI Agent 執行的程式碼應該被限制在一個受控環境中,避免非預期行為直接影響使用者的本機系統,例如刪除檔案、修改環境,或存取原本不應該接觸的資源。
這在企業環境中尤其重要。Sandbox 也能協助建立更清楚的存取邊界,降低敏感資料被沒有適當權限的使用者、process 或 tool 取得的風險。


 iThome鐵人賽
 看影片追技術