
昨天列出了一百個花樣百出的工程難題,今天談談解決問題的系統與團隊。
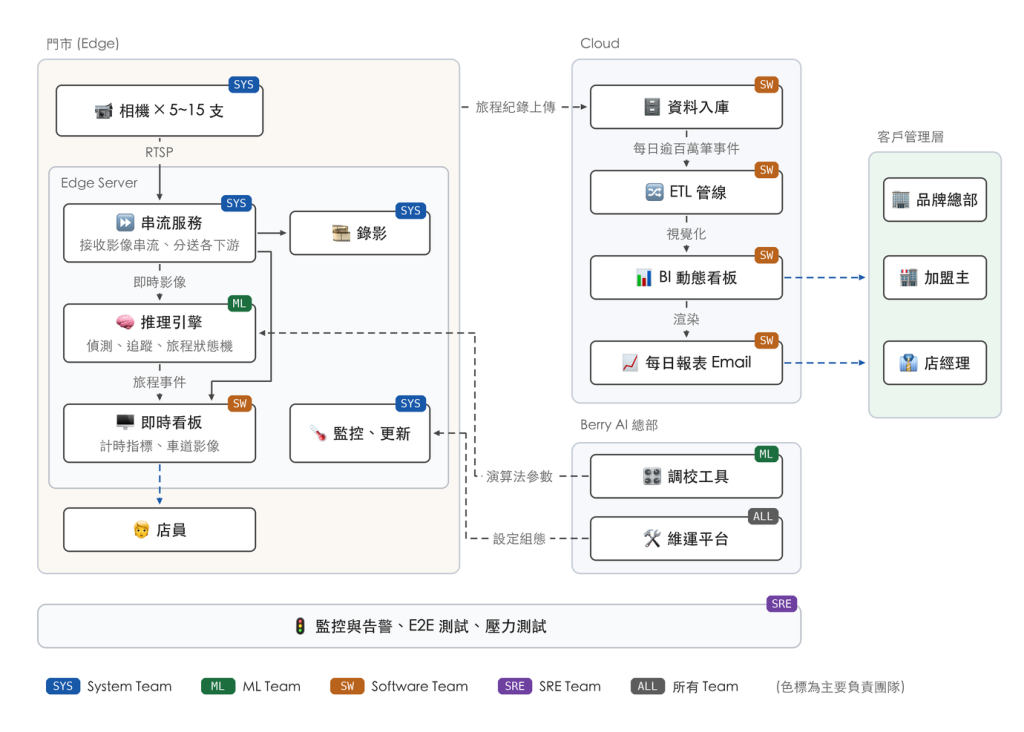
一台車駛入得來速車道,車道各處的相機會記錄它的移動過程。一間店有 5 到 15 支相機,以 RTSP 串流將影像統一送進店內的 edge server,串流服務處理協定轉換,再分送給推理引擎、即時看板並保存錄影。
推理引擎在店內完成三件事:物件偵測模型 (object detection model) 找出車道上的車輛與店員 (有些品牌有人工平板點餐),跨相機追蹤 (cross-camera tracking) 演算法為每台車維持一致的 Track ID,旅程狀態機 (journey state machine) 再依照規則將行車軌跡轉換成排隊 (queue)、點餐 (ordering)、取餐 (pick-up) 等事件 (event)。至此,影像已經轉換成結構化的顧客旅程。
旅程事件同時送往兩處。一是店內的即時看板 (第 1 天提到的 Drive-thru Real-Time Dashboard),把旅程事件換算成各項計時指標,連同車道的即時影像一併顯示,廚房裡的店員靠它掌握現場狀況,是這套系統的第一線使用者;二是彙整成旅程紀錄上傳雲端入庫,由 ETL 管線彙總,視覺化成 BI 動態看板 (第 1 天提到的 Berry Board),再渲染成每日清晨寄出的 Email 報表,分別提供給品牌總部、加盟主與店經理,資料的可見範圍依角色劃分。以約一千間門市、每間店每天約三百台車計算,Berry AI 每天要處理約三十萬台車的旅程、超過一百萬筆事件。
Vision AI 推理放在 edge 執行,主要有三個原因。第一是延遲考量:廚房看板要求秒級更新,資料往返雲端無法穩定達成。第二是頻寬限制:多路影像的上行流量會佔據大量門市的網路頻寬,客戶無法接受,而上傳結構化旅程資料則小了數個數量級的流量。第三是意外的斷網:門市斷網並不罕見,且不在我們的控制範圍之內,即時看板的絕大部分功能要能在斷網期間照常運作,而每日報表所需的資料待網路恢復後再補傳即可。
這個設計的代價在維運端。上千台 edge server 散落在客戶的內網裡,要維運它們得先建置穩定的 VPN 或穿牆機制。這些基礎設施由 System Team 建置,各團隊會再以其為基礎打造維運平台,管理散布在上千間門市的軟體與設定。
架構圖上的色標即為分工:前三個 team 沿著資料流接力,SRE 負責橫跨 Edge 與 Cloud 的系統穩定性。
負責維護橫跨軟硬體的基礎建設。範圍從硬體選型、代工廠產線上的 OS 預裝、門市網路整合,到相機參數與韌體管理、串流與錄影、遠端連線,以及上千台機器的組態與批次部署。System Team 的職責一半在軟體世界、一半在物理世界:意外斷電、大雨防水、雷擊突波、龜速網路、動態防火牆,在各種不可抗力與未知之中,維持底層系統的穩定是他們的專業。第 4 天到第 10 天由他們主筆,從硬體選型、免人工的 OS 安裝、遠端連線的通道,一路談到影像串流、機隊管理與規模化。
負責把影像轉換成各式各樣的數據。跨相機追蹤的前提,是把每支相機校正到同一套世界座標;偵測與追蹤產生軌跡後,狀態機把軌跡轉換成事件流,不同品牌的車道配置與關心的數據都不同,設計通用的核心演算法是 ML Team 的主要任務。除了核心演算法之外,還有一整套調參流程與工具也是由 ML Team 開發,每間店上線前都要逐店調校,會另外交由專責的 support team 執行。這個領域最大的難點,是時常沒有標準答案可以比對,準確度必須依賴統計與抽驗把關。第 11 天到第 17 天由他們主筆,從相機校正、跨相機追蹤、旅程狀態機,一路談到調校工作流、回測工具與異常偵測。
負責數據的最後一哩路,讓每個使用者在對的地方看到對的數字。店內的即時看板必須準確且即時,車道畫面要流暢無延遲的播放,店員們才能做出最佳決策。Edge 與 Cloud 之間的資料同步、ETL 管線、BI 動態看板,以及每日準時送達的報表 Email,這整串資料流有著非常複雜的商業邏輯,要維持資料的一致性與程式碼的可維護性非常不容易。第 18 天到第 24 天由他們主筆,從內部工具、BI 看板與權限控制、資料管線、報表的大規模渲染與寄送,一路談到即時看板的串流方案。
前三個 team 各自負責資料流的一段,SRE 負責系統整體的可靠性。監控由各 team 分頭建置,SRE 統合整體的監控計畫,確保硬體可用性、軟體可用性、數據準確性三個層次都有人看守;測試面有橫跨 Edge 與 Cloud 的 E2E 測試、壓力測試與容量規劃,以及新硬體上線前的評估驗證;上線規範由他們制定,事故後的 post-mortem 也由他們主導。其他 team 對個別元件負責,SRE 對整個系統在真實環境中的行為負責。第 25 天到第 27 天由他們主筆,談系統守門人的工作:上線前怎麼把關,上線後怎麼看守。
回頭看這張架構圖,裡面沒有什麼神祕的元件:相機、串流、推理、管線、看板,每一塊在業界都有成熟做法。難的是橫跨上千間環境迥異的門市,建置一條每天消化三十萬台車的數據產線,昨天那一百條難題就是這樣長出來的。如今的四個團隊也是 Berry AI 在面對這些挑戰時逐漸摸索出來的分工 — System Team 維護基礎建設,ML Team 產出計時數據,Software Team 將數據呈現給使用者,SRE 則看守整體的可靠性。接下來,會由各個團隊輪流主筆,讓我們一窺 Berry AI 的工程秘辛吧!
本系列由 Berry AI 工程團隊出品。更多工程實戰紀錄都在 Berry AI 技術部落格。


 iThome鐵人賽
 看影片追技術