

昨天聊了為什麼想用 30 天做這個 side project,也大致介紹了想做一個讓台灣小品牌更容易被找到的探索平台。但在開始討論模型、AI Agent、Embedding 或其他技術以前,我想先回答一個更基本的問題:這個產品真正需要解決的問題是什麼?
我很相信 Occam's Razor:如果一個問題能用簡單的方法解決,就沒有理由因為 AI 很熱門,而硬把它變成一個 AI 問題。所以今天想先把整個商業問題拆成三塊:
只有先把這三個問題定義清楚,才知道 AI 到底該出現在哪裡,又有哪些地方其實不需要 AI。
高品質的資料是一個平台最根本的基礎,但這一步往往也是最困難的一步。如果只是收集品牌官網,專案最後的成品只會是一份網站目錄,像是一本現在很少人會主動翻閱的黃頁;只有把不同來源整理成一致、可查詢、可比較的結構化資料,它才真正成為一個可以被利用的產品資料庫。
在實作上,大致可以分成幾種方法:
最簡單的方法,就是維護一份店家清單,再人工把需要的欄位補齊。這不需要任何程式,也非常適合專案早期快速驗證;但隨著想呈現的欄位越來越多,人工整理會迅速變得繁瑣,也很難確保不同品牌之間的資料品質一致。
再進一步,可以針對常見的開店平台各寫一支 Adapter。例如看到 Shopify,就走 Shopify 的抓取邏輯;看到另一個電商平台,就使用另一組 parser,再透過固定的 function 把名稱、價格、圖片、商品連結等欄位抽取出來。
如果大多數網站都來自少數幾個固定平台,這種方法其實非常可靠:結構清楚、可以重複執行、相同輸入通常會得到相同結果,也方便測試與 debug。問題出現在來源開始變得分散之後,不同平台、不同模板、不同網址結構,再加上 crawler blocking、JavaScript rendering、失效連結等 edge cases,都會讓需要維護的邏輯持續增加。
這裡並不代表用 AI 取代程式,而是將決策權交給 AI Agent 讓他去決定該怎麼從工具箱(程式)中選擇出對的工具解決對的問題。
例如 Agent 可以根據目前看到的網站決定:
為什麼不乾脆全部交給 AI?原因很簡單:如果一件事本來就可以用 deterministic code 穩定完成,換成模型反而會增加成本、延遲與不確定性,所以 extraction、schema validation、去重與資料寫入這些規則明確、可以穩定執行的流程,我會盡量留在程式裡;只有那些真的需要理解上下文或做語意判斷的 enrichment,才交給模型。
Agent 負責 decision-making,code 負責 reliable execution。
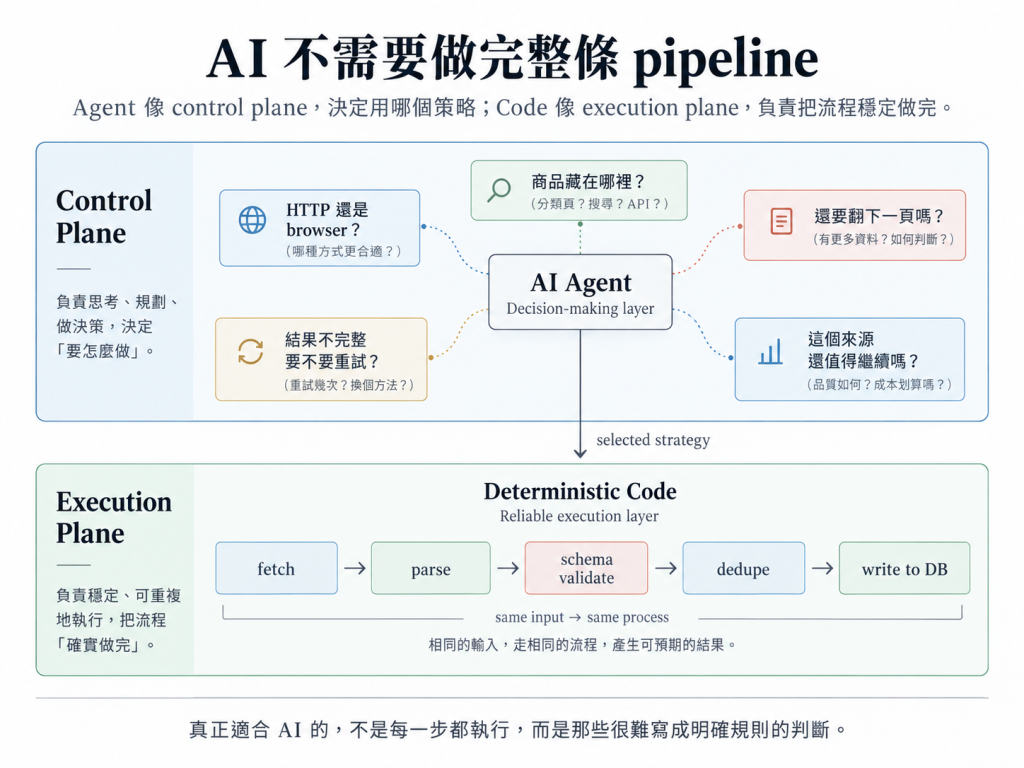
至於 Agent 到底應該負責哪些決策、要做成一顆 Agent 還是拆成多個 Agent,以及這樣的迭代流程怎麼設計,就是後面幾天會繼續討論的內容。
除此之外,LLM 還有一項傳統 rule-based system 比較難做到的能力:需要上下文的語意判斷。 例如 S'MORE 既可以指美國常見的點心,也是一個日本戶外用品品牌。如果只做 exact string matching,兩個相同字串很容易被當成同一個 entity;但如果同時考慮網站內容、商品類別、品牌描述等上下文,模型就有機會判斷它們其實代表完全不同的東西。
這其實是一個典型的 entity disambiguation 問題,也是我認為 AI 在資料 pipeline 裡真正有價值的地方:不是把原本 deterministic 的程式全部換成 AI,而是把那些過去很難寫成明確規則的判斷交給它。
大家在使用搜尋引擎或各種搜尋系統時,應該都遇過幾種情境:
這背後不只是搜尋技術的問題,也和搜尋系統究竟在最佳化什麼有關。對使用者來說,搜尋最重要的目標通常很單純:用最少的時間,找到最符合當下需求的東西。
但對商業平台來說,搜尋系統通常不只需要最佳化 relevance。搜尋結果可能還同時受到點閱率、轉換率、商品熱度、賣家品質、廣告收益、庫存與平台本身商業策略等因素影響,而這些商業目標往往和 relevant 不完全一致。
另一方面,許多搜尋體驗仍高度依賴關鍵字、產品分類以及篩選條件,但人真正產生需求時,腦中的想法通常不是一組乾淨的商品欄位。例如:
我想找一個禮物,送給剛滿三十歲、喜歡露營、偏好低彩度風格的朋友,預算大概 NT$2,000。
這句話裡同時包含了送禮情境、對象、興趣、風格偏好以及價格限制。我們當然可以一直增加資料庫分類,例如「露營用品」、「送禮推薦」、「30 歲族群」、「低彩度」,但使用者可能提出的需求組合幾乎沒有上限。問題並不是資料庫不能增加更多欄位,而是我們不可能事先替所有可能的搜尋情境建立一套 taxonomy。
因此另一種思考方式,是不要要求使用者先學會「這個系統到底接受什麼關鍵字」,而是讓系統試著理解使用者真正表達的搜尋意圖(intent)。
今天的搜尋還有另一層問題:曝光本身並不是完全中立的。 有大量既有流量、有成熟行銷團隊、累積大量交易紀錄,或有更多資源投放廣告的品牌,通常更容易取得曝光。對新品牌來說,這其中也包含典型的 cold-start problem:沒有歷史互動資料,ranking system 就更難評估它;而當曝光本身又會進一步產生點閱、收藏、購買等 ranking signals 時,就容易形成「越被看見 → 越多互動 → 越容易繼續被看見」的回饋循環(feedback loop)。
這並不代表排名前面的產品不好,但反過來說,一個沒有行銷預算、沒有歷史流量的小品牌,也不代表它和這次搜尋沒有關係。
因此在這個 side project 中,我想做一個有點刻意的實驗:
如果我們先不把 conversion 或 revenue 放進 ranking objective,而是把 relevance 放在第一順位,搜尋系統會長什麼樣?
要做到這件事,至少需要處理兩個問題。
系統要理解使用者說的到底是什麼:使用情境是什麼、送給誰、有哪些偏好,又有哪些不能違反的限制。例如「NT$2,000 以下」可能是一個 hard constraint;「低彩度」比較像一個 soft preference;「適合喜歡露營的朋友」則可能需要結合更多上下文才能判斷。
產品不能只有名稱、品牌和 category。系統還需要理解它的材質、用途、風格、價格帶、製造方式、適合的使用情境,以及其他可能影響 relevance 的特徵,再把它們轉換成可以被比較的 representation。
一邊描述「人在找什麼」,另一邊描述「產品是什麼」,兩邊必須轉化成同一套語言才有辦法溝通。
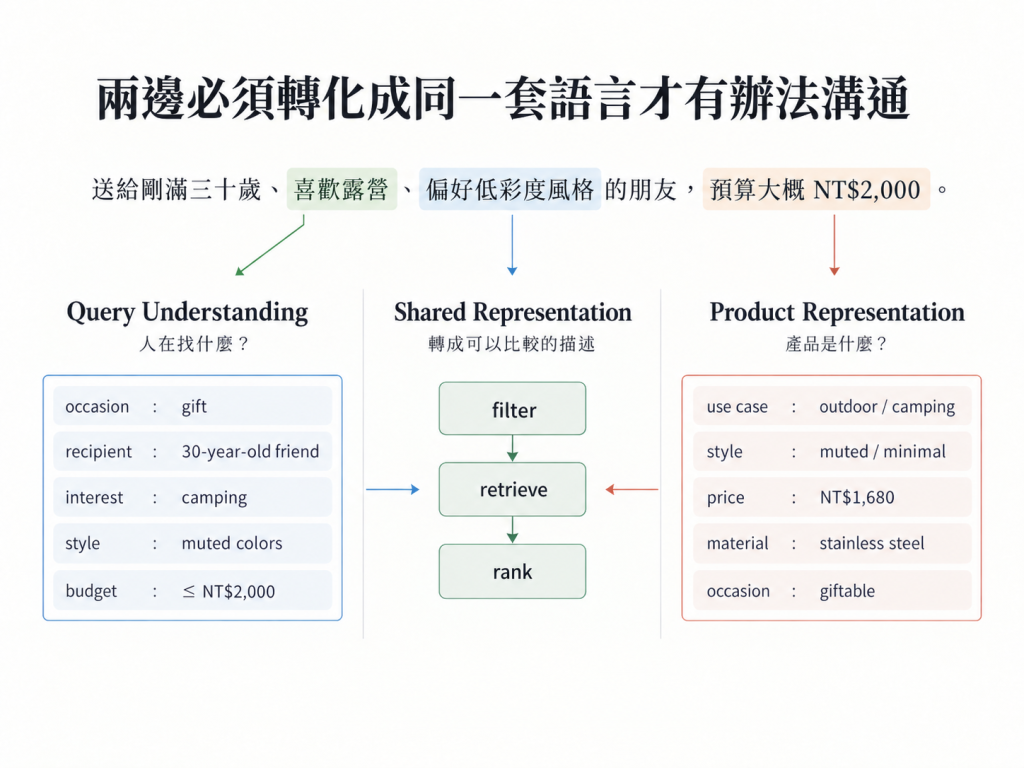
接下來的三十天內我們會深入討論以下的話題:這些產品特徵應該怎麼定義?哪些可以從結構化資料取得,哪些需要 AI 推論?Query 又應該如何拆解?最後要使用 filtering、semantic retrieval、ranking,還是幾種方法一起搭配?
搜尋功能其實有一個常被跳過的前提:你得先知道自己要打什麼。 搜尋「杯子」和搜尋「露營時方便帶出門的保溫杯」,兩者的需求與限制條件差很多,搜尋結果自然也會不同。
但很多時候,使用者並不知道該怎麼精準描述自己需要的東西。甚至有些時候,他根本沒有一個明確 query,只是想像逛選物店一樣看看有什麼,直到看到某個東西,才突然反應過來:「原來有這種東西,這剛好是我要的。」
這就是 Discovery Layer 想處理的問題。
很多電商或選物平台,例如 Pinkoi、Amazon、蝦皮等,都有自己的探索介面:首頁推薦、主題頁、精選清單或商品 feed。Pinterest 也會主動推薦不同內容讓使用者取得靈感;Instagram 則有 Explore 功能,讓使用者在沒有明確 query 的情況下繼續探索。
這些 Discovery Layer 的共同點是,不用先輸入任何文字,系統就先把一些可能感興趣的東西放到你面前。所以真正值得討論的問題不是「要不要做 Discovery」,而是:到底用什麼邏輯決定哪些東西應該先被看見?
在商業平台裡,discovery ranking 通常不只考慮 relevance,也可能同時受到銷量、CTR、促銷、庫存、廣告與商業策略等因素影響。而在這個 side project 裡,我想嘗試的是另外一種方向:用「情境」作為探索的起點。
例如:
每一個情境底下,我們不是單純放銷量最高的產品,因為這個平台並不是電商。我們更想找的是一組真的和這個情境有關,而且彼此放在一起也合理的選品組合,比較接近「線上選物店」的概念。
但這又帶出下一個問題:假設「開始自己煮咖啡」底下有三百個相關產品,到底哪二十個應該先出現?這時候搜尋和探索的 ranking objective 就開始出現差異。
搜尋通常希望盡可能精準地回答一個已經存在的 query;探索除了 relevance 以外,可能還要同時考慮 diversity(不要全部都是差不多的東西)、novelty(讓使用者看到沒看過的內容)、serendipity(讓人遇到原本不知道自己會喜歡的東西),以及 coherence(整組選品放在一起是否合理)。
搜尋比較像是在回答需求,探索則還要幫忙形成需求。
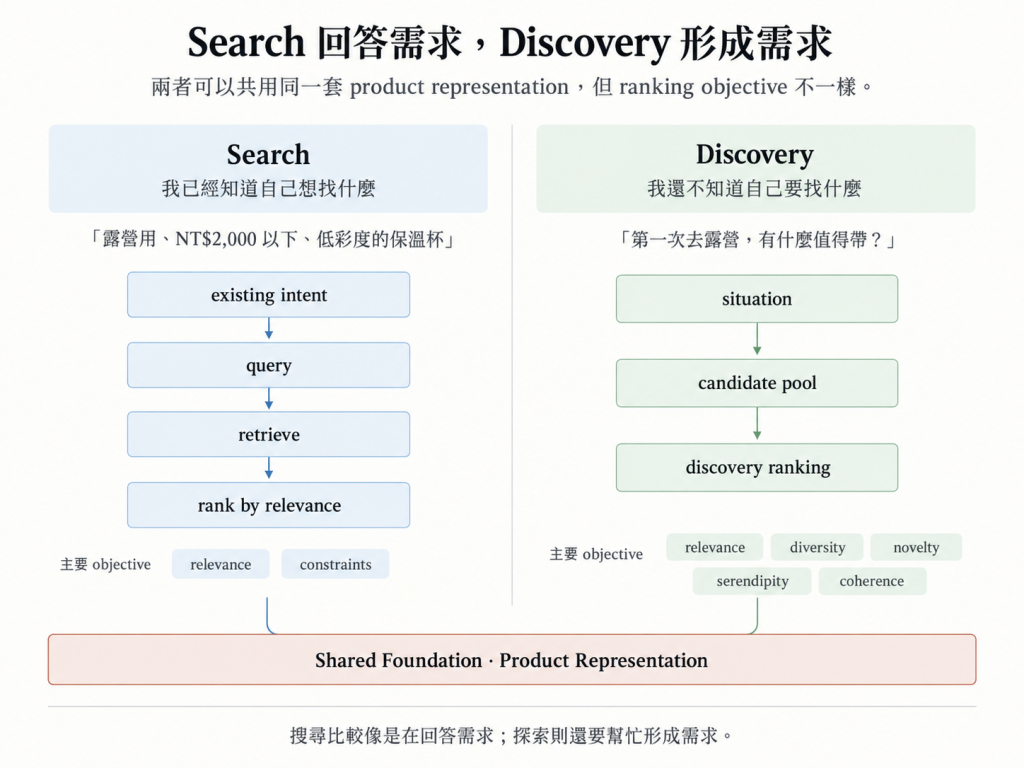
而且「情境」本身只回答了第一個問題:哪些產品應該進入這個 candidate pool?真正進入這個 pool 之後,還是要有另一套 discovery ranking logic 來決定誰先出現。
要做到這件事,需要的底層資料其實和搜尋高度重疊。產品本身必須有夠細的 representation:它是做什麼的、適合什麼場合、什麼材質、什麼風格、什麼價位,以及它和哪些產品相似或互補。搜尋和探索因此可以建立在同一套 product representation 上,只是最後的 ranking objective 不一樣。
如果把前面的 Search 與 Discovery 落到產品介面,目前我想像中的主要產品介面大概有四個:
今天我們把產品問題拆成三塊:資料要先進得來、搜尋要能對上情境,以及使用者還不知道自己要什麼時,系統該怎麼幫他探索。
明天開始會先從資料層往下拆:該怎麼把「送給剛滿三十歲、喜歡露營、偏好低彩度風格的朋友,預算大概 NT$2,000」這種描述,變成機器抽得出來、也存得進資料庫的特徵。
我們明天見!


 iThome鐵人賽
 看影片追技術