
昨天把 K8s 存在的理由說清楚了,今天來把架構拆開來看,並說說當中元件的功能!
在看架構圖之前,需要先知道兩個基礎概念:
一個 Node 上可以跑很多個 Pod,就像一台電腦上可以同時開很多個程式。

圖片來源:[Kubernetes 官方文件]
這張圖包含了一個 K8s Cluster 的所有核心元件,分成兩個區塊:
負責「決策」,不直接跑任何應用程式。
kubectl、CI/CD、內部元件溝通,全部都要先過它。負責驗證請求、把狀態存進 etcd、通知其他元件。minikube 本地環境沒有這個元件。
每個 Worker Node 都跑著三個元件:
containerd)。
當使用者打開瀏覽器請求 Todo App,流量路徑長這樣:
使用者的瀏覽器
      │
      ▼
   Ingress          ← 統一對外入口,根據規則決定送去哪個 Service
      │               (就像 nginx 反向代理,/api 送後端、/ 送前端)
      ▼
   Service          ← 穩定的內部入口,用 Label 找到對應的 Pod
      │               (Pod IP 一直在變,Service 提供固定的虛擬 IP)
      ▼
     Pod            ← 實際跑著 Container 的地方
      │               (FastAPI 後端、React 前端、MySQL 資料庫各是一組 Pod)
      ▼
   回應使用者
這條路徑上完全沒有 Control Plane 的元件。
今天目標:親眼看到架構圖裡的元件實際存在。
K8s 的系統元件本身也是 Pod,跑在 kube-system namespace:
kubectl get pods -n kube-system
你會看到類似這樣的輸出: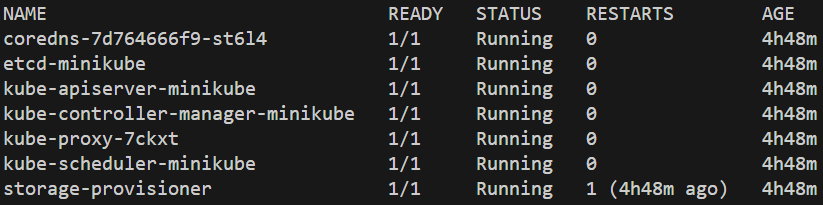
注意這裡沒有 cloud-controller-manager,因為 minikube 是本地環境。
K8s 用自己的機制管理自己,整個系統非常一致。
kubectl get nodes -o wide
CONTAINER-RUNTIME 欄位會看到 containerd,這就是 CRI。
kubectl describe pod kube-apiserver-minikube -n kube-system
看 Containers 裡的 --etcd-servers 參數,會指向 etcd 的位置——印證了「API Server 是唯一跟 etcd 溝通的元件」這件事。
minikube dashboard
打開之後:
kube-system 裡的系統 Podminikube 節點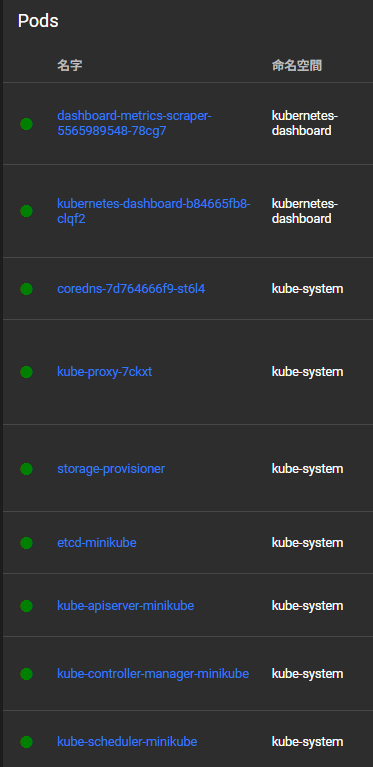
這段補充架構背後的設計思路,有興趣再看。
etcd 是整個 Cluster 的唯一事實來源。所有狀態都在這裡,其他元件依據它去執行對應的動作。
etcd 掛了之後:現有 Pod 繼續跑、流量不受影響,但無法下新指令、自癒機制停止。所以生產環境的 etcd 通常會定期備份,並跑成 3 或 5 個節點的叢集(Raft 共識演算法確保高可用)。
這是 K8s 刻意的設計——管理面(Control Plane)和資料面(Data Plane)分離。
Control Plane(大腦) 負責決策,不服務流量:
| 元件 | 一句話 |
|---|---|
| kube-api-server | 所有指令的唯一入口 |
| etcd | Cluster 的唯一事實來源,只有 API Server 能讀寫 |
| kube-scheduler | 決定 Pod 跑在哪個 Node |
| kube-controller-manager | 持續確保現狀符合期望狀態 |
| cloud-controller-manager | 跟雲端平台溝通,本地環境沒有 |
Worker Node(手腳) 負責實際執行:
| 元件 | 一句話 |
|---|---|
| kubelet | Node 上的代理人,接指令、回報狀態 |
| kube-proxy | 處理流量路由規則 |
| Container Runtime | 真正把 Container 跑起來 |
最重要的一條線:使用者 → Ingress → Service → Pod,Control Plane 不在這條路徑上。
明天開始實作,寫第一個 Pod YAML,把 Todo App 的後端跑在 K8s 上,同時說清楚什麼是「宣告式思維」!


 iThome鐵人賽
 看影片追技術