
一、圖表之上,還缺一層文字
Day 20 練習二那個 30 秒的挫折,你應該還記得:report.html 打開了,曲線漂亮、數字齊全,假裝成主管的你卻答不出「這次測試是好是壞」。圖表呈現事實,但不會自己下結論——結論、原因、建議這三件事,要有人用文字寫出來,這份文件才叫報告。
過去這一層文字是效能測試最耗時的部分:對著幾十個指標一項項描述,再想辦法翻成主管聽得懂的話,一份報告寫掉半天是常態。今天這件事的分工要改變。Claude Code 讀得懂 raw.json 裡每一個數據點、算得出任意分桶的百分位數、也寫得出通順的中文——但它不知道你的老闆為什麼在意結帳而不是首頁、不知道測試環境只有正式環境一半、更不知道「請 RD 加索引」在你們團隊排不排得進下個 sprint。這些它不知道的事,恰好就是報告有沒有說服力的關鍵。所以今天的主題不是「讓 AI 寫報告」,而是「讓 AI 當分析師,你當簽名的人」——先把分工線畫清楚:
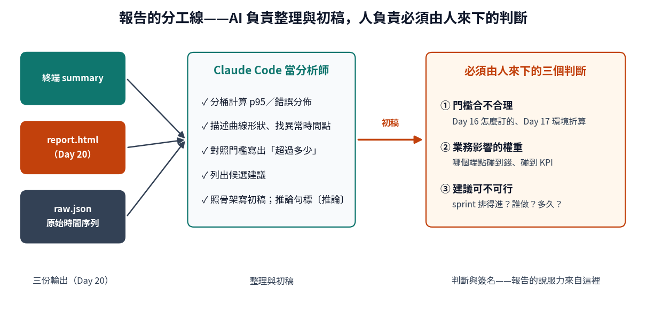
圖 1:報告的分工線——AI 負責整理與初稿,人負責三個必須由人來下的判斷
二、三個判斷,AI 代替不了你
圖 1 右側那三個判斷,值得逐一說清楚為什麼非人不可。
判斷一:門檻合不合理。Claude Code 會忠實地寫「p95 為 920ms,超過門檻 800ms,未通過」。但那條 800ms 是 Day 16 你從客服訪談、訂單量反推、同業經驗湊出來的「可以被挑戰但有依據」的數字——它本來就允許被挑戰。測試環境規格只有一半(Day 17)、施壓機當天有沒有到極限(Day 19)、門檻當初是照正式環境訂的還是照測試環境折算的,這些脈絡決定了 920ms 是「真的不合格」還是「在半規格環境算合理」。AI 只看得到數字,看不到訂門檻的那場會議。
判斷二:業務影響的權重。同樣是慢 40%,發生在「查詢歷史訂單」和發生在「送出結帳」是兩個等級的問題;前者使用者多等一下,後者直接掉單。哪個端點碰到錢、哪個流程碰到 KPI,這是你對業務的理解,不在任何一個 JSON 檔裡。AI 生成的初稿會把每個發現排成一樣高,把它們排出高低順序的是你。
判斷三:建議可不可行。AI 很會給建議:加快取、補索引、擴機器、拆服務——每一條都對,也每一條都可能沒用,因為它不知道下個 sprint 已經塞滿、DBA 只有一位、擴機器要走三週採購。一條做不到的建議寫進報告,只會讓整份報告的可信度跟著打折。可行性要問人,而且通常要在寄出前先問過 RD(Day 22 要談的協作,從這裡開始)。
把分工整理成一張表,之後每寫一份報告都對照一次: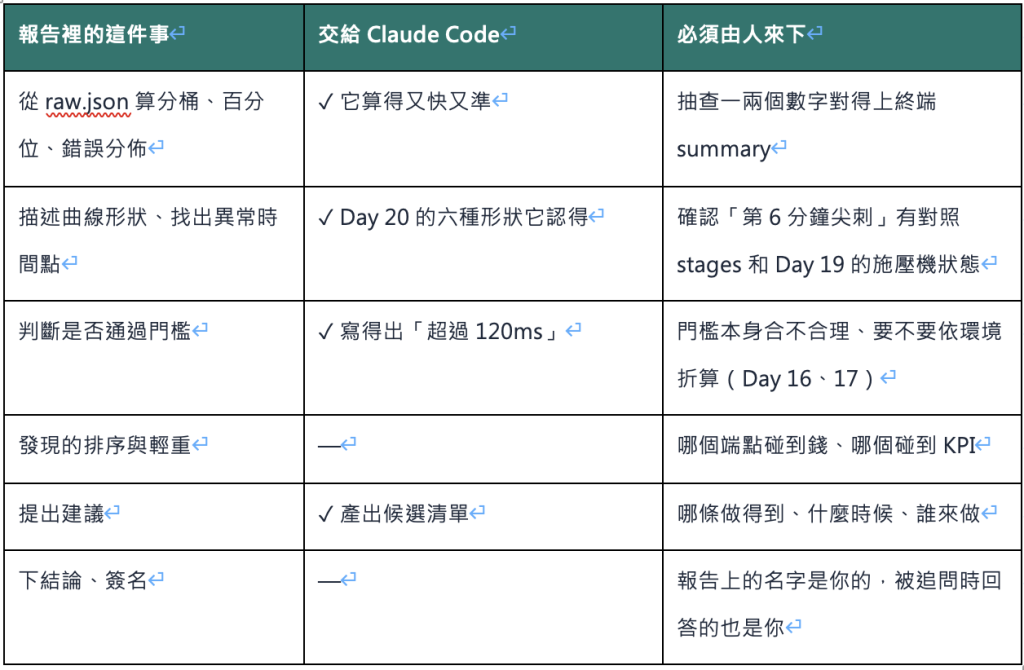
表裡最後一列是整天的重點:Claude Code 寫得出流暢的文筆,但簽名欄填的是你的名字。主管追問「所以要不要延後上線」時,回答的人是你,而你答得出來的前提,是初稿裡每一個結論你都真的理解、也真的同意。
三、報告的骨架:三種讀者、一份文件
一份效能測試報告會落在三種人手上:主管只想知道好壞與該不該上線,給他 30 秒;RD 想知道慢在哪、證據是什麼,給他 3 分鐘;三個月後想重現這次測試的人(很可能是你自己),需要腳本、環境、負載條件,全放附錄。把三種讀者疊起來,就是這個骨架:
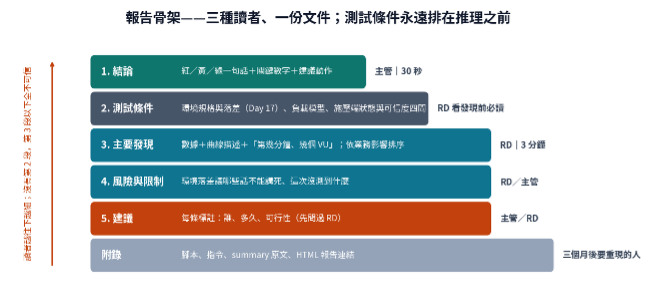
圖 2:報告骨架——上層給主管 30 秒、中層給 RD 3 分鐘、附錄給要重現的人
骨架裡每一段對應前幾天的一項基本功:結論那顆紅綠燈來自 Day 7 的 thresholds 和 Day 16 的 SLO;發現的證據來自 Day 18 的三條線索與 Day 20 的曲線;風險就是 Day 17「環境有落差時哪些話不能講死」;測試條件則是 Day 19 可信度四問的答案加上環境註記。這也解釋了為什麼報告要留到 Day 21 才寫——它不是新技能,是前二十天所有判讀能力的排版。
把骨架寫成範本,之後餵給 Claude Code 時一併附上,它就會照這個結構產出初稿(完整版在文末附錄):
# perf-report-template.md(給 Claude Code 的骨架)
## 1. 結論(給主管,30 秒)
- 紅/黃/綠一句話:通過 / 有條件通過 / 未通過
- 最重要的一個數字,和它對應的門檻
- 建議:可上線 / 修完 X 再上線 / 需要決策
## 2. 測試條件(沒有這段,下面全部不可信)
- 目標系統與環境(規格、與正式環境的差距,Day 17)
- 負載模型與 stages、腳本版本(Day 12、14)
- 施壓端狀態、可信度四問結果(Day 19)
## 3. 主要發現(給 RD,3 分鐘)
- 每條發現 = 數據 + 曲線描述 + 對照 stages 的時間點
- 依業務影響排序,不是依指標順序
## 4. 風險與限制
- 環境落差讓哪些結論不能講死
- 這次沒測到什麼(沒跑 soak、沒含瀏覽器端)
## 5. 建議(每條標註:誰、多久、做不做得到)
## 附錄:腳本、指令、summary 原文、HTML 報告連結
注意第二段的位置:測試條件排在結論之後、發現之前。主管可以跳過它,但 RD 看發現之前一定會先看它——這是 Day 19 教的順序「先審證據,再開推理」搬進了報告的版面。
四、動手做:把三份輸出餵給分析師
練習一:產出初稿。用 Day 20 留下的三份檔案。把範本、summary、raw.json 一起交給 Claude Code,並且——這是關鍵——把它不可能知道的脈絡先講給它聽:
Prompt 1|報告初稿
請讀取 raw.json、summary.json,並依 perf-report-template.md 的結構寫一份效能測試報告初稿。
脈絡(這些你從檔案裡看不到,請納入判斷):
- 這是 QuickPizza 的 journey 腳本,門檻:p95 < 800ms、錯誤率 < 1%(Day 16 訂的)
- 業務上最重要的端點是送出評分(POST /api/ratings),瀏覽類端點次之
- 測試環境只有正式環境一半規格,數字只做相對比較,不做絕對承諾
- 施壓機 CPU 全程低於 40%,可信度四問全過
要求:
1. 結論段用一句話,加紅/黃/綠標示
2. 每條發現附上分桶後的數據和「第幾分鐘、幾個 VU」的對照
3. 建議先列候選,每條標註你「無法判斷」的部分(例如可行性)
4. 凡是你推論而非數據直接顯示的句子,句尾標註〔推論〕
最後那條「標註〔推論〕」是整段 prompt 最重要的一行。AI 最危險的地方不是算錯數字,而是把推論寫得跟事實一樣篤定——Day 18 提醒過「驗證它的推論而不是照單全收」,現在讓它自己把推論標出來,你審稿時就知道該盯哪幾句。
練習二:讓它反過來挑戰你。初稿到手,先別急著改,做一個反向動作:
Prompt 2|自審與反駁
現在請你換成一位挑剔的資深 RD,讀這份報告初稿,
列出你會質疑的五個點——哪些結論證據不足?哪些數字可能是施壓端、
快取或環境造成的?哪條建議在真實團隊裡大概做不到?
每一點告訴我:要補什麼證據、或要把哪句話改得更保守,才能站得住。
這一步在模擬 Day 22 會真實發生的場面:報告寄出去,RD 回一句「你環境不對」或「這是特例」。與其在會議室被問倒,不如先在自己的終端被問倒。Claude Code 列出的五點裡,通常有兩三點你自己也知道站不住——那幾句在寄出前改掉,或者老實寫進「風險與限制」。
練習三:親手改寫結論段。這是唯一一段不允許直接沿用 AI 文字的地方。關掉終端,用你自己的話把結論段重寫一次,限制三句話:好壞、最關鍵的證據、建議動作。寫完做兩個測試——先請一位不看技術細節的同事讀 30 秒,問他「所以要不要上線」;再回頭對照初稿,看看哪些字是 AI 寫的時候你就已經同意的,哪些是你讀第二遍才發現其實不確定的。後者才是你真正的理解邊界,也是報告該保守下筆的地方。
五、注意事項:報告寄出前的六個習慣
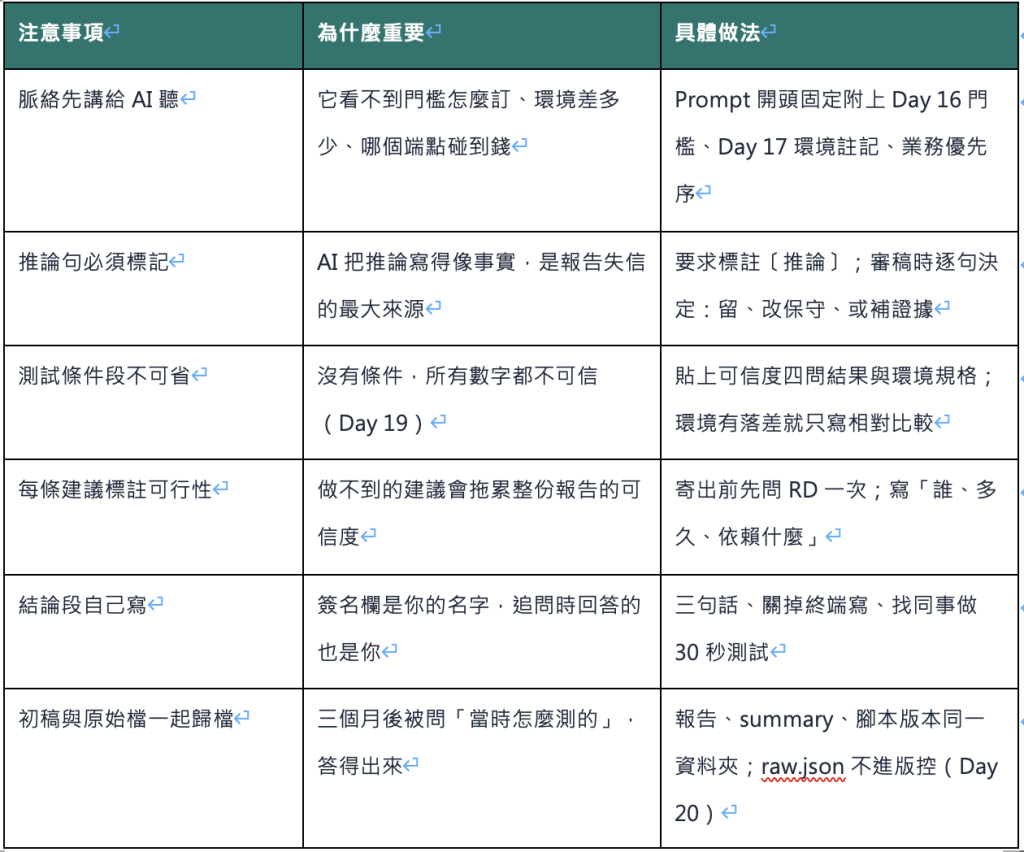
給 RD 的一句話:收到 QA 的效能報告,請直接翻到「測試條件」和句尾帶〔推論〕的地方——前者告訴你這份數據值不值得信,後者是 QA 誠實標出的不確定處,也是你們最該一起討論的地方。一份願意標出自己不確定的報告,比一份句句篤定的報告更值得認真對待。
六、觀念驗證:三個問題確認你有帶走今天的重點
• 「門檻合不合理」為什麼不能交給 Claude Code 判斷?它缺的是哪些只有你知道的脈絡?(第二節)
• 報告骨架裡,測試條件為什麼排在結論之後、發現之前?這對應 Day 19 的哪一句話?(第三節)
• Prompt 1 要求 AI 在推論句尾標註〔推論〕,這解決了 AI 協作裡的哪個風險?練習二的反向挑戰又在預演什麼場面?(第四節)
七、小結
圖表之上的那層文字,今天補齊了。分工線畫得很清楚:分桶計算、趨勢描述、初稿文筆交給 Claude Code;門檻是否合理、業務影響權重、建議可行性,這三個判斷必須由人來下——報告的說服力來自你的理解,不是 AI 的文筆。骨架則是前二十天的排版:結論給主管 30 秒、發現給 RD 3 分鐘、附錄給要重現的人,而測試條件永遠排在推理之前。練習二那五個質疑,其實就是 RD 明天會問你的問題;報告寄出後,效能問題要怎麼開單才會被認真對待、面對「你環境不對」時怎麼回——Day 22 見。
附錄:效能測試報告範本(可直接交給 Claude Code)
# 效能測試報告:{系統/功能}|{日期}|撰寫:{你的名字}
## 1. 結論
- 狀態:🟢 通過 / 🟡 有條件通過 / 🔴 未通過
- 一句話:{例:送出評分 p95 920ms,超過 800ms 門檻 15%,其餘端點通過}
- 建議動作:{可上線 / 修完 X 再上線 / 需要 {誰} 決策}
## 2. 測試條件
- 目標:{環境名稱},規格 {CPU/記憶體},約正式環境 {N}%(Day 17)
- 腳本:{檔名 @ git 版本},負載:{stages 描述}(Day 12)
- 資料:{已參數化 / 測試前綴 / 測後清理方式}(Day 9)
- 施壓端:CPU 峰值 {N}%,blocked p95 {N}ms;可信度四問:{全過 / 例外說明}(Day 19)
- 同時段環境使用者:{無 / 說明}(Day 6)
## 3. 主要發現(依業務影響排序)
1. {端點}:p95 {N}ms(門檻 {N}),第 {N} 分鐘 {N} VU 起爬升 {曲線描述}〔推論:可能原因〕
2. ...
## 4. 風險與限制
- 環境為半規格,絕對值不代表正式環境;本報告只做改版前後相對比較
- 未涵蓋:{soak / 瀏覽器端 / 其他}
## 5. 建議
| 建議 | 預期效果 | 負責 | 預估工時 | 可行性(已與 RD 確認?) |
## 附錄
- 執行指令、summary 原文、report.html 連結、raw.json 存放位置
```


 iThome鐵人賽
 看影片追技術